

Benchmark
5 min
Cartesia Managed Agents lidera Speech Agent Arena
Cartesia Managed Agents marcou 1.115 Elo e 91,7% de sucesso na Speech Agent Arena; veja o que cada métrica mede e o que o placar não prova.
#Cartesia#Managed Agents#Speech Agent Arena
Testes práticos de performance, consumo e precisão entre agentes de IA
Cartesia Managed Agents marcou 1.115 Elo e 91,7% de sucesso na Speech Agent Arena; veja o que cada métrica mede e o que o placar não prova.

O Index v5 combina nove avaliações; 60% do peso vem de testes privados ou respostas retidas, dividido igualmente em quatro áreas.

MAI Image 2.7 ficou em 3º na Arena e 2º na Artificial Analysis; o anúncio destaca avanços em edição de cena, texto e restauração.

GenXR-Bench reúne 112 tarefas XR. No paper v2, Claude Opus 5 alcançou 50,9% de Pass@1, com 29,2% em tarefas de recursos do SDK.
O Code2Video-AA avaliou 27 modelos em 114 briefs; veja o leaderboard, a taxa de renderização e os limites do benchmark.
Cursor liberou o DeepSeek V4.1 Flash 1017; no CursorBench 4.0, o modo Max marcou 47,7% a custo médio de US$ 0,98 por tarefa.

O cartão atualizado em 25 de outubro compara quatro modelos em testes de agentes, com resultados próprios da equipe Nanbeige e limites na avaliação.
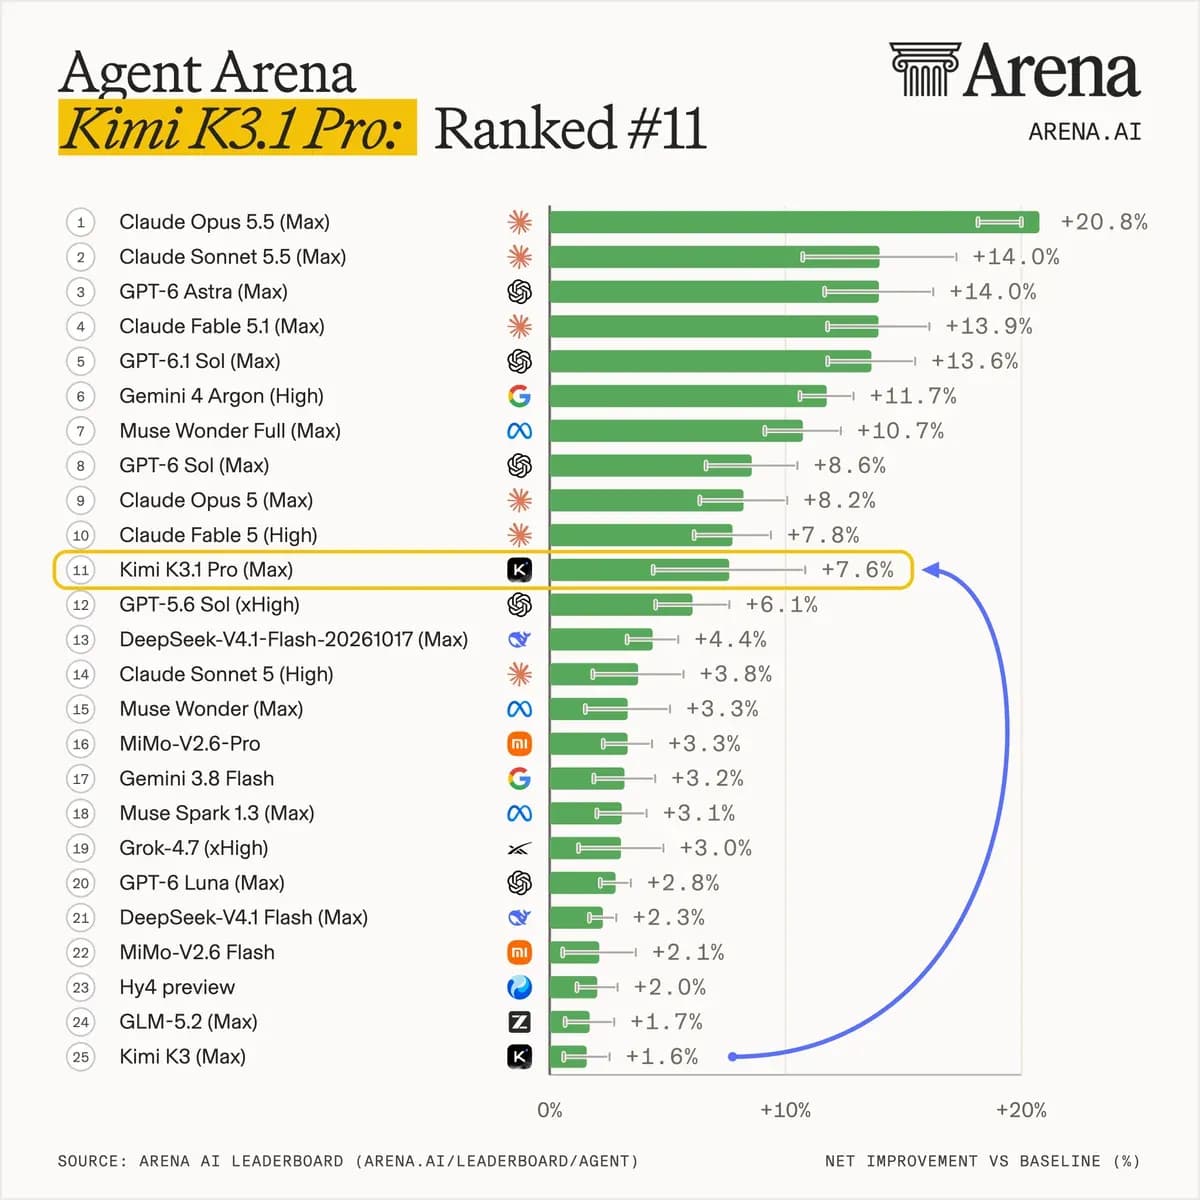
A Arena incluiu o Kimi K3.1 Pro na Agent Arena em 24 de outubro. O gráfico mostra o modelo em 11º, com +7,6% contra a linha de base.
A Moonshot relata 65,7% para o Kimi K3.1 Pro no Terminal-Bench 4.0, perto do Claude Opus 5.5, em teste divulgado pela própria empresa.

No ThinkingBox-Bench com 507 tarefas, o ajuste do Qwen3.8-27B elevou de 38 para 107 as tarefas aprovadas em todas as 20 tentativas.
Teste da CoreWeave publicado pela NVIDIA reporta inicialização de sandbox acima de 3x e loops de agentes 1,8x mais rápidos com Vera frente a x86.
Curadoria técnica e aprofundada: arquiteturas agênticas, benchmarks reais de tokens, servidores MCP e ferramentas open source direto no seu e-mail e no blog.