
Em 27 de outubro de 2026, às 23h11 em Brasília, a Artificial Analysis anunciou a versão v5 do Intelligence Index. A mudança atualiza o ranking e altera quanto cada grupo de avaliações influencia a pontuação composta.

Artificial Analysis Intelligence Index v5: o que muda
O Index v5 combina nove avaliações; 60% do peso vem de testes privados ou respostas retidas, dividido igualmente em quatro áreas.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
A publicação informa que 60% do índice agora se baseia em testes privados ou respostas retidas. Isso reduz a exposição pública das perguntas, mas também muda como leitores devem interpretar a comparabilidade e a reprodução dos resultados.
A empresa apresenta a v5 como duas novas avaliações e três atualizações. A Progress Index v1 é uma escala separada e não entra nessa pontuação composta.
O Index v5 divide nove avaliações em quatro áreas
O Artificial Analysis Intelligence Index é uma medida composta de capacidade dos modelos em tarefas que a empresa considera próximas do uso atual.
A versão v5 distribui o peso igualmente entre trabalho de conhecimento, programação, ciência e capacidade geral.
Cada área representa 25% do índice. No trabalho de conhecimento, AA-Briefcase responde por 15%, AutomationBench-AA por 5% e GDP.pdf por 5%.
A programação também recebe 25%: FrontierCode 2.0 pesa 15% e Terminal-Bench 4.0 pesa 10%. Ciência soma outros 25%, com Terminal-Bench Science em 15% e o subconjunto difícil de CritPt v2 em 10%.
A área geral completa o quadro. AA-Omniscience v1.1 representa 15% e HLE-Diamond, 10%.
A ficha completa e as mudanças da metodologia estão no anúncio oficial do Index v5.
HLE-Diamond substitui Humanity's Last Exam no índice. A Artificial Analysis descreve a nova versão como um conjunto refinado de mil perguntas, dividido igualmente entre raciocínio e conhecimento.
Na prática editorial, a pontuação total não equivale a um resultado de programação. Mesmo com testes de código entre as nove avaliações, três quartos do peso vêm de outras áreas.
Por isso, compare a área mais próxima da tarefa.
Nosso Code2Video-AA avaliou 27 modelos em briefs de vídeo feitos com código, um exemplo mais específico que uma pontuação geral.
FrontierCode 2.0 mede alterações que um mantenedor aceitaria
FrontierCode 2.0 usa 132 tarefas em repositórios reais de código aberto. A avaliação considera se um mantenedor aceitaria a alteração feita pelo agente, e uma falha em qualquer verificação bloqueadora zera a tentativa.
A Cognition mantém privadas as tarefas para reduzir contaminação, quando um modelo pode ter visto exemplos de avaliação durante o treinamento. Cada tarefa é executada três vezes no harness Stirrup, segundo a Artificial Analysis.
No placar publicado com v5, Claude Opus 5.5 no esforço máximo lidera FrontierCode 2.0 com 46%. GPT-6 Astra, GPT-6.1 Terra e Claude Sonnet 5.5 aparecem em seguida com 42% cada.
O melhor resultado de pesos abertos na tabela citada é 28% para DeepSeek V4.1 Flash 1017 no modo máximo. A diferença importa para equipes de desenvolvimento, mas não diz sozinha se uma alteração é segura ou adequada ao seu repositório.
Outra avaliação nova, Terminal-Bench Science, contém 70 tarefas de pesquisa científica em ambiente de terminal. Para passar uma tarefa, o agente precisa satisfazer todos os testes associados.
GPT-6 Astra aparece com 63%, Claude Opus 5.5 com 59% e GPT-6.1 Sol com 58%. Já o melhor modelo com pesos publicados marca 13% nessa prova, o que evidencia uma lacuna dentro dessa tarefa específica.
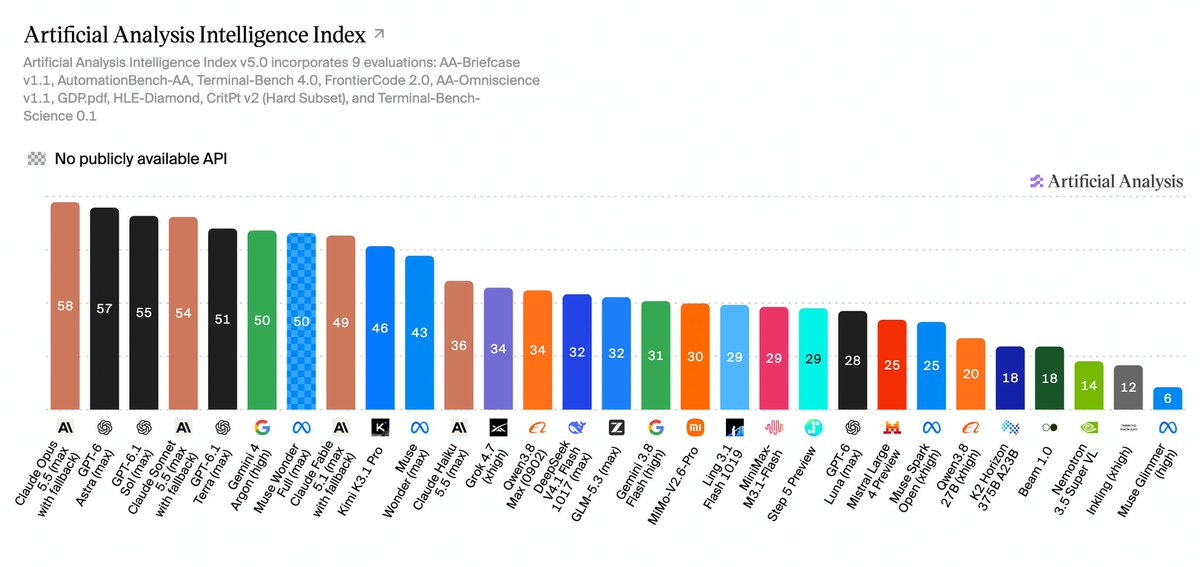
O gráfico mostra a pontuação agregada, não a porcentagem de tarefas concluídas.
Para ver uma avaliação mais estreita, leia nosso artigo sobre o GenXR-Bench e tarefas de programação para realidade estendida.
O resultado composto não aponta um vencedor em todas as provas
O ranking de v5 mostra Claude Opus 5.5 na liderança geral com 58 pontos, seguido por GPT-6 Astra com 57 e GPT-6.1 Sol com 55. Esses valores são pontos da escala composta, não porcentagens.
A própria Artificial Analysis afirma que nenhum modelo lidera as nove avaliações. Claude Opus 5.5 fica na frente em três, enquanto cinco outros modelos lideram as seis restantes.
Isso importa para quem escolhe um modelo por uma única tabela. Um primeiro lugar geral não garante que o mesmo sistema será o melhor para corrigir código, pesquisar em terminal ou revisar documentos longos.
A versão v5 retira GDPval-AA v2.1, SciCode e AA-LCR v1.1 do índice. A empresa atualizou AA-Omniscience para remover perguntas públicas ou saturadas, acrescentar questões e revisar itens ambíguos ou incorretos.
Os dados privados reduzem exposição, mas exigem leitura da metodologia
A Artificial Analysis informa que 60% do peso de v5 vem de avaliações com conjuntos de teste privados ou respostas retidas. Isso procura reduzir a chance de um modelo já conhecer as perguntas e parecer melhor por memorização.
Uma avaliação privada não pode ser reproduzida integralmente por qualquer leitor.
Para comparar resultados, consulte as regras publicadas, os critérios de aprovação, o número de tentativas e as limitações descritas para cada teste.
A v5 também lança a Artificial Analysis Progress Index v1, uma escala contínua que acompanha modelos desde novembro de 2022. Ela é um produto separado do Intelligence Index e não deve ser confundida com a pontuação de v5.
Preguntas frecuentes sobre o Artificial Analysis Intelligence Index v5
O que é o Artificial Analysis Intelligence Index v5?
É uma pontuação composta de nove avaliações, com peso igual para trabalho de conhecimento, programação, ciência e capacidade geral.
O que mudou no Index v5?
A v5 acrescenta duas avaliações e três atualizações. Entre os testes destacados estão FrontierCode 2.0 e Terminal-Bench Science.
O que significa dizer que 60% do índice usa testes privados?
Sessenta por cento do peso vem de avaliações com testes privados ou respostas retidas. Isso reduz a exposição pública das perguntas, mas limita a reprodução completa por leitores externos.
O Index v5 mede apenas programação?
Não. A programação representa 25% do índice; as outras áreas cobrem trabalho de conhecimento, ciência e capacidade geral.
Progress Index v1 é o mesmo ranking do Index v5?
Não. Progress Index v1 é uma escala separada que acompanha modelos em uma faixa contínua; não é a mesma pontuação composta do Intelligence Index v5.
O Index v5 ajuda a filtrar modelos, não a escolher sozinho
A versão atual torna mais visível a diferença entre código, ciência, conhecimento aplicado e capacidade geral. Para um projeto real, o índice serve para restringir candidatos, enquanto testes no próprio fluxo continuam necessários.
Comece pelo peso da tarefa relevante, leia como o benchmark verifica o resultado e confira se a versão avaliada corresponde ao modelo disponível hoje. Assim, a pontuação vira um sinal de triagem, não uma promessa de desempenho universal.
Em vez de só acompanhar rankings como o Intelligence Index v5, coloque a IA para trabalhar por você no bridgecode.
Fonte: Artificial Analysis
Tags:#Artificial Analysis#Intelligence Index v5#benchmarks#FrontierCode 2.0#Terminal-Bench Science
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Benchmarks
Inkling 2 Small solta 316 palavrões em benchmarks: o que isso revela
Inkling 2 Small soltou 316 palavrões em 2.655 execuções de benchmark. O que isso revela sobre loops de raciocínio e sobre leitura de benchmarks.
6 min
Benchmarks
Co-Design Bench: agentes de código acertam 26% das tarefas reais
Pesquisadores criaram um benchmark de agentes de código baseado em pedidos reais de usuários. Mesmo o melhor modelo completa apenas 26,4% das tarefas. Veja os números.
7 min

Benchmarks
Construction AI Leaderboard: Claude Opus 5.5 lidera em 5 eixos
ONESTRUCTION publicou em 7 de novembro de 2026 um ranking de 20 modelos de IA em cinco eixos de trabalho real de construção. Claude Opus 5.5 liderou com 73,7 pontos.
6 min