
Em 25 de outubro de 2026, Nanbeige atualizou o cartão do Nanbeige4.3-33B. A revisão mais recente, às 11:11 UTC, está no histórico oficial e inclui benchmarks de código, agentes e raciocínio.

Nanbeige4.3-33B: resultados em benchmarks de agentes
O cartão atualizado em 25 de outubro compara quatro modelos em testes de agentes, com resultados próprios da equipe Nanbeige e limites na avaliação.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
Os números são uma avaliação da própria equipe. O cartão compara quatro modelos e informa o mesmo harness e os mesmos hiperparâmetros para cada teste, com o maior nível de raciocínio.
O que a equipe Nanbeige comparou
Os quatro modelos são Nanbeige4.3-33B, Qwen3.8-27B, Muse-Glimmer-30B e Gemma4-31B, todos na faixa próxima de 30 bilhões de parâmetros, segundo o cartão do modelo.
Benchmark é uma avaliação com tarefas e critérios definidos. O harness reúne as instruções, ferramentas e regras usadas para executar os testes.
A equipe afirma que usou os mesmos hiperparâmetros e o mesmo harness por benchmark e que testou todos os modelos no maior nível de raciocínio. A tabela é um recorte da avaliação da equipe, não um ranking global de todos os modelos.
Resultados do Nanbeige4.3-33B em testes de agentes
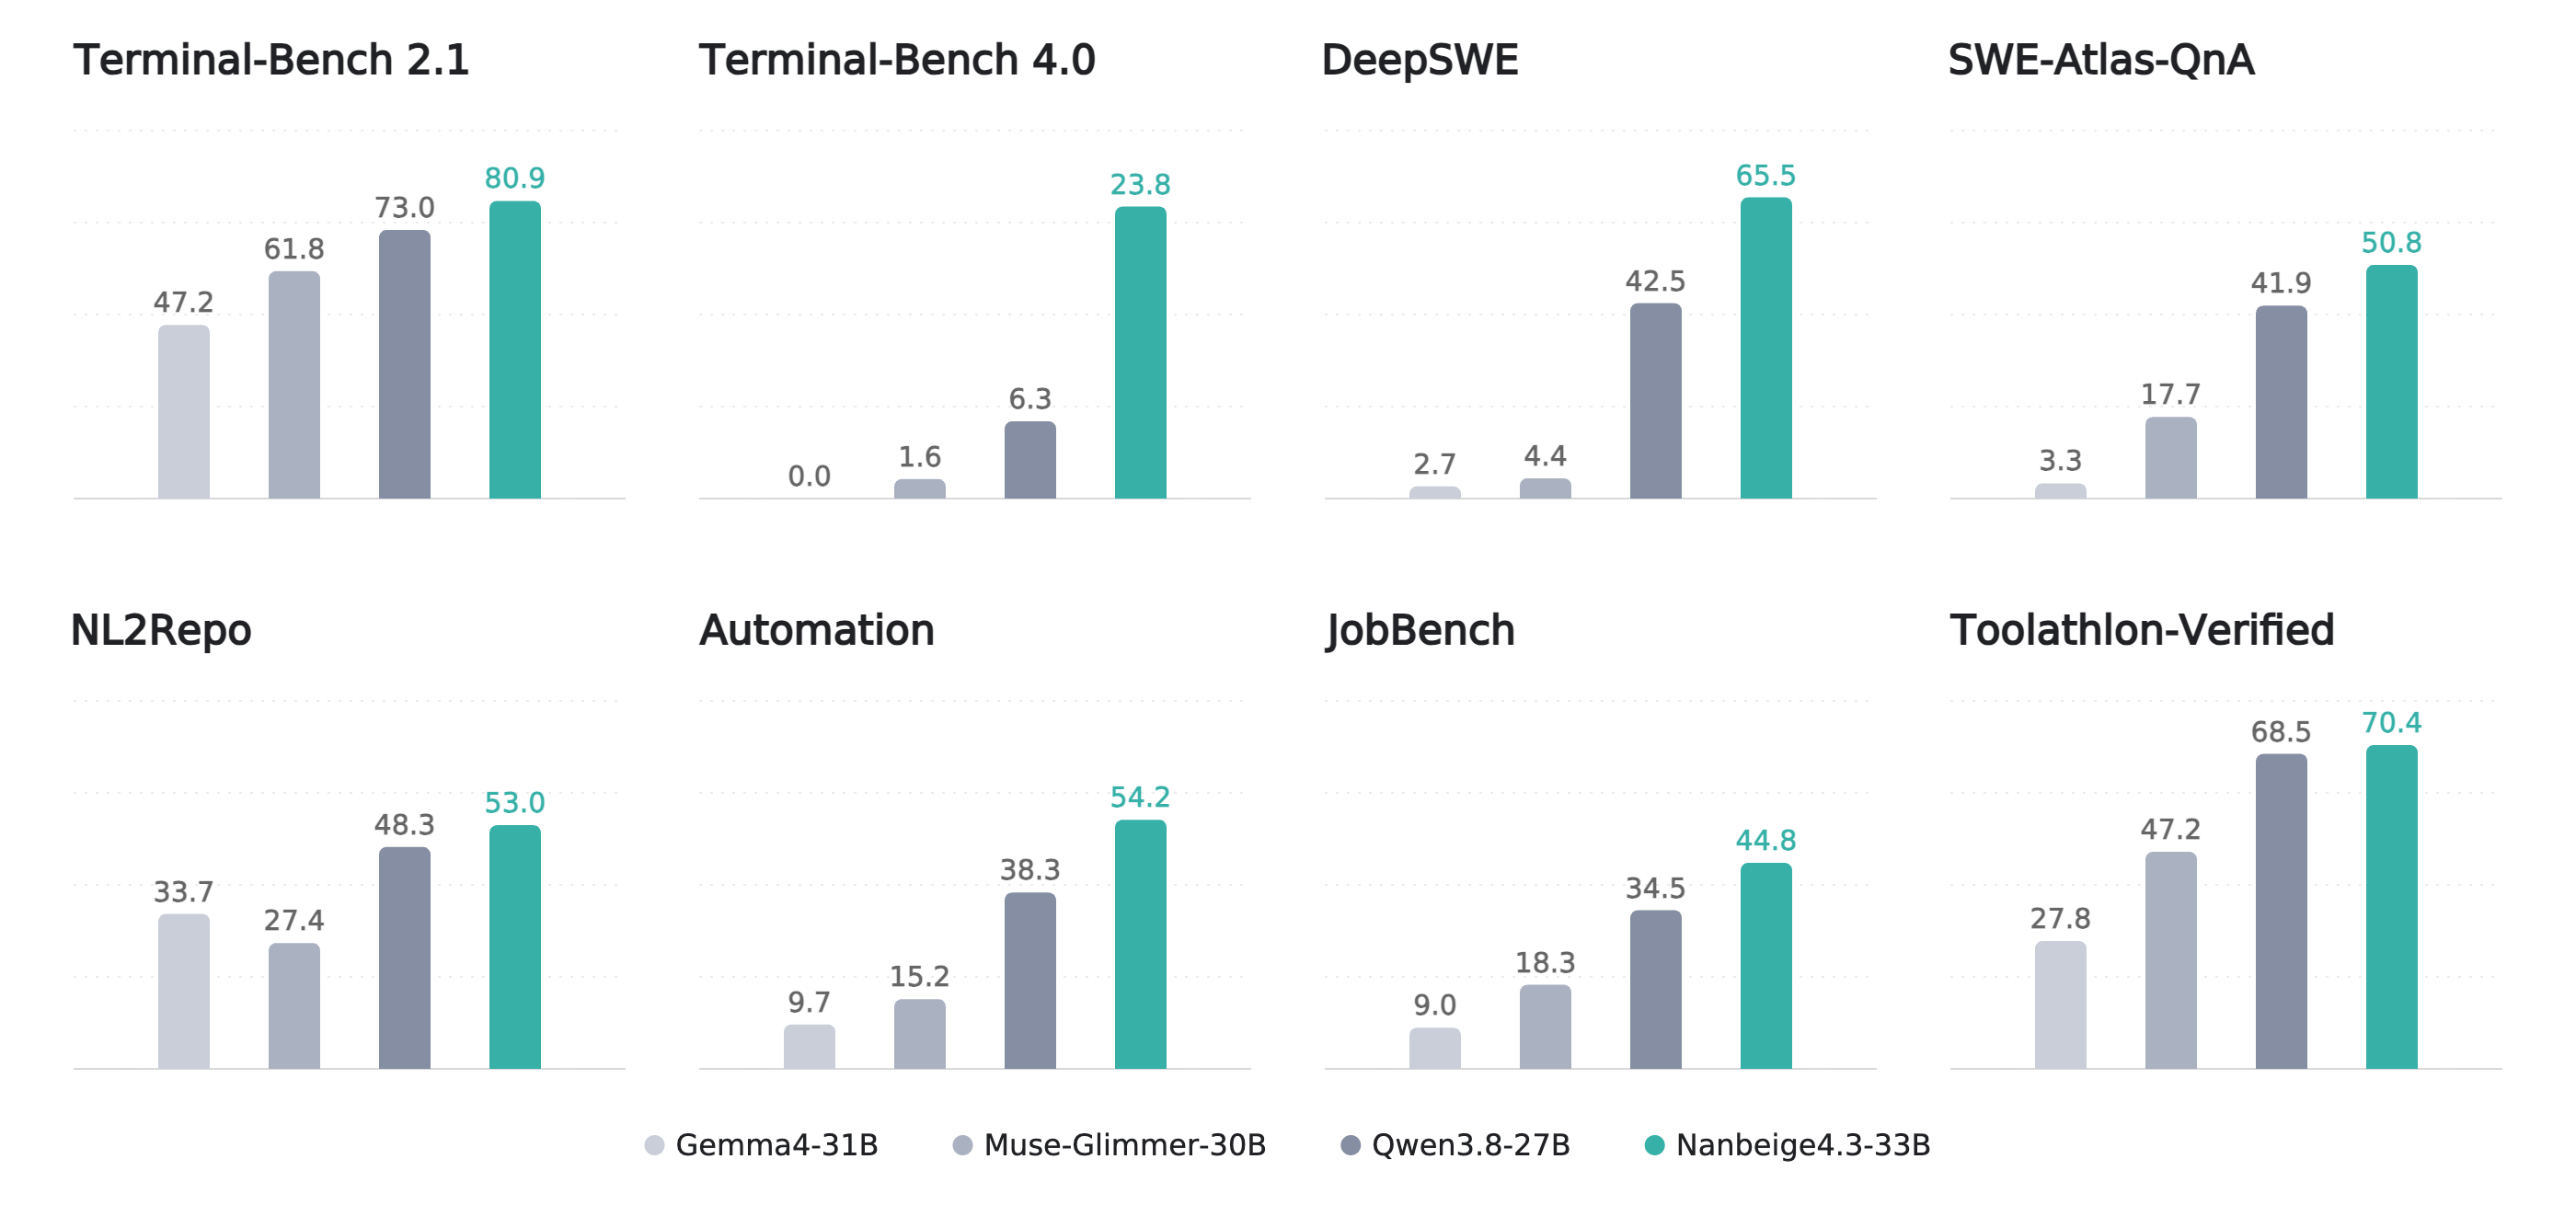
Crédito: Nanbeige no Hugging Face.
O gráfico e a tabela do cartão divergem em dois valores. Para evitar escolher um dado sem confirmação, a tabela abaixo traz seis testes em que as duas partes coincidem.
| Benchmark | Nanbeige4.3-33B | Qwen3.8-27B | Muse-Glimmer-30B | Gemma4-31B |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 80.9 | 73.0 | 61.8 | 47.2 |
| Terminal-Bench 4.0 | 23.8 | 6.3 | 1.6 | 0.0 |
| DeepSWE | 65.5 | 42.5 | 4.4 | 2.7 |
| SWE-Atlas-QnA | 50.8 | 41.9 | 17.7 | 3.3 |
| Automation Bench | 54.2 | 38.3 | 15.2 | 9.7 |
| Toolathlon-Verified | 70.4 | 68.5 | 47.2 | 27.8 |
No mesmo cartão, o valor de Gemma4-31B no NL2Repo aparece como 33.7 no gráfico e 33.8 na tabela. Para Muse-Glimmer-30B no JobBench, o gráfico mostra 18.3 e a tabela 16.6.
A documentação informa que Terminal-Bench 2.1 usa Terminus 2. Já Terminal-Bench 4.0 e DeepSWE usam mini-swe-agent v2.4.6. O setup faz parte da leitura dos resultados.
Para ver outros testes, compare o resultado do Kimi K3.1 Pro no Terminal-Bench 4.0 e a avaliação do Qwen3.8-27B no ThinkingBox-Bench.
O que os resultados do Nanbeige4.3-33B não provam
Os números vêm da avaliação publicada pela própria equipe Nanbeige e cobrem quatro modelos escolhidos para essa comparação. Eles não substituem uma validação independente nem mostram qual modelo será melhor em toda tarefa de programação.
Os resultados servem como sinal para testes próprios. Antes de escolher, confira a versão, as instruções, as ferramentas e o harness usados em cada benchmark.
Preguntas frecuentes sobre os resultados do Nanbeige4.3-33B
Quais modelos foram comparados no cartão do Nanbeige4.3-33B?
A equipe comparou Nanbeige4.3-33B, Qwen3.8-27B, Muse-Glimmer-30B e Gemma4-31B em benchmarks de código, agentes e raciocínio.
Qual foi o resultado do Nanbeige4.3-33B no Terminal-Bench 4.0?
O cartão informa 23.8 para Nanbeige4.3-33B, contra 6.3 para Qwen3.8-27B, 1.6 para Muse-Glimmer-30B e 0.0 para Gemma4-31B. A equipe declara mini-swe-agent v2.4.6 para esse teste.
Os benchmarks do Nanbeige4.3-33B foram validados por terceiros?
O cartão apresenta uma avaliação feita pela equipe Nanbeige. A página não afirma que os resultados foram reproduzidos ou auditados de forma independente.
Por que o gráfico e a tabela do Nanbeige divergem?
O cartão mostra 33.7 no gráfico e 33.8 na tabela para Gemma4-31B no NL2Repo. Para Muse-Glimmer-30B no JobBench, mostra 18.3 no gráfico e 16.6 na tabela, sem explicar as diferenças.
Qual harness foi usado no Terminal-Bench 4.0?
Nanbeige declara mini-swe-agent v2.4.6 para Terminal-Bench 4.0 e DeepSWE. Para Terminal-Bench 2.1, declara o harness Terminus 2.
O que a comparação da Nanbeige permite concluir
A ficha reúne resultados de código, uso de ferramentas e outras tarefas de agentes. Também explicita diferenças de configuração entre testes.
As duas divergências entre o gráfico e a tabela reforçam a importância de conferir os dados antes de tirar uma conclusão.
Do rascunho ao produto pronto: divida o trabalho entre agentes especialistas e acompanhe cada etapa no bridgecode.
Fonte: Nanbeige no Hugging Face
Tags:#Nanbeige#Nanbeige4.3-33B#benchmarks#agentes de código#Terminal-Bench#modelos de IA
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados

Benchmarks
RoleRouteBench: o que o roteamento revela em multi-agentes
RoleRouteBench é um ambiente reproduzível para avaliar roteamento dinâmico de papéis em tarefas multi-etapa. Veja os resultados do JEV 1.13 nos quatro domínios.
6 min

Benchmarks
CloudOpsBench: agentes de IA em operações de nuvem
O CloudOpsBench mede como agentes de IA executam tarefas reais de operação em nuvem. O melhor agente resolve 60,6% das 45 tarefas na AWS. Veja os números.
7 min

Benchmarks
SuperCLUE novembro 2026: líderes diferentes por categoria
SuperCLUE publicou em novembro de 2026 a tabela com 19 modelos e líderes diferentes em cada categoria. O ranking dividido é mais útil como mapa de shortlist do que como veredito final.
6 min