
Em 27 de outubro, às 19h08 no horário de Brasília, a Artificial Analysis colocou Cartesia Managed Agents na primeira posição da Speech Agent Arena, com Elo 1.115. O post oficial também reporta Task Success Rate de 91,7%, contra 77,5% da Cartesia Line.

Cartesia Managed Agents lidera Speech Agent Arena
Cartesia Managed Agents marcou 1.115 Elo e 91,7% de sucesso na Speech Agent Arena; veja o que cada métrica mede e o que o placar não prova.

Marcelo Santiago
Criador do bridgecode
The biggest AI newsletter in the World
Get AI articles in your inbox
Technical curation on models, agents and coding tools. No spam, unsubscribe anytime.
A diferença importa porque o ranking mede duas coisas distintas: a preferência humana por uma conversa e a conclusão correta de uma tarefa com ferramenta. Veja o resultado publicado pela Artificial Analysis no X.
Como a Speech Agent Arena avalia agentes de voz
A Speech Agent Arena compara sistemas de fala para fala em conversas ao vivo. A Artificial Analysis explica que participantes humanos comparam dois sistemas ocultos no mesmo cenário e depois escolhem qual conversa preferiram.
A avaliação separa 15 cenários agênticos, que exigem chamada de ferramenta, de 20 cenários sem chamada de ferramenta. O conjunto inclui situações como pedir comida e perguntar sobre horário de funcionamento, segundo o artigo oficial de lançamento da Arena.
O voto de preferência alimenta uma pontuação Elo. Elo é uma escala relativa usada para ordenar participantes a partir de comparações, não uma porcentagem de acerto. Portanto, 1.115 Elo não significa 1.115 pontos percentuais nem que o agente conclui 1.115 tarefas.
Para os cenários agênticos, a Task Success Rate mede a proporção de conversas elegíveis em que o sistema concluiu a ação solicitada com a chamada de ferramenta correta. Casos com desvios do participante ou resultado não verificável ficam fora desse cálculo.
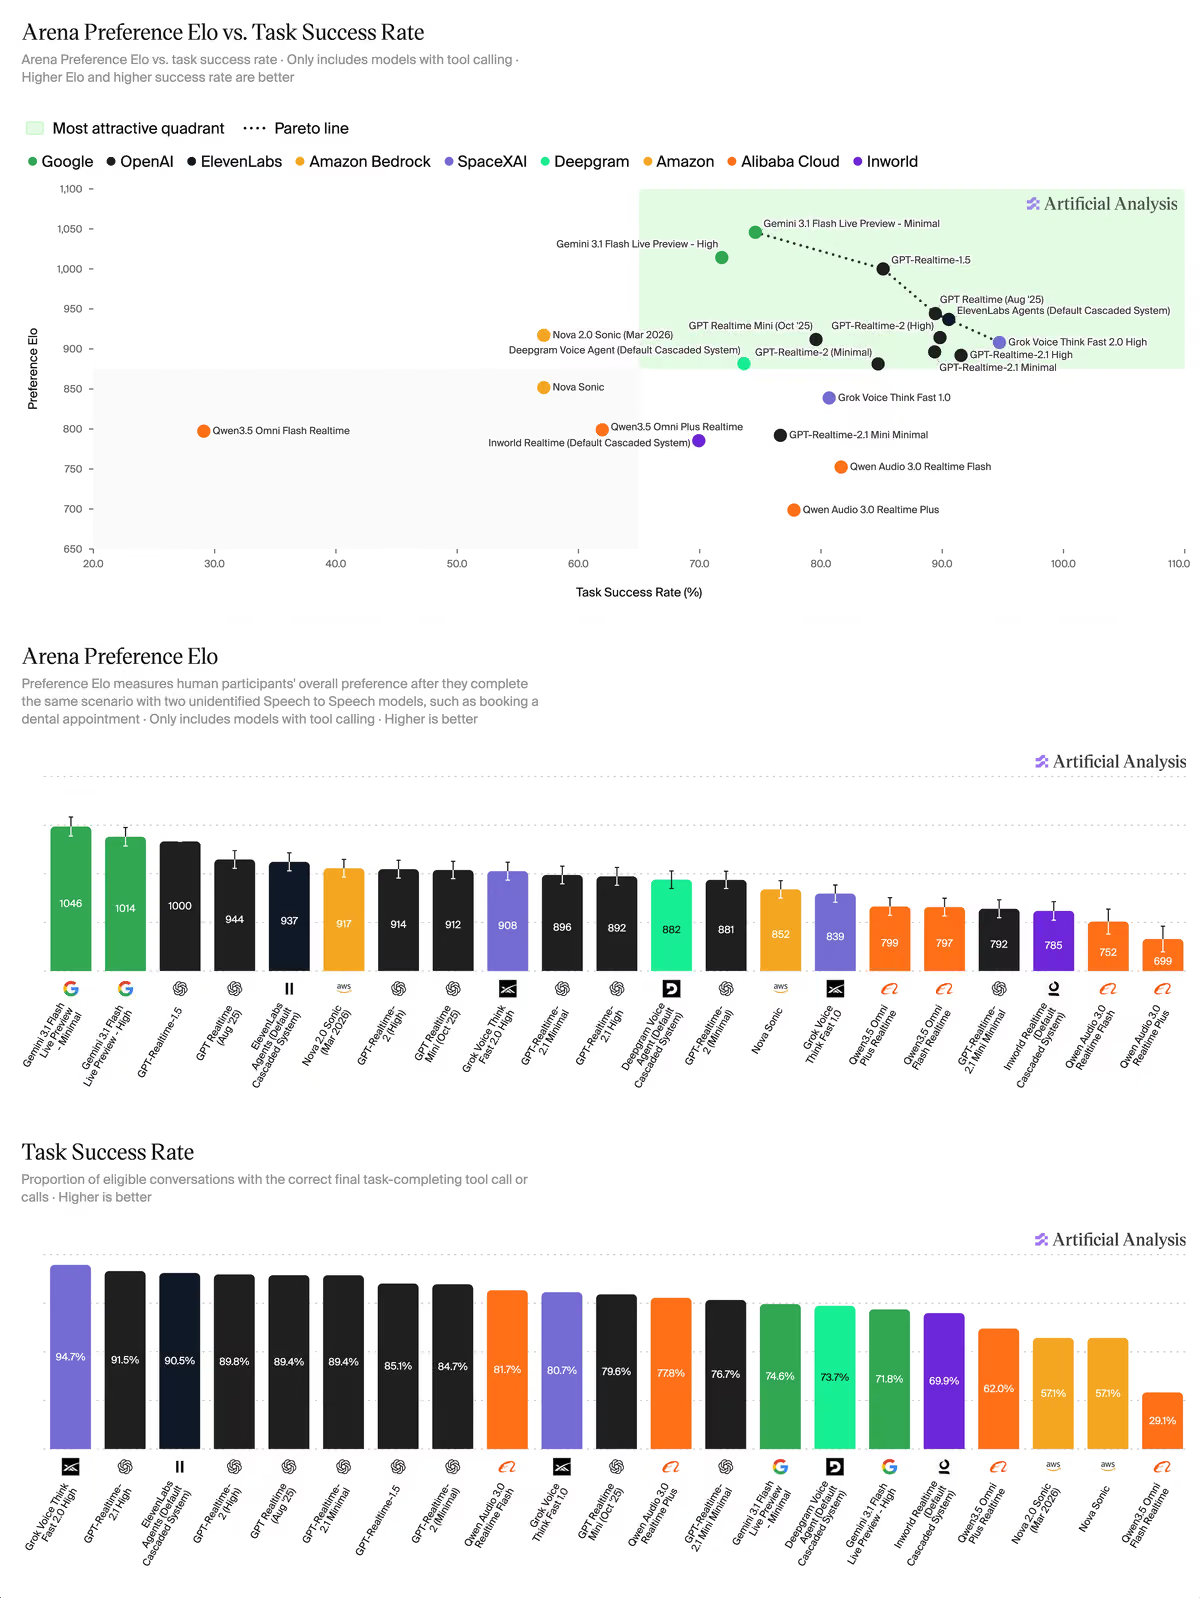
O gráfico de lançamento da Artificial Analysis coloca Elo no eixo vertical e sucesso em tarefas no horizontal. Ele ilustra por que um sistema pode soar convincente sem necessariamente completar a ação pedida.
Cartesia Managed Agents marcou Elo 1.115
No post de 27 de outubro, a Artificial Analysis reportou Elo 1.115 para Cartesia Managed Agents e disse que o resultado ficou 98 pontos acima da Cartesia Line, produto anterior de agente de voz da empresa.
O mesmo post informa Task Success Rate de 91,7% para Managed Agents, ante 77,5% para Cartesia Line. A publicação não apresenta nesse texto a pontuação Elo absoluta da Cartesia Line, então a comparação deve ficar restrita à diferença de 98 pontos divulgada pela Artificial Analysis.
| Medida | Cartesia Managed Agents | Cartesia Line |
|---|---|---|
| Elo de preferência | 1.115 | 98 pontos abaixo, segundo a Artificial Analysis |
| Task Success Rate | 91,7% | 77,5% |
Esses números são uma fotografia do ranking no momento do post, não uma garantia de que a posição permanecerá igual. A Arena pode mudar à medida que novos sistemas e conversas forem incluídos.
O resultado também se refere à configuração chamada Managed Agents. Não é correto transferi-lo automaticamente para toda voz sintetizada pela Cartesia ou para qualquer integração construída com seus modelos.
Elo e sucesso de tarefa respondem a perguntas diferentes
O Elo responde qual conversa os participantes preferiram em uma comparação direta. Essa percepção pode envolver naturalidade, ritmo, clareza e sensação de resposta adequada, embora a publicação não forneça uma decomposição detalhada da nota por atributo.
A Task Success Rate responde se a ação foi realmente finalizada pela chamada de ferramenta esperada. Um agente pode ter uma voz agradável, mas falhar ao reservar um horário, atualizar um registro ou concluir outra tarefa conectada a um sistema externo.
Para um produto de atendimento, essas métricas precisam ser vistas juntas. Se a experiência de fala for boa e a tarefa falhar, o usuário ainda não recebe o resultado que pediu. Se a tarefa for concluída, mas a conversa parecer truncada ou lenta, a experiência pode continuar ruim.
A Arena de fala para fala da Artificial Analysis também publica medidas de tempo até o primeiro áudio e outros resultados. Para entender como o benchmark organiza as avaliações, consulte o painel oficial da Speech Agent Arena.
O que a publicação não permite concluir
A Artificial Analysis informa que a maior parte dos prompts, esquemas de ferramentas e instruções dos cenários é privada para reduzir a adaptação excessiva aos testes. A exceção citada é um exemplo de agendamento odontológico.
A organização também diz que usa participantes terceirizados selecionados e pagos para conduzir e avaliar as interações. Isso descreve a coleta, mas não revela o tamanho de cada amostra, a distribuição de resultados por tarefa ou a variação entre participantes no post sobre Cartesia.
Por isso, o ranking é evidência útil de desempenho naquele conjunto, não prova de superioridade universal. Ele não demonstra, por si só, o comportamento em português, em ruído de fundo, com interrupções, em chamadas longas ou com ferramentas diferentes das avaliadas.
Também é importante confirmar a versão do ranking e a data do snapshot antes de comparar sistemas. A posição publicada pela Artificial Analysis é datada, e rankings de preferência podem mudar com novas avaliações.
Como usar o resultado ao escolher um agente de voz
Comece pelas tarefas reais do produto. Se o agente precisa concluir uma reserva, registrar um pedido ou consultar uma conta, priorize testes que validem a chamada final da ferramenta, além da qualidade da fala.
Depois, compare o resultado do benchmark com seu próprio fluxo. Verifique latência, recuperação de erros, interrupções, idioma, sotaque, privacidade e integração com as ferramentas necessárias. O post da Artificial Analysis não substitui um teste com os seus cenários e usuários.
Para quem está construindo um agente, o guia do Bridge Code sobre como criar agentes com o Cursor Agent SDK mostra como definir ferramentas e avaliar comportamento. E o artigo sobre mundos interativos com áudio nativo no Genie 4 ajuda a separar geração de áudio de uma conversa que precisa executar ações.
Frequently asked questions about Cartesia Managed Agents na Speech Agent Arena
O que é a Speech Agent Arena da Artificial Analysis?
A Speech Agent Arena compara sistemas de fala para fala em cenários reais, usando votos de preferência para calcular Elo e chamadas de ferramenta para calcular Task Success Rate.
O que significa o Elo 1.115 da Cartesia Managed Agents?
Elo 1.115 é uma pontuação relativa de preferência em comparações entre sistemas. Não é porcentagem de acerto nem número de tarefas concluídas.
Qual foi a Task Success Rate da Cartesia Managed Agents?
A Artificial Analysis reportou 91,7% para Cartesia Managed Agents e 77,5% para Cartesia Line. A métrica considera conversas elegíveis em que a ação foi concluída pela chamada de ferramenta correta.
Elo e Task Success Rate medem a mesma coisa?
Não. Elo mede preferência por uma conversa, enquanto Task Success Rate mede a conclusão correta de uma tarefa com ferramenta. Um agente pode obter boa avaliação conversacional sem completar a ação.
Os prompts da Speech Agent Arena são públicos?
Não. A Artificial Analysis informa que a maioria dos prompts, esquemas de ferramentas e instruções dos cenários é privada para reduzir adaptação excessiva ao benchmark.
Cartesia lidera este recorte, não todo cenário de voz
A Artificial Analysis publicou Cartesia Managed Agents com Elo 1.115 e Task Success Rate de 91,7% na Speech Agent Arena. É um resultado forte dentro desse benchmark e merece ser comparado com as tarefas que cada produto realmente precisa resolver.
O próximo passo para equipes de produto é testar as mesmas ações em condições reais e acompanhar as duas métricas separadamente. Preferência conversacional e conclusão correta de ferramenta são partes diferentes da experiência.
Do protótipo à entrega, divida o trabalho entre agentes especialistas e acompanhe cada etapa no bridgecode.
Fonte: Artificial Analysis
Tags:#Cartesia#Managed Agents#Speech Agent Arena#Artificial Analysis#agentes de voz#speech to speech#Task Success Rate
Developer and creator of bridgecode, an agentic development environment for orchestrating squads of AI agents. Helps people going from vibe coding to professional development move from idea to shipped product.
Related articles
Benchmarks
Inkling 2 Small solta 316 palavrões em benchmarks: o que isso revela
Inkling 2 Small soltou 316 palavrões em 2.655 execuções de benchmark. O que isso revela sobre loops de raciocínio e sobre leitura de benchmarks.
6 min
Benchmarks
Co-Design Bench: agentes de código acertam 26% das tarefas reais
Pesquisadores criaram um benchmark de agentes de código baseado em pedidos reais de usuários. Mesmo o melhor modelo completa apenas 26,4% das tarefas. Veja os números.
7 min

Benchmarks
Construction AI Leaderboard: Claude Opus 5.5 lidera em 5 eixos
ONESTRUCTION publicou em 7 de novembro de 2026 um ranking de 20 modelos de IA em cinco eixos de trabalho real de construção. Claude Opus 5.5 liderou com 73,7 pontos.
6 min