
CONFIRMADO · Arena.ai
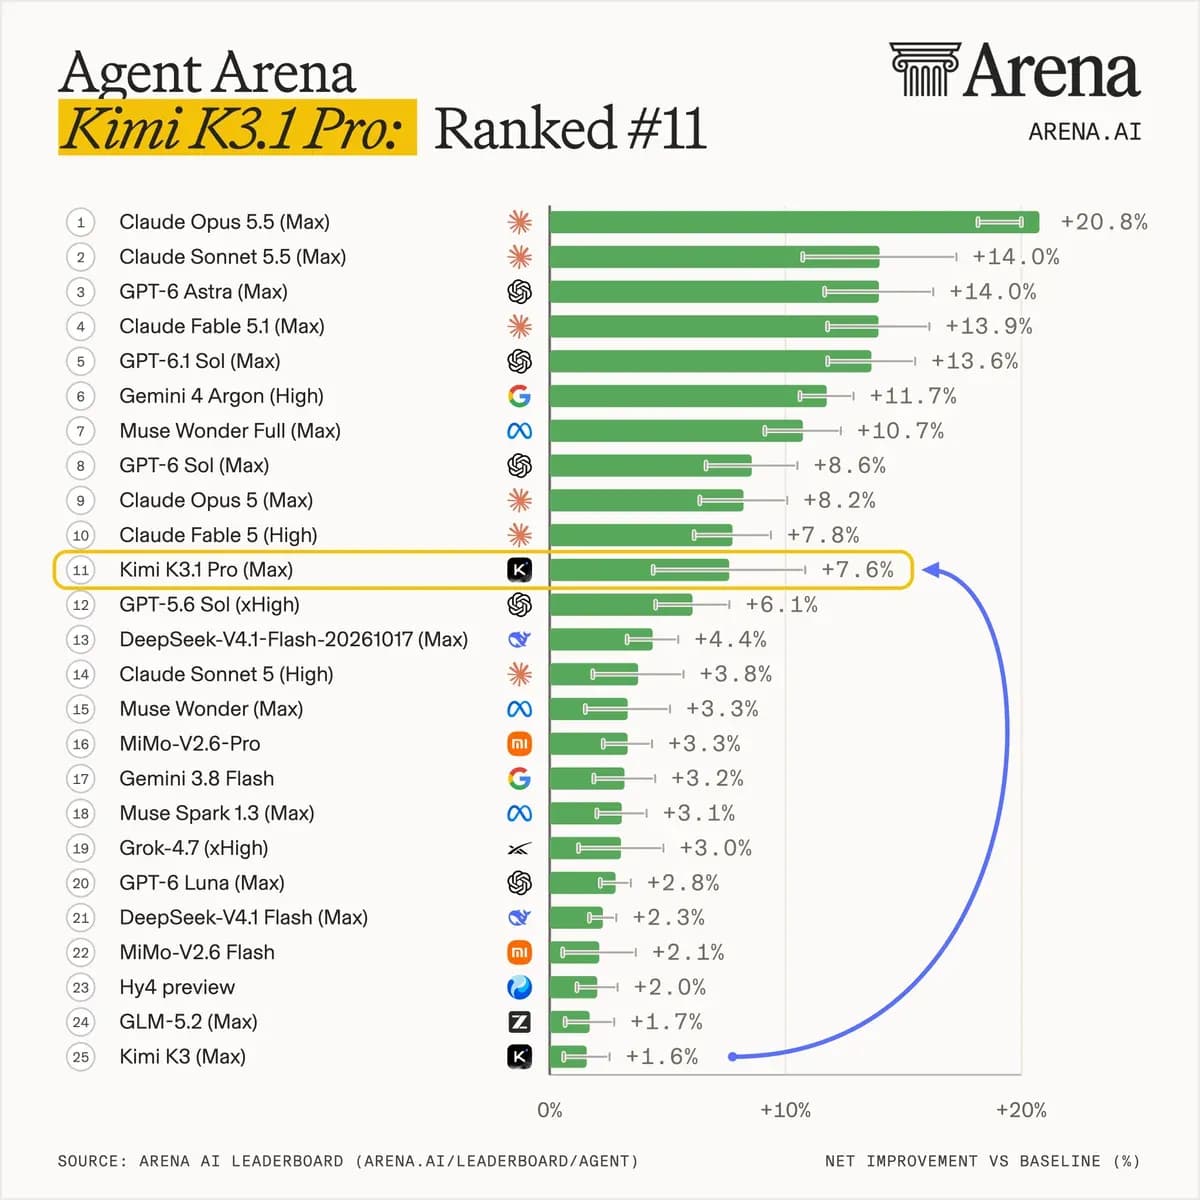
Kimi K3.1 Pro estreia na Agent Arena em 11º
A Arena incluiu o Kimi K3.1 Pro na Agent Arena em 24 de outubro. O gráfico mostra o modelo em 11º, com +7,6% contra a linha de base.

Marcelo Santiago
Criador do bridgecode
The biggest AI newsletter in the World
Get AI articles in your inbox
Technical curation on models, agents and coding tools. No spam, unsubscribe anytime.
Em 24 de outubro de 2026, às 11h57 de Brasília, a Arena adicionou o Kimi K3.1 Pro (Max) ao Agent Arena. Na divulgação, o modelo aparece em 11º lugar, com +7,6% de melhoria líquida sobre a linha de base.
A Arena diz que o resultado veio de mais de quatro mil sessões de agentes. A posição é um dado daquela avaliação, não uma promessa de que o modelo terá o mesmo desempenho em qualquer projeto. A atualização oficial de 24 de outubro confirma a inclusão.
O que é: uma nova entrada do Kimi na classificação da Arena.
O que não é: o lançamento de novos pesos nem um teste reproduzido pelo Bridgecode.
Kimi K3.1 Pro aparece em 11º na Agent Arena
O gráfico oficial coloca o Kimi K3.1 Pro (Max) em 11º lugar e indica +7,6% de melhoria líquida. A Arena também informa que a posição veio de mais de quatro mil sessões reais de agentes.
Imagem: Arena.ai.
No mesmo anúncio, a Arena compara o resultado com Kimi K3 (Max), que aparece em 25º lugar com +1,6%. A publicação descreve o K3.1 como uma melhora de seis pontos percentuais nessa métrica.
O que a melhoria líquida de 7,6% representa
A legenda do gráfico define a medida como melhoria líquida contra a linha de base. Ela não deve ser lida como uma taxa de acerto universal nem como porcentagem de tarefas concluídas.
A Arena também apresenta recortes por categoria: 8º lugar em Work, 9º em Code e 10º em Chat. Esses resultados descrevem os sinais da plataforma, não todos os usos possíveis do modelo.
Há uma ressalva de atualização: a página pública do placar consultada ainda mostra um rótulo de snapshot de 23 de outubro. Por isso, o 11º lugar deste texto é o resultado anunciado pela Arena em 24 de outubro, não uma garantia de que o ranking foi recalculado depois.
Agent Arena e Terminal Bench medem coisas diferentes
A Agent Arena agrega sessões de uso de agentes; o Terminal Bench avalia tarefas executadas no terminal. Os números vêm de métodos diferentes e não devem ser comparados como se fossem uma única escala.
Para ver outro resultado do mesmo modelo, leia o placar do Kimi em tarefas de terminal. Para um exemplo de avaliação de consistência, consulte o teste do ThinkingBox com outro modelo.
Frequently asked questions about o Kimi K3.1 Pro na Agent Arena
Qual foi a posição do Kimi K3.1 Pro na Agent Arena?
A Arena anunciou o Kimi K3.1 Pro (Max) em 11º lugar em 24 de outubro de 2026. A página pública consultada mantém essa posição, mas mostra um rótulo de snapshot de 23 de outubro.
O que significa a melhoria de 7,6%?
É a melhoria líquida contra a linha de base mostrada pela Arena. Não é uma taxa universal de tarefas concluídas nem uma pontuação reproduzida pelo Bridgecode.
Quantas sessões foram consideradas pela Arena?
A Arena diz que o resultado veio de mais de quatro mil sessões reais de agentes. A publicação não detalha o número de sessões por categoria.
O 11º lugar prova que o Kimi é o melhor modelo para programação?
Não. O número descreve o resultado na avaliação da Arena, que reúne sessões de agentes. A posição não garante o mesmo desempenho em todo código, tarefa ou configuração.
A posição do Kimi serve como sinal, não como veredito
O 11º lugar ajuda a decidir quais modelos vale testar, mas não substitui uma avaliação nas tarefas, ferramentas e critérios do seu próprio projeto. O rótulo de snapshot também merece atenção antes de tratar a posição como um placar atualizado ao vivo.
Kimi K3.1 Pro chamou sua atenção? Coloque o modelo para trabalhar num squad de agentes no bridgecode, com agentes dividindo planejamento, execução e revisão.
Fonte: Arena.ai
Tags:#Kimi K3.1 Pro#Agent Arena#Arena.ai#benchmarks#agentes de código
Developer and creator of bridgecode, an agentic development environment for orchestrating squads of AI agents. Helps people going from vibe coding to professional development move from idea to shipped product.
Related articles

Benchmarks
Modelos gratis e novos provedores da semana (06/11)
Kimi K3.1 Pro e ERNIE 5.5 chegaram com pesos públicos; Axion, Shackleton e ORO ampliaram o movimento open e de infraestrutura de agentes.
7 min

Benchmarks
RoleRouteBench: o que o roteamento revela em multi-agentes
RoleRouteBench é um ambiente reproduzível para avaliar roteamento dinâmico de papéis em tarefas multi-etapa. Veja os resultados do JEV 1.13 nos quatro domínios.
6 min

Benchmarks
CloudOpsBench: agentes de IA em operações de nuvem
O CloudOpsBench mede como agentes de IA executam tarefas reais de operação em nuvem. O melhor agente resolve 60,6% das 45 tarefas na AWS. Veja os números.
7 min