
A Vals AI publicou em 5 de novembro de 2026 uma nova rodada do ProgramBench, um benchmark que pergunta se modelos de IA conseguem reconstruir programas de linha de comando do zero. A resposta curta é: os melhores chegam a 18,5% de acerto, e a maioria fica bem abaixo disso.
Benchmark5 min
ProgramBench: IA reconstrói programas do zero?
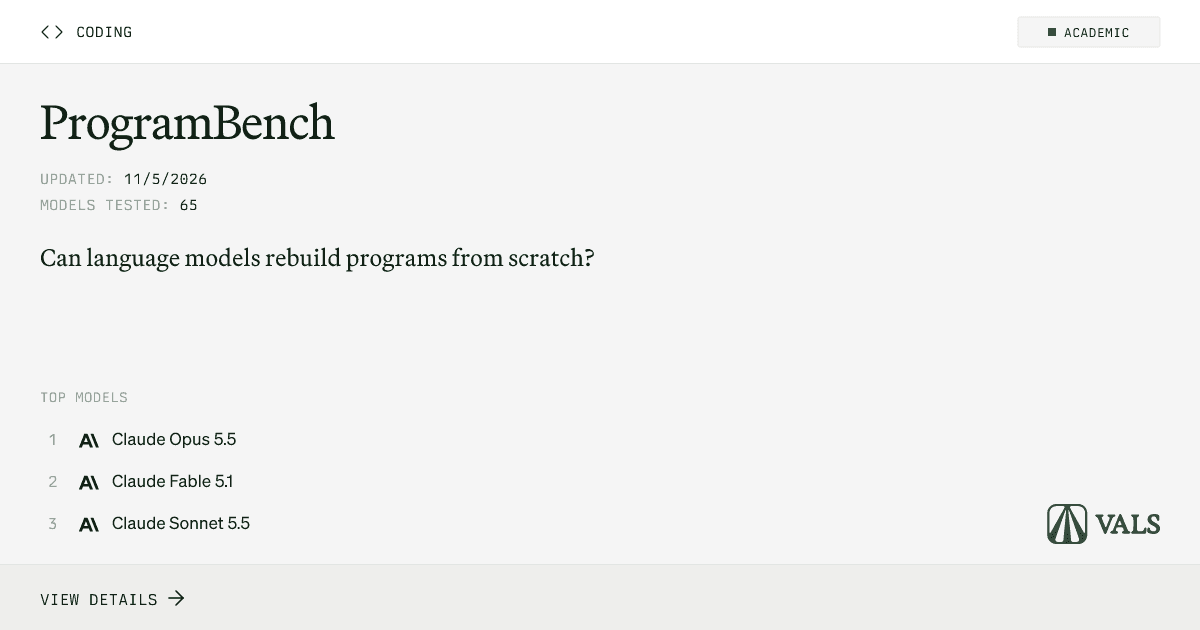
O ProgramBench testa se modelos de IA conseguem reconstruir programas de linha de comando a partir de um binário e uma especificação. Claude Opus 5.5 lidera com 18,50%.

Marcelo Santiago
Criador do bridgecode
A maior newsletter de IA do Mundo
Receba artigos sobre IA no seu e-mail
Curadoria técnica sobre modelos, agentes e ferramentas de código. Sem spam, cancele quando quiser.
O ProgramBench não testa se o modelo conhece o código-fonte. Ele entrega um binário compilado e uma especificação comportamental, e pede uma implementação limpa que compile e passe nos testes ocultos. É um teste de engenharia reversa com verificação programática, não de memória.
O que é o ProgramBench
ProgramBench é um benchmark de código que avalia se um modelo consegue reconstruir um programa de linha de comando a partir de um binário executável e uma especificação de comportamento. Cada tarefa entrega o binário compilado e a descrição do que o programa deve fazer. O modelo precisa produzir código-fonte que compile e reproduza o comportamento original nos testes ocultos.
A ideia é medir capacidade de engenharia, não recall. O modelo não tem acesso à internet, a repositórios de código ou a decompiladores. Ele pode inspecionar o binário e rodar o executável, mas não pode reutilizar o binário nem usar ferramentas de análise binária. O binário é apenas executável.
Isso diferencia o ProgramBench de benchmarks como o SWE-bench Pro, que parte de um repositório existente e pede um patch. Aqui não há código de partida: o modelo reconstrói do zero.
Como a avaliação funciona
A Vals AI avalia os modelos em 200 tarefas públicas do ProgramBench. Cada tarefa fornece um programa compilado e a especificação comportamental. O agente recebe um terminal bash, um sandbox offline e o prompt padrão do benchmark. Ele pode inspecionar os arquivos entregues e rodar o executável, mas não pode usar a internet, consultar registros de pacotes, envolver o binário fornecido, reutilizar arquivos objeto nem usar decompiladores, desassembladores, rastreamento ou instrumentação.
A submissão contém arquivos de código-fonte e um script de compilação. A Vals compila uma vez e avalia cada ramo de teste oculto em um contêiner novo criado a partir da imagem compilada. O agente tem até 1.000 passos, limite de 6 horas de relógio e 180 segundos de timeout por ação. A saída das ferramentas é truncada em 10.000 caracteres nas pontas.
Um ramo passa se o código compila, o comportamento reproduz o original e os testes ocultos passam. Não há crédito parcial por explicação: ou a implementação funciona, ou não.
O ranking oficial de 5 de novembro de 2026
A Vals testou 65 modelos no ProgramBench. Claude Opus 5.5 lidera com 18,50% de acerto, seguido por Claude Fable 5.1 com 7,00% e Claude Sonnet 5.5 com 6,50%. A maioria dos modelos fica abaixo de 5%.
| Posição | Modelo | Acerto |
|---|---|---|
| 1 | Claude Opus 5.5 | 18,50% |
| 2 | Claude Fable 5.1 | 7,00% |
| 3 | Claude Sonnet 5.5 | 6,50% |
A diferença entre o primeiro e o segundo é grande: mais de 11 pontos percentuais. Isso mostra que reconstruir um programa a partir do binário ainda é uma tarefa rara, mesmo para modelos de fronteira.
A Vals também compara modelos em custo e latência por tarefa. Claude Opus 5.5 custa mais por tentativa, mas é o único que chega perto de um em cada cinco programas corretos.
Por que esse benchmark importa
O ProgramBench mede uma capacidade que benchmarks de patch não capturam: a habilidade de entender o comportamento de um sistema sem código de partida. Isso é útil em três cenários reais.
Primeiro, engenharia reversa e auditoria: quando você recebe um binário de terceiros e precisa entender o que ele faz. Segundo, recuperação de sistemas legados sem código-fonte. Terceiro, validação de agentes de código que precisam atuar em ambientes onde não há repositório disponível.
O resultado de 18,5% também é um lembrete de limite. Mesmo o melhor modelo erra em mais de 80% dos casos. Para quem usa agentes de código no dia a dia, isso reforça a necessidade de revisão humana e testes, como discutido na análise do SnowPR em repositórios reais.
Perguntas frequentes sobre o ProgramBench
O que é o ProgramBench?
É um benchmark que avalia se modelos de IA conseguem reconstruir programas de linha de comando a partir de um binário compilado e uma especificação comportamental, produzindo código que compile e passe nos testes ocultos.
Qual modelo lidera o ProgramBench?
Em 5 de novembro de 2026, Claude Opus 5.5 liderava com 18,50%, seguido por Claude Fable 5.1 com 7,00% e Claude Sonnet 5.5 com 6,50%.
O ProgramBench parte de um repositório existente?
Não. O modelo recebe um binário e uma especificação, e deve produzir código do zero. Não há repositório de partida nem acesso à internet.
Quais são os limites de tempo e passos?
Cada agente tem até 1.000 passos, 6 horas de relógio e 180 segundos por ação. O código deve compilar e passar nos testes ocultos em contêineres novos.
Quantas tarefas tem o ProgramBench?
A Vals AI avalia 200 tarefas públicas. Cada tarefa pede a reconstrução de um programa de linha de comando a partir do binário e da especificação.
Conclusão: um benchmark de capacidade, não de memória
O ProgramBench é um dos poucos benchmarks que testa se o modelo entende software de verdade. Os números de 5 de novembro de 2026 mostram que reconstruir um programa a partir do binário é difícil mesmo para os modelos mais fortes. Acompanhe a leaderboard oficial para ver como os números mudam com novos modelos.
Um squad de agentes pode dividir análise, implementação e revisão, e é isso que você coordena no bridgecode.
Fonte: Vals AI
Tags:#benchmark#programbench#vals-ai#codigo#agentes
Desenvolvedor e criador do bridgecode, ambiente de desenvolvimento agêntico para orquestrar squads de agentes de IA. Ajuda quem vai do vibe coding ao desenvolvimento profissional a sair da ideia e chegar ao produto entregue.
Artigos relacionados
Benchmarks
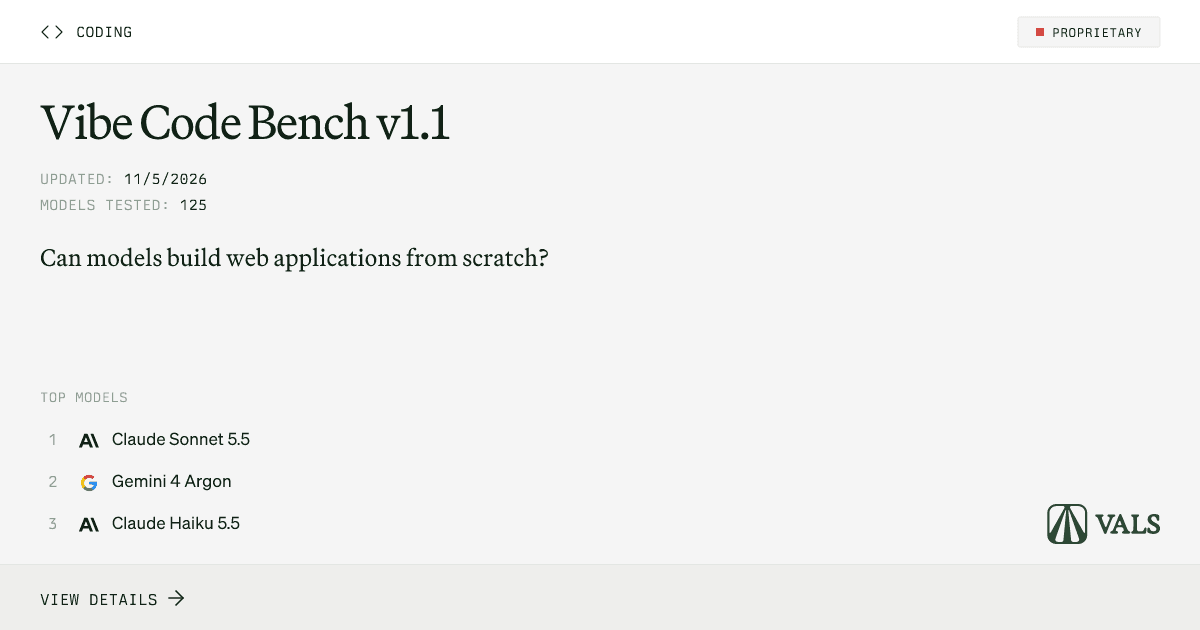
Vibe Code Bench: IA constrói app web do zero?
O Vibe Code Bench testa se modelos de IA conseguem construir aplicações web completas a partir de uma descrição. Claude Sonnet 5.5 no OpenHands lidera com 92,39%.
5 min
Benchmarks
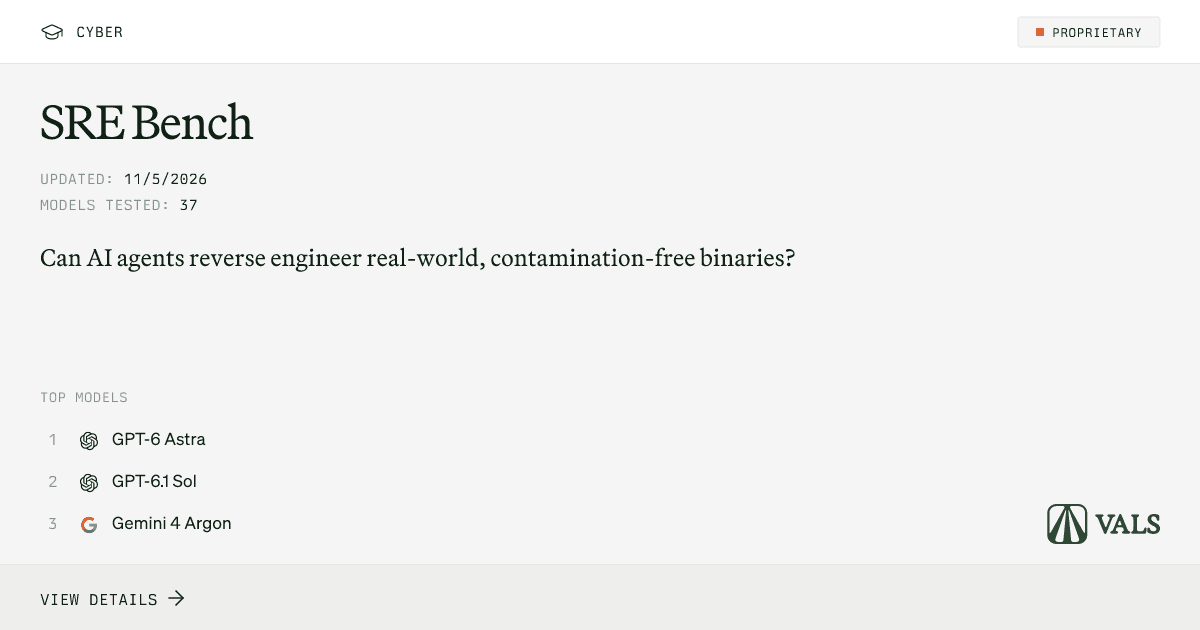
SRE Bench: IA faz engenharia reversa de binários?
O SRE Bench testa se agentes de IA conseguem fazer engenharia reversa de binários sem código-fonte. GPT-6 Astra lidera com 56,87%.
5 min
Benchmarks
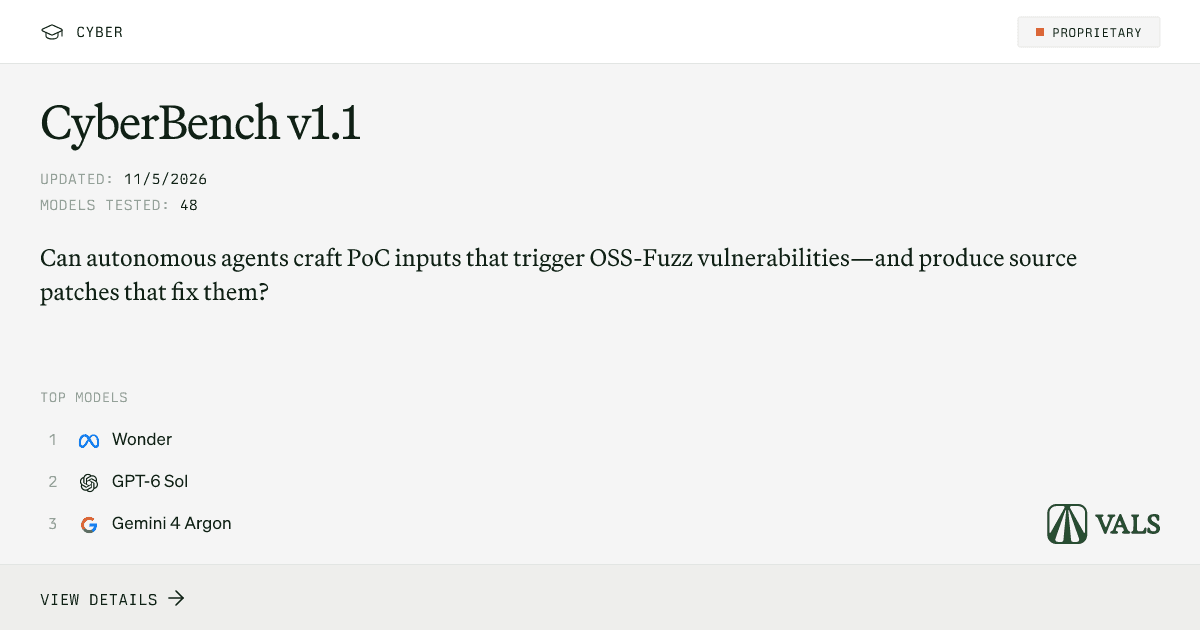
CyberBench: IA encontra bugs de segurança?
O CyberBench testa se agentes de IA conseguem encontrar falhas de segurança em código e produzir patches. Wonder, da Meta, lidera com 80,36%.
5 min