
SWE-bench Pro é o novo benchmark de código da Scale Labs que mede agentes de IA em tarefas reais de engenharia de software. Com 1.865 tarefas em 41 repositórios, ele mostra que mesmo os melhores agentes resolvem apenas uma fração do que o SWE-bench Verified sugeria. A página oficial foi atualizada em 9 de novembro de 2026.
Benchmark6 min
SWE-bench Pro: o benchmark de código que derruba agentes de IA
SWE-bench Pro traz 1.865 tarefas reais em 41 repositórios e mostra que agentes de código resolvem apenas uma fração do que benchmarks antigos sugeriam. Veja os números oficiais.

Marcelo Santiago
Criador do bridgecode
A maior newsletter de IA do Mundo
Receba artigos sobre IA no seu e-mail
Curadoria técnica sobre modelos, agentes e ferramentas de código. Sem spam, cancele quando quiser.
O que é o SWE-bench Pro
O SWE-bench Pro é um benchmark da Scale Labs (Scale AI) para avaliar agentes de IA em tarefas de engenharia de software. Ele foi criado para corrigir limitações dos testes anteriores: contaminação de dados, tarefas curtas e repositórios públicos já vistos no treinamento.
Cada tarefa pede ao agente que resolva um problema real em um repositório existente. O agente precisa ler código, editar arquivos, rodar testes e entregar uma correção que passe na suíte de testes escondida. A avaliação é binária: a tarefa é resolvida ou não.
O benchmark tem 1.865 tarefas distribuídas em 41 repositórios profissionais. As tarefas vão de correção de bugs a pedidos de funcionalidade, otimizações, atualizações de segurança e mudanças de interface.
Três subconjuntos com propósitos diferentes
O SWE-bench Pro se divide em três conjuntos.
O conjunto público tem 731 tarefas de repositórios de código aberto com licença copyleft, como GPL. A licença funciona como barreira legal contra contaminação: é improvável que esse código tenha entrado em corpora de treinamento proprietários.
O conjunto privado tem 276 tarefas de 18 codebases proprietárias de startups, obtidas por parceria. É o teste definitivo de generalização em código industrial que o modelo nunca viu.
O conjunto reservado (held-out) tem 858 tarefas de outro grupo de repositórios públicos com licença copyleft. Ele fica fora dos placares públicos e serve para análises futuras e avaliações internas.
Por que é mais difícil que o SWE-bench Verified
No SWE-bench Verified, os melhores modelos resolvem mais de 70% das tarefas. No SWE-bench Pro, os mesmos modelos caem para a casa dos 20%. O GPT-5 e o Claude Opus 4.1, por exemplo, marcam 23,3% e 23,1% no conjunto público.
A diferença vem do desenho. As tarefas do Pro exigem mudanças médias de 107 linhas em 4,1 arquivos. Algumas chegam a mais de 100 linhas em vários arquivos. Benchmarks antigos tinham correções pequenas e localizadas.
A licença copyleft também reduz contaminação. Se o código não estava no treinamento, o agente não pode recorrer a memorização.
Placar atual do conjunto público
O placar público atual tem 25 modelos. O líder é o Muse Spark 1.1, da Meta, com 61,5%. Em seguida aparecem o GPT-5.4 (xHigh) com 59,1%, o Muse Spark com 55%, o Claude Opus 4.6 (thinking) com 51,9% e o Gemini 3.1 Pro (thinking) com 46,1%.
Modelos mais antigos ficam bem atrás. O GPT-4o marca 1,51% e o Qwen3 32B marca 3,4%. A distância entre gerações é grande e consistente.
O conjunto privado é ainda mais duro. O Muse Spark 1.1 lidera com 51,5%, seguido pelo Claude Opus 4.6 (thinking) com 47,1%. O GPT-5 cai de 23,1% no público para 14,9% no privado.
O que derruba os modelos
Três padrões aparecem nos resultados oficiais.
Primeiro, o desempenho cai conforme a solução exige mais linhas e arquivos. Mudanças pequenas são resolvidas com mais frequência; mudanças grandes, quase nunca.
Segundo, a linguagem importa. Tarefas em Go e Python têm taxas de resolução mais altas, com alguns modelos acima de 30%. Em JavaScript e TypeScript, as taxas variam de quase 0% a mais de 30%, dependendo do modelo.
Terceiro, o repositório específico pesa. Alguns repositórios são consistentemente difíceis para todos os modelos, com taxas abaixo de 10%. Em outros, certos modelos passam de 50%. Fatores como complexidade do codebase, tipo de problema e qualidade da documentação afetam o resultado.
Os modelos de topo também são mais consistentes. Claude Opus 4.1 e GPT-5 não apenas pontuam mais alto, como mantêm desempenho estável entre linguagens e repositórios. Modelos menores têm desempenho errático.
Como testar hoje
O conjunto público e o código de avaliação estão disponíveis no GitHub (scaleapi/SWE-bench_Pro-os). O placar público está em labs.scale.com/leaderboard/swe_bench_pro. O conjunto privado tem placar separado.
Se você avalia agentes de código, compare sempre o mesmo harness (o programa que lê, escreve e executa código) entre modelos. O benchmark mede o par modelo mais ambiente, não o modelo isolado.
Para quem monta pipelines de agentes, o SWE-bench Pro é um bom termômetro de maturidade. Um agente que resolve menos de um quarto das tarefas reais ainda precisa de revisão humana em quase tudo.
Limites do benchmark
O SWE-bench Pro tem limites. Ele mede apenas se a correção passa nos testes escondidos. Não mede qualidade de código, legibilidade ou manutenibilidade.
A avaliação usa o scaffold SWE-Agent. Outros harnesses podem produzir resultados diferentes para o mesmo modelo.
O conjunto privado não é reproduzível fora da Scale, porque depende de codebases proprietárias. Isso torna o placar privado informativo, mas não verificável por terceiros.
Os resultados refletem o estado dos modelos na data de cada medição. Modelos novos entram no placar ao longo do tempo.
Perguntas frequentes sobre o SWE-bench Pro
O que é o SWE-bench Pro?
É um benchmark da Scale Labs para avaliar agentes de IA em tarefas reais de engenharia de software. Tem 1.865 tarefas em 41 repositórios e mede se o agente resolve o problema passando nos testes escondidos.
Por que o SWE-bench Pro é mais difícil que o SWE-bench Verified?
As tarefas exigem mudanças médias de 107 linhas em 4,1 arquivos, e o código usa licença copyleft, que reduz contaminação. Modelos que passam de 70% no Verified caem para cerca de 20% no Pro.
Quem lidera o placar público?
O Muse Spark 1.1, da Meta, com 61,5%. Em seguida vêm GPT-5.4 (xHigh) com 59,1%, Muse Spark com 55%, Claude Opus 4.6 (thinking) com 51,9% e Gemini 3.1 Pro (thinking) com 46,1%.
O que mais derruba os modelos?
Tarefas que exigem mais linhas e arquivos, linguagens como JavaScript e TypeScript, e repositórios específicos com alta complexidade. Modelos menores têm desempenho errático.
Como usar o benchmark na prática?
Compare sempre o mesmo harness entre modelos, porque o benchmark mede o par modelo mais ambiente. Use o conjunto público e o código de avaliação disponíveis no GitHub para testes próprios.
Conclusão
O SWE-bench Pro mostra que agentes de código ainda estão longe de resolver tarefas reais de engenharia de software de forma autônoma. O placar público deixa isso claro: mesmo o líder, o Muse Spark 1.1, resolve 61,5% das tarefas, enquanto modelos de geração anterior ficam abaixo de 25%.
Para quem escolhe ou constrói agentes de código, o recado é direto. Benchmarks saturados como o SWE-bench Verified não bastam mais. Teste em tarefas longas, em vários arquivos e em repositórios que o modelo não viu. E compare modelo e ambiente juntos, porque o harness importa tanto quanto o modelo.
Se você quer colocar agentes de código para trabalhar em projetos reais, comece com tarefas pequenas e revisão humana. À medida que o desempenho subir, amplie o escopo. O SWE-bench Pro é um bom ponto de partida para calibrar expectativas.
SWE-bench Pro chamou sua atenção? Coloque essa novidade pra trabalhar num squad de agentes de IA, cada um no seu papel.
Co-Design Bench: agentes de código acertam 26% das tarefas reais
7 dicas para avaliar benchmarks de agentes de IA
Fonte: Scale Labs
Tags:#radar#ia#benchmark
Desenvolvedor e criador do bridgecode, ambiente de desenvolvimento agêntico para orquestrar squads de agentes de IA. Ajuda quem vai do vibe coding ao desenvolvimento profissional a sair da ideia e chegar ao produto entregue.
Artigos relacionados
Benchmarks
Co-Design Bench: agentes de código acertam 26% das tarefas reais
Pesquisadores criaram um benchmark de agentes de código baseado em pedidos reais de usuários. Mesmo o melhor modelo completa apenas 26,4% das tarefas. Veja os números.
7 min
Benchmarks
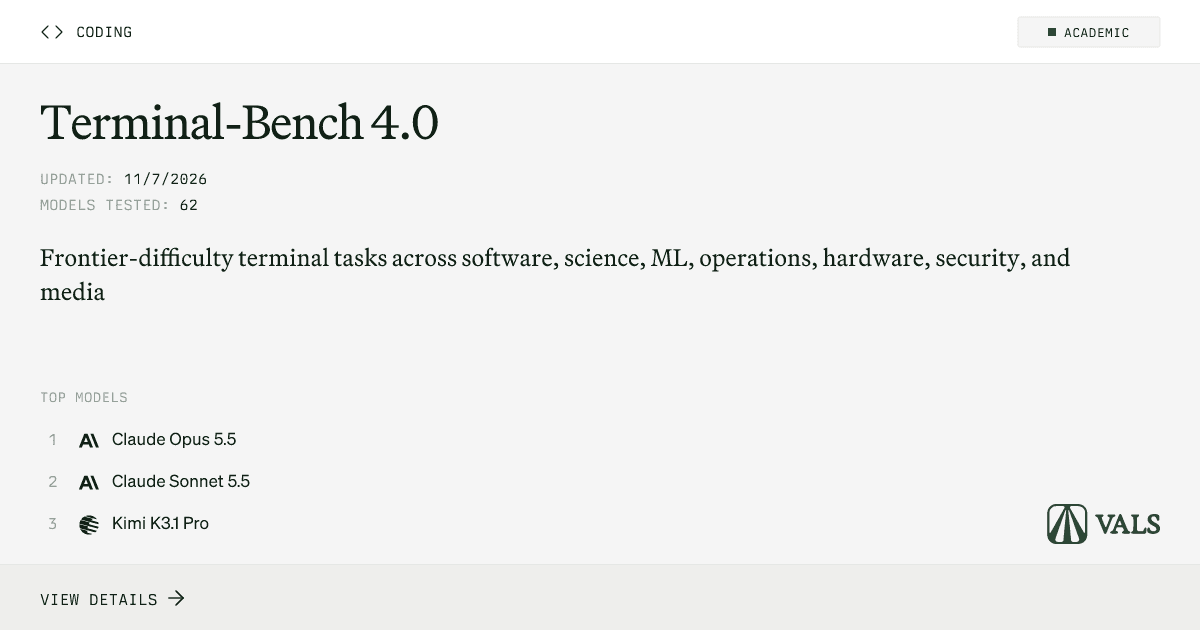
Terminal-Bench 4.0: Claude Opus 5.5 e Sonnet 5.5 lideram operações em terminal com 65%
O Terminal-Bench 4.0 avalia agentes de IA resolvendo problemas em terminal Linux real. Claude Opus 5.5 lidera com 65,15%, seguido por Sonnet 5.5 com 64,14%.
5 min
Benchmarks
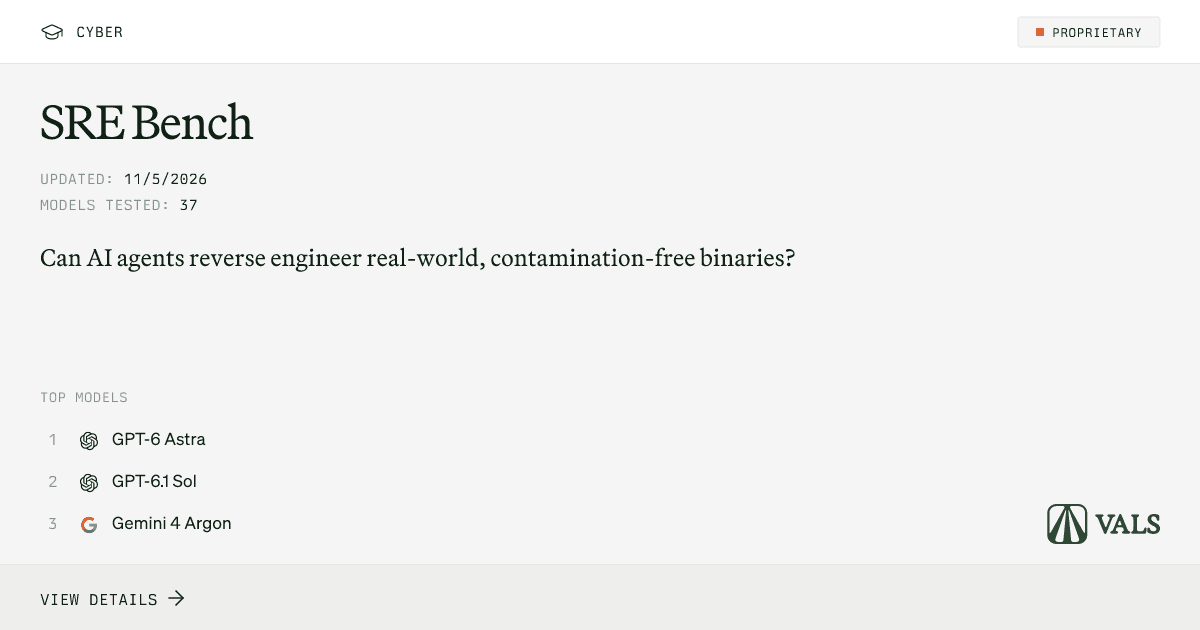
SRE Bench: IA faz engenharia reversa de binários?
O SRE Bench testa se agentes de IA conseguem fazer engenharia reversa de binários sem código-fonte. GPT-6 Astra lidera com 56,87%.
5 min