
Na publicação oficial de 27 de outubro de 2026, a Snowflake apresentou o SnowPR, um benchmark de agentes de programação baseado em tarefas reais de pull requests já integrados.

SnowPR mede agentes de código em repositório real
SnowPR avalia agentes em 65 tarefas reais da Snowflake. Veja o método, os resultados e por que a amostra não define um vencedor universal.

Marcelo Santiago
Criador do bridgecode
The biggest AI newsletter in the World
Get AI articles in your inbox
Technical curation on models, agents and coding tools. No spam, unsubscribe anytime.
Em vez de medir apenas pequenos reparos em projetos abertos, o teste acompanha mudanças em Java, C++ e Go dentro de uma base privada de 43 milhões de linhas.
Como o SnowPR transforma pull requests em tarefas
O SnowPR usa alterações reais que engenheiros da Snowflake revisaram e integraram. Para cada tarefa, o agente recebe uma versão anterior do código e uma descrição do comportamento esperado, mas não vê a correção original nem os testes que irão avaliar o resultado.
A aprovação depende de testes ocultos que acompanharam cada pull request. Para passar, o código precisa cumprir os novos testes e preservar os testes de regressão. A metodologia descrita pela Snowflake relata 147 alvos Bazel, com 676 casos de comportamento novo e 2.890 verificações de regressão.
A empresa também tentou reduzir tarefas ambíguas. Um modelo de linguagem ajudou a filtrar mudanças candidatas, agentes de IA inspecionaram parte delas e pessoas revisaram cada tarefa publicada. A descrição foi testada como parte da medição, pois instruções diferentes para a mesma correção alteraram a taxa de aprovação.
Essa escolha aproxima o teste de um fluxo de desenvolvimento real, mas não torna o SnowPR independente. A Snowflake selecionou os pull requests, preparou as tarefas, executou os testes e publicou os resultados. É uma avaliação interna bem documentada, não um ranking universal.
O que os agentes enfrentaram no repositório da Snowflake
O conjunto reúne 65 tarefas em 11 áreas de produto, segundo a descrição oficial do SnowPR. Sessenta e duas vêm do repositório principal da Snowflake e três de um repositório separado de ferramentas para desenvolvedores.
A maior parte do trabalho fica no plano de controle em Java. O recorte de linguagens da Snowflake também inclui oito tarefas no mecanismo de execução em C++, duas que atravessam Java e C++ e três ferramentas em Go.
A base completa tem 43 milhões de linhas. Considerando apenas arquivos de código que não são testes, a Snowflake informa 63 mil arquivos e 17 milhões de linhas, com tarefas que podem cruzar vários módulos e níveis do sistema.
A comparação com SWE bench ajuda a entender a diferença de escala. A Snowflake calcula que seu repositório tem 21 vezes mais arquivos e 39 vezes mais linhas de código de produção do que a média dos repositórios daquele benchmark.
Isso não significa que o SnowPR substitua avaliações públicas. O teste concentra muitas tarefas em um único ambiente privado, enquanto benchmarks públicos cobrem mais projetos. A diferença útil é complementar: um mede variedade entre repositórios, o outro aproxima a avaliação de uma base interna específica.
O que os resultados dizem sobre modelos e ferramentas
Cada configuração tentou cada tarefa três vezes, conforme o protocolo publicado pela Snowflake. A empresa compara a taxa de aprovação das tentativas e também o pass@3, que conta uma tarefa como resolvida quando pelo menos uma das três tentativas passa.
Com o modelo Opus 5, quatro combinações de agente e ferramenta ficaram entre 84,1% e 85,1% de aprovação nas tentativas, de acordo com os resultados da Snowflake. A própria empresa diz que 65 tarefas não bastam para distinguir diferenças tão pequenas com confiança.
O Cortex Code no modo REM resolveu ao menos uma tentativa em 62 das 65 tarefas, segundo a tabela oficial do SnowPR. O resultado não prova que esse modo seja o melhor em qualquer repositório, mas mostra como o ambiente de execução pode alterar a comparação entre agentes que usam o mesmo modelo.
O modelo também pesou mais do que pequenas diferenças entre ferramentas. Nas condições reportadas pela Snowflake, cada configuração com Opus 5 superou as configurações com Haiku 5.5 por uma margem de 10 a 21 pontos percentuais nas tentativas aprovadas.
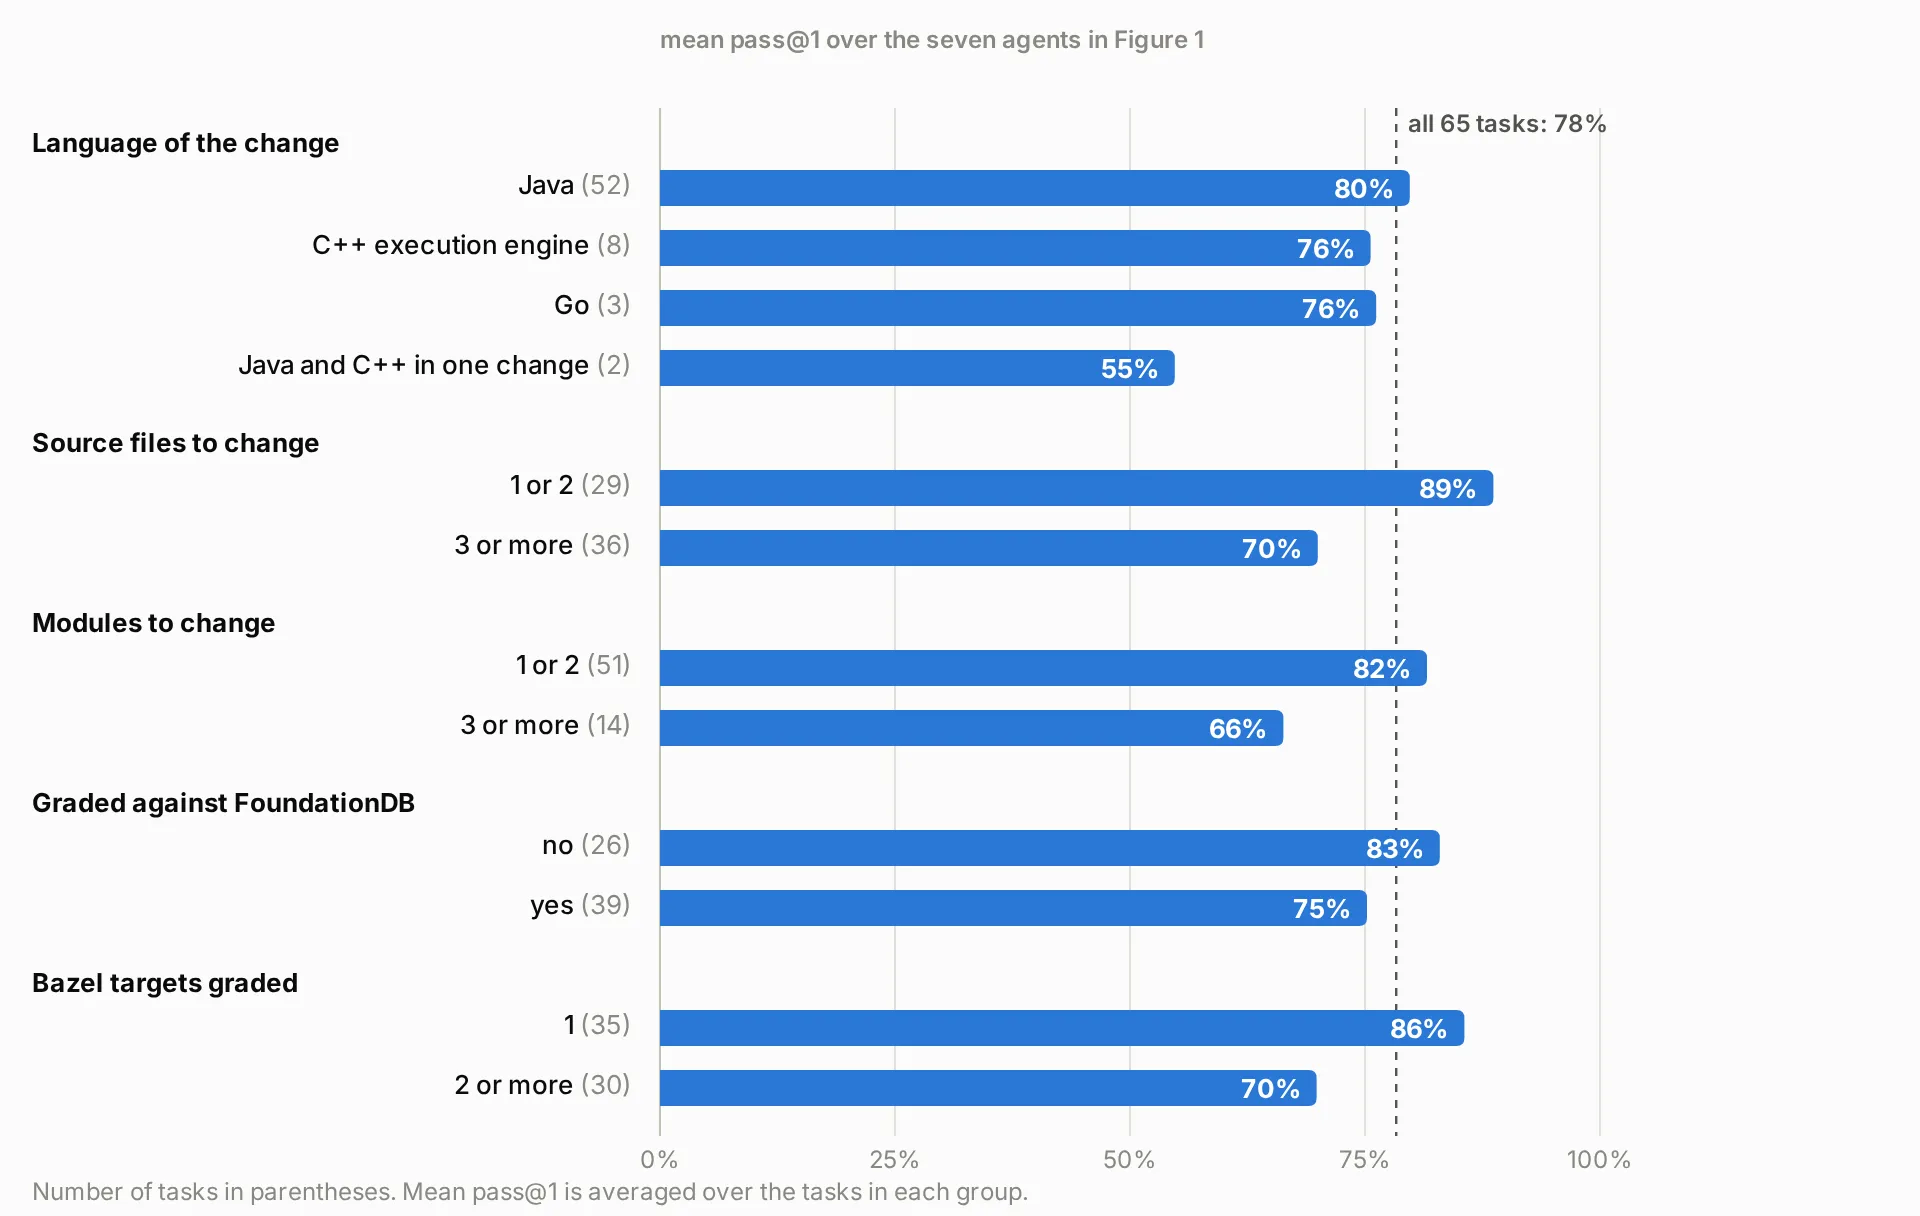
A figura abaixo mostra uma diferença que merece atenção: nas métricas publicadas pela Snowflake, tarefas que cruzaram Java e C++ tiveram 55% de aprovação, enquanto tarefas apenas em Java chegaram a 80%. O conjunto misto contém somente duas tarefas, então o contraste é um sinal para investigar, não uma estimativa estável para todo projeto.
Como usar o SnowPR como referência sem generalizar
O recado prático não é escolher um agente pelo primeiro lugar de uma tabela. A Snowflake encontrou diferenças pequenas entre algumas configurações e reconhece que o tamanho do conjunto limita a capacidade de separar esses resultados.
Uma equipe pode adaptar a ideia sem copiar o ambiente da Snowflake. Separe pull requests que representem o trabalho real, retire a correção antes de entregar a tarefa, mantenha testes ocultos e rode verificações de regressão para evitar que uma solução passe apenas por acaso.
Também vale repetir cada tarefa. Uma única execução mistura qualidade do agente com variação de amostragem. O próprio SnowPR fez três tentativas por tarefa, permitindo comparar a taxa das tentativas com a chance de resolver cada tarefa pelo menos uma vez.
A composição do benchmark importa tanto quanto o modelo. Mudanças que atravessam linguagens, módulos, bancos de dados e muitos arquivos podem exigir mais contexto e coordenação. A Snowflake observou taxas menores em tarefas com três ou mais arquivos do que nas que alteravam um ou dois.
Esse cuidado aparece também em outros estudos de código. No benchmark GenXR Bench para tarefas de realidade estendida, os agentes enfrentam tarefas específicas de SDK e criação de aplicativos. Já a comparação do DeepSeek V4.1 Flash no CursorBench 4.0 mostra outro recorte, ligado a tarefas de programação dentro de um editor.
Nenhum desses números é diretamente intercambiável. Um resultado descreve modelos, tarefas, ferramentas, limites de contexto, testes e infraestrutura daquela avaliação. Para tomar uma decisão de engenharia, reproduza o teste no código e nos critérios que sua equipe realmente usa.
Frequently asked questions about o benchmark SnowPR da Snowflake
O que é o SnowPR?
O SnowPR é um benchmark da Snowflake que mede agentes de programação em tarefas baseadas em pull requests reais de código interno. A versão publicada usa 65 tarefas em 11 áreas de produto.
Quantas tarefas o SnowPR avalia?
O conjunto contém 65 tarefas. Sessenta e duas vêm do repositório principal da Snowflake e três de um repositório separado de ferramentas para desenvolvedores.
Qual foi a taxa de aprovação do Opus 5 no SnowPR?
Quatro combinações com Opus 5 ficaram entre 84,1% e 85,1% de aprovação nas tentativas. A Snowflake ressalta que 65 tarefas não distinguem com segurança diferenças tão pequenas.
O SnowPR prova qual agente é melhor para qualquer projeto?
Não. O benchmark usa código privado, tarefas e testes definidos pela Snowflake. Os resultados descrevem esse ambiente e não garantem a mesma ordem em outro repositório.
O que significa pass@3 no SnowPR?
Pass@3 conta uma tarefa como resolvida se pelo menos uma de três tentativas passa. A Snowflake também reporta a taxa de aprovação de cada tentativa.
O SnowPR aproxima benchmarks do trabalho diário, mas não define um vencedor universal
O valor do SnowPR está em revelar que a qualidade de um agente depende também da base de código e do modo como ele acessa ferramentas. A avaliação da Snowflake oferece uma referência concreta para equipes que querem medir tarefas maiores e mais próximas da produção.
O limite é igualmente importante: são 65 tarefas de uma empresa, em código privado, com testes e execução definidos pela própria Snowflake. Use os resultados como evidência sobre esse cenário, não como garantia de desempenho no seu projeto.
Você define o objetivo e os agentes dividem o trabalho: um planeja, outro executa e outro revisa. Veja como coordenar seus agentes no bridgecode, acompanhando as etapas do projeto em um só fluxo.
Fonte: Snowflake
Tags:#SnowPR#agentes de código#benchmark#Snowflake#Cortex Code
Developer and creator of bridgecode, an agentic development environment for orchestrating squads of AI agents. Helps people going from vibe coding to professional development move from idea to shipped product.
Related articles

Benchmarks
RoleRouteBench: o que o roteamento revela em multi-agentes
RoleRouteBench é um ambiente reproduzível para avaliar roteamento dinâmico de papéis em tarefas multi-etapa. Veja os resultados do JEV 1.13 nos quatro domínios.
6 min

Benchmarks
CloudOpsBench: agentes de IA em operações de nuvem
O CloudOpsBench mede como agentes de IA executam tarefas reais de operação em nuvem. O melhor agente resolve 60,6% das 45 tarefas na AWS. Veja os números.
7 min

Benchmarks
SuperCLUE novembro 2026: líderes diferentes por categoria
SuperCLUE publicou em novembro de 2026 a tabela com 19 modelos e líderes diferentes em cada categoria. O ranking dividido é mais útil como mapa de shortlist do que como veredito final.
6 min