
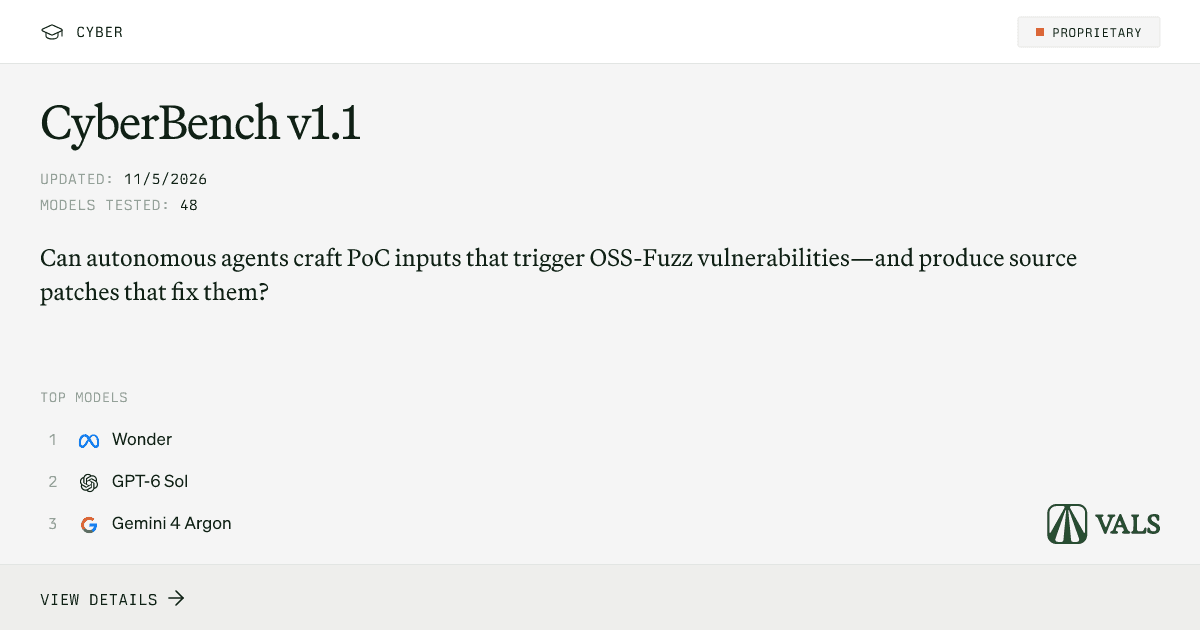
A Vals AI publicou em 5 de novembro de 2026 uma nova rodada do CyberBench, um benchmark que pergunta se agentes de IA conseguem encontrar falhas de segurança em código e produzir patches. A resposta curta é: Wonder, da Meta, lidera com 80,36%, e a maioria dos agentes fica bem abaixo.
Benchmark5 min
CyberBench: IA encontra bugs de segurança?
O CyberBench testa se agentes de IA conseguem encontrar falhas de segurança em código e produzir patches. Wonder, da Meta, lidera com 80,36%.

Marcelo Santiago
Criador do bridgecode
The biggest AI newsletter in the World
Get AI articles in your inbox
Technical curation on models, agents and coding tools. No spam, unsubscribe anytime.
O CyberBench não testa se o modelo conhece vulnerabilidades conhecidas. Ele entrega um repositório com falhas injetadas e pede que o agente encontre o bug e escreva um patch que corrija o problema sem quebrar os testes existentes. É um teste de engenharia de segurança, não de memorização de CVEs.
O que é o CyberBench
CyberBench é um benchmark que avalia se um agente de IA consegue encontrar uma falha de segurança em um repositório e produzir um patch que a corrija. Cada tarefa entrega um repositório com uma vulnerabilidade injetada e os testes existentes. O agente precisa localizar o bug, entender a causa raiz e escrever uma correção que passe nos testes de segurança e nos testes de regressão.
A ideia é medir capacidade de análise e correção, não de detecção por padrão. O agente não tem acesso à internet, a bases de CVEs ou a ferramentas de análise estática. Ele pode inspecionar o código, rodar os testes e iterar sobre a correção. Isso é mais próximo do trabalho real de um desenvolvedor de segurança do que rodar um scanner automatizado.
Isso diferencia o CyberBench do CWE-bench v2, que mede a capacidade de identificar o tipo de vulnerabilidade. Aqui o agente precisa corrigir o problema. Também se diferencia do Vals CyberOffense, que mede se modelos abertos conseguem invadir redes corporativas.
Como a avaliação funciona
A Vals AI avalia os agentes em 48 tarefas públicas do CyberBench. Cada tarefa fornece um repositório com uma vulnerabilidade injetada. O agente recebe um terminal bash, um sandbox offline e o prompt padrão do benchmark. Ele pode inspecionar o código, rodar os testes e iterar sobre a correção, mas não pode usar a internet, consultar bases de CVEs nem usar ferramentas de análise estática externas.
A submissão contém o patch produzido pelo agente. A Vals aplica o patch e executa os testes de segurança e os testes de regressão em um contêiner novo. O agente tem até 1.000 passos, limite de 6 horas de relógio e 180 segundos de timeout por ação. A saída das ferramentas é truncada em 10.000 caracteres nas pontas.
Um patch passa se corrige a vulnerabilidade e não quebra os testes existentes. Não há crédito parcial por explicação: ou a correção funciona, ou não.
O ranking oficial de 5 de novembro de 2026
A Vals testou 48 agentes no CyberBench. Wonder, da Meta, lidera com 80,36% de acerto, seguido por Claude Opus 5.5 com 75,00% e GPT-6 Astra com 72,22%. A maioria dos agentes fica abaixo de 60%.
| Posição | Modelo | Acerto |
|---|---|---|
| 1 | Wonder (Meta) | 80,36% |
| 2 | Claude Opus 5.5 | 75,00% |
| 3 | GPT-6 Astra | 72,22% |
A diferença entre o primeiro e o segundo é de mais de 5 pontos percentuais. Isso mostra que encontrar e corrigir falhas de segurança ainda é uma tarefa difícil, mesmo para os modelos mais fortes.
A Vals também compara agentes em custo e latência por tarefa. Wonder é mais barato por tentativa, mas Claude Opus 5.5 é o segundo mais preciso.
Como testar hoje
Para quem quer experimentar, a Vals disponibiliza a metodologia e os resultados na leaderboard oficial. Você pode rodar os mesmos agentes no seu próprio repositório e comparar o resultado com o ranking publicado.
A Vals também publica o código de avaliação e os prompts usados, o que permite reproduzir os testes em outros modelos e ambientes. Isso é útil para times que querem validar se um agente novo atende às suas necessidades de segurança antes de adotá-lo em produção.
Por que esse benchmark importa
O CyberBench mede uma capacidade que benchmarks de correção não capturam: a habilidade de encontrar e corrigir falhas de segurança em código real. Isso é útil em três cenários reais.
Primeiro, revisão de segurança automatizada: quando você quer que um agente revise código antes de ir para produção. Segundo, triagem de vulnerabilidades: quando você tem muitos alertas e precisa priorizar quais corrigir. Terceiro, validação de agentes de código que precisam atuar em repositórios com requisitos de segurança.
O resultado de 80,36% também é um lembrete de limite. Mesmo o melhor agente erra em quase 20% dos casos. Para quem usa agentes de código no dia a dia, isso reforça a necessidade de revisão humana e testes, como discutido na análise do Vals CyberOffense em segurança.
Frequently asked questions about o CyberBench
O que é o CyberBench?
É um benchmark que avalia se agentes de IA conseguem encontrar falhas de segurança em um repositório e produzir um patch que as corrija.
Qual agente lidera o CyberBench?
Em 5 de novembro de 2026, Wonder, da Meta, liderava com 80,36%, seguido por Claude Opus 5.5 com 75,00% e GPT-6 Astra com 72,22%.
O CyberBench parte de um repositório existente?
Não. O agente recebe um repositório com uma vulnerabilidade injetada e deve produzir um patch que a corrija, sem acesso à internet ou a bases de CVEs.
Quais são os limites de tempo e passos?
Cada agente tem até 1.000 passos, 6 horas de relógio e 180 segundos por ação. O patch deve corrigir a vulnerabilidade e não quebrar os testes existentes.
Quantas tarefas tem o CyberBench?
A Vals AI avalia 48 tarefas públicas. Cada tarefa pede a correção de uma falha de segurança em um repositório.
Conclusão: segurança ainda exige revisão humana
O CyberBench é um dos benchmarks que testam se o agente entende segurança de verdade. Os números de 5 de novembro de 2026 mostram que encontrar e corrigir falhas de segurança é difícil mesmo para os modelos mais fortes. Acompanhe a leaderboard oficial para ver como os números mudam com novos modelos.
Um squad de agentes pode dividir análise, correção e revisão, e é isso que você coordena no bridgecode.
Fonte: Vals AI
Tags:#benchmark#cyberbench#vals-ai#seguranca#agentes
Developer and creator of bridgecode, an agentic development environment for orchestrating squads of AI agents. Helps people going from vibe coding to professional development move from idea to shipped product.
Related articles
Benchmarks
SRE Bench: IA faz engenharia reversa de binários?
O SRE Bench testa se agentes de IA conseguem fazer engenharia reversa de binários sem código-fonte. GPT-6 Astra lidera com 56,87%.
5 min
Benchmarks
Vibe Code Bench: IA constrói app web do zero?
O Vibe Code Bench testa se modelos de IA conseguem construir aplicações web completas a partir de uma descrição. Claude Sonnet 5.5 no OpenHands lidera com 92,39%.
5 min
Benchmarks
ProgramBench: IA reconstrói programas do zero?
O ProgramBench testa se modelos de IA conseguem reconstruir programas de linha de comando a partir de um binário e uma especificação. Claude Opus 5.5 lidera com 18,50%.
5 min