
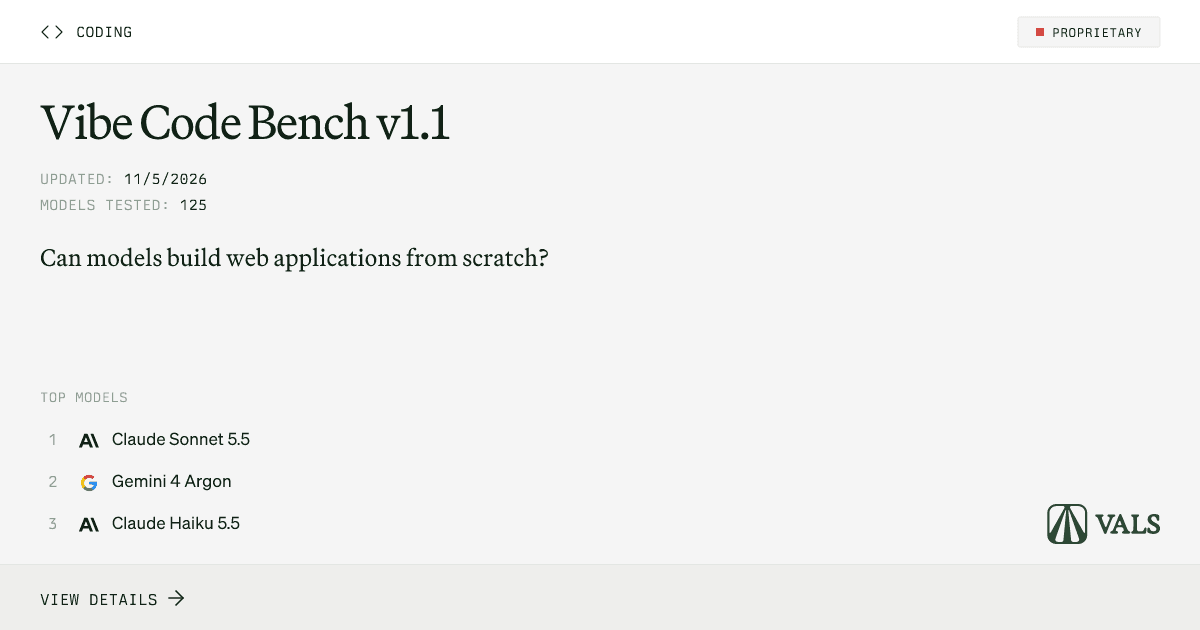
A Vals AI publicou em 5 de novembro de 2026 a versão 1.1 do Vibe Code Bench, um benchmark que pergunta se modelos de IA conseguem construir aplicações web completas a partir de uma descrição. A resposta curta é: Claude Sonnet 5.5, rodando no OpenHands, lidera com 92,39%, e a maioria dos modelos fica bem abaixo.
Benchmark5 min
Vibe Code Bench: IA constrói app web do zero?
O Vibe Code Bench testa se modelos de IA conseguem construir aplicações web completas a partir de uma descrição. Claude Sonnet 5.5 no OpenHands lidera com 92,39%.

Marcelo Santiago
Criador do bridgecode
A maior newsletter de IA do Mundo
Receba artigos sobre IA no seu e-mail
Curadoria técnica sobre modelos, agentes e ferramentas de código. Sem spam, cancele quando quiser.
O Vibe Code Bench não testa trechos de código isolados. Ele entrega uma descrição de aplicação web e pede que o modelo construa o app do zero, com interface, lógica e testes. É um teste de engenharia de software ponta a ponta, não de autocomplete.
O que é o Vibe Code Bench
Vibe Code Bench é um benchmark que avalia se um modelo consegue construir uma aplicação web a partir de uma descrição em linguagem natural. Cada tarefa pede um app funcional, com interface, lógica de negócio e testes. O modelo trabalha sozinho, sem acesso à internet, e entrega o código-fonte completo.
A ideia é medir capacidade de construção, não de correção. O modelo precisa tomar decisões de arquitetura, implementar a interface, escrever a lógica e garantir que os testes passem. Isso é mais próximo do trabalho real de um desenvolvedor do que corrigir um bug em um repositório existente.
Isso diferencia o Vibe Code Bench de benchmarks como o CursorBench, que mede a capacidade de editar código em um editor. Aqui o modelo constrói do zero. Também se diferencia do SWE-bench Pro, que parte de um repositório existente e pede um patch.
Como a avaliação funciona
A Vals AI avalia os modelos em 125 tarefas públicas do Vibe Code Bench. Cada tarefa fornece uma descrição de aplicação web. O agente recebe um terminal bash, um sandbox offline e o prompt padrão do benchmark. Ele pode inspecionar os arquivos entregues, mas não pode usar a internet, consultar registros de pacotes nem usar ferramentas de análise binária.
A submissão contém arquivos de código-fonte e um script de compilação. A Vals compila e executa os testes em um contêiner novo. O agente tem até 1.000 passos, limite de 6 horas de relógio e 180 segundos de timeout por ação. A saída das ferramentas é truncada em 10.000 caracteres nas pontas.
Um app passa se a interface renderiza, a lógica funciona e os testes ocultos passam. Não há crédito parcial por explicação: ou o app funciona, ou não.
O ranking oficial de 5 de novembro de 2026
A Vals testou 125 modelos no Vibe Code Bench. Claude Sonnet 5.5, rodando no OpenHands, lidera com 92,39%, seguido por Claude Sonnet 5 com 89,50% e Claude Sonnet 4.6 com 85,20%. A maioria dos modelos fica abaixo de 70%.
| Posição | Modelo | Acerto |
|---|---|---|
| 1 | Claude Sonnet 5.5 (OpenHands) | 92,39% |
| 2 | Claude Sonnet 5 | 89,50% |
| 3 | Claude Sonnet 4.6 | 85,20% |
A diferença entre o primeiro e o segundo é de quase 3 pontos percentuais. Isso mostra que construir apps web do zero é uma tarefa que os modelos de fronteira já dominam razoavelmente bem, mas ainda com margem para erro.
A Vals também compara modelos em custo e latência por tarefa. Claude Sonnet 5.5 no OpenHands é mais caro por tentativa, mas é o único que passa de 92%.
Como testar hoje
Para quem quer experimentar, a Vals disponibiliza a metodologia e os resultados na leaderboard oficial. Você pode rodar os mesmos modelos no seu próprio projeto e comparar o resultado com o ranking publicado.
A Vals também publica o código de avaliação e os prompts usados, o que permite reproduzir os testes em outros modelos e ambientes. Isso é útil para times que querem validar se um modelo novo atende às suas necessidades antes de adotá-lo em produção.
Por que esse benchmark importa
O Vibe Code Bench mede uma capacidade que benchmarks de patch não capturam: a habilidade de construir software do zero a partir de uma descrição. Isso é útil em três cenários reais.
Primeiro, prototipagem rápida: quando você precisa de um app funcional em horas, não em dias. Segundo, validação de agentes de código que precisam entregar funcionalidades completas, não apenas correções. Terceiro, comparação entre modelos para escolher qual usar em projetos de construção.
O resultado de 92,39% também é um lembrete de limite. Mesmo o melhor modelo erra em quase 8% dos casos. Para quem usa agentes de código no dia a dia, isso reforça a necessidade de revisão humana e testes, como discutido na análise do FeatureLoop em repositórios reais.
Perguntas frequentes sobre o Vibe Code Bench
O que é o Vibe Code Bench?
É um benchmark que avalia se modelos de IA conseguem construir aplicações web completas a partir de uma descrição em linguagem natural, com interface, lógica e testes.
Qual modelo lidera o Vibe Code Bench?
Em 5 de novembro de 2026, Claude Sonnet 5.5 no OpenHands liderava com 92,39%, seguido por Claude Sonnet 5 com 89,50% e Claude Sonnet 4.6 com 85,20%.
O Vibe Code Bench parte de um repositório existente?
Não. O modelo recebe uma descrição e deve construir o app do zero, sem repositório de partida nem acesso à internet.
Quais são os limites de tempo e passos?
Cada agente tem até 1.000 passos, 6 horas de relógio e 180 segundos por ação. O app deve renderizar, funcionar e passar nos testes ocultos em contêineres novos.
Quantas tarefas tem o Vibe Code Bench?
A Vals AI avalia 125 tarefas públicas. Cada tarefa pede a construção de uma aplicação web a partir de uma descrição.
Conclusão: construir do zero é mais difícil do que corrigir
O Vibe Code Bench é um dos benchmarks que testam se o modelo entende software de verdade. Os números de 5 de novembro de 2026 mostram que construir apps web do zero é uma tarefa que os modelos de fronteira dominam razoavelmente bem, mas com margem para erro. Acompanhe a leaderboard oficial para ver como os números mudam com novos modelos.
Um squad de agentes pode dividir design, implementação e testes, e é isso que você monta no bridgecode.
Fonte: Vals AI
Tags:#benchmark#vibe-code-bench#vals-ai#codigo#agentes
Desenvolvedor e criador do bridgecode, ambiente de desenvolvimento agêntico para orquestrar squads de agentes de IA. Ajuda quem vai do vibe coding ao desenvolvimento profissional a sair da ideia e chegar ao produto entregue.
Artigos relacionados
Benchmarks
ProgramBench: IA reconstrói programas do zero?
O ProgramBench testa se modelos de IA conseguem reconstruir programas de linha de comando a partir de um binário e uma especificação. Claude Opus 5.5 lidera com 18,50%.
5 min
Benchmarks
SRE Bench: IA faz engenharia reversa de binários?
O SRE Bench testa se agentes de IA conseguem fazer engenharia reversa de binários sem código-fonte. GPT-6 Astra lidera com 56,87%.
5 min
Benchmarks
CyberBench: IA encontra bugs de segurança?
O CyberBench testa se agentes de IA conseguem encontrar falhas de segurança em código e produzir patches. Wonder, da Meta, lidera com 80,36%.
5 min