
GDPx es el nuevo benchmark de SemiAnalysis para evaluar capacidades de agentes de IA en tareas de alto valor. Publicado el 2 de noviembre de 2026, cubre 11 dominios y pone una salvedad importante en el marcador: el mejor sistema llega al 12%.

GDPx: el mejor modelo marca 12% en 11 dominios
El benchmark GDPx evalúa agentes en 11 dominios de alto valor. El mejor sistema marcó 12%, con resultados distintos por tarea.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
El número no es una nota universal de inteligencia. GDPx combina tareas diferentes, con reglas de puntuación propias, para mostrar dónde avanzan los modelos y dónde aún fallan en flujos de trabajo especializados.
En este artículo vas a ver:
- Qué mide GDPx y por qué se creó
- Cómo SemiAnalysis construyó y evaluó las tareas
- Qué muestra el ranking sobre modelos y agentes
- Qué límites considerar antes de elegir un modelo
Qué mide GDPx en 11 dominios de trabajo
GDPx evalúa agentes de IA en chip design, ciberseguridad, biología, finanzas, derecho, trading cuantitativo, auto mejora recursiva, diseño de hardware, ciencia de materiales, alineación e ingeniería de software.
La publicación de lanzamiento de SemiAnalysis presenta a GDPx como evaluación de tareas especializadas.
El equipo dice que busca medir capacidades de agentes en trabajos técnicos y profesionales de alto valor.
GDPx va más allá de preguntas y respuestas: los agentes usan herramientas, investigan y entregan resultados evaluados por criterios de cada área.
La página oficial describe una evaluación colaborativa. SemiAnalysis contactó a más de 30 empresas con experiencia en entornos de aprendizaje por refuerzo y sometió a los potenciales socios al mismo proceso de control de calidad.
Ese proceso busca inconsistencias, lagunas, trampas y verificadores injustos. En otras palabras, la pregunta no es solo si una respuesta parece correcta, sino si el resultado cumple con los requisitos concretos de la tarea.
El equipo presenta a GDPx como un benchmark vivo y dice que pretende lanzar nuevas versiones cada tres a seis meses. Esto importa porque las tareas necesitan acompañar la evolución de los modelos y de las herramientas de agentes.
Cómo SemiAnalysis construyó y evaluó las tareas
Cada dominio usa tareas creadas con socios especializados. La ingeniería de software, por ejemplo, no se trata como una prueba corta de completar código: el proyecto evalúa tareas agénticas en flujos de trabajo reales.
En auto mejora recursiva, los agentes reciben cerca de mil rastros de ejecución, que suman 21,2 millones de tokens, además de recompensas, resultados de evaluación y versiones anteriores del código de entrenamiento.
La tarea pide que el agente investigue por qué el desempeño de entrenamiento cayó y entregue un diagnóstico sustentado por evidencias.
En la versión descrita por SemiAnalysis, fueron 20 rollouts distribuidos entre cuatro modelos, y todos tuvieron dificultad para encontrar una solución estable.
En hardware, uno de los ejemplos públicos es el diseño de una carcasa para compresor. El agente necesita posicionar componentes, soportar cargas, evitar colisiones, permitir moldeo y preservar relaciones del conjunto durante revisiones.
La evaluación verifica si el diseño respeta las holguras, evita colisiones, soporta cargas y continúa editable tras alteraciones. Así, la prueba observa más que la apariencia de una imagen final.
Verificadores objetivos se combinan con revisión especializada para evaluar medidas y decisiones de fabricación.
Qué muestra el ranking de GDPx sobre los modelos
En la tabla inicial, Claude Opus 5.5 lidera con 12%. Gemini 4 Carbon aparece con 10,9%, y GPT 6 Astra con 9,6%. SemiAnalysis también publica resultados por dominio, no solo un promedio general.
En el gráfico publicado por SemiAnalysis en X, el promedio da el mismo peso a cada uno de los 11 dominios.
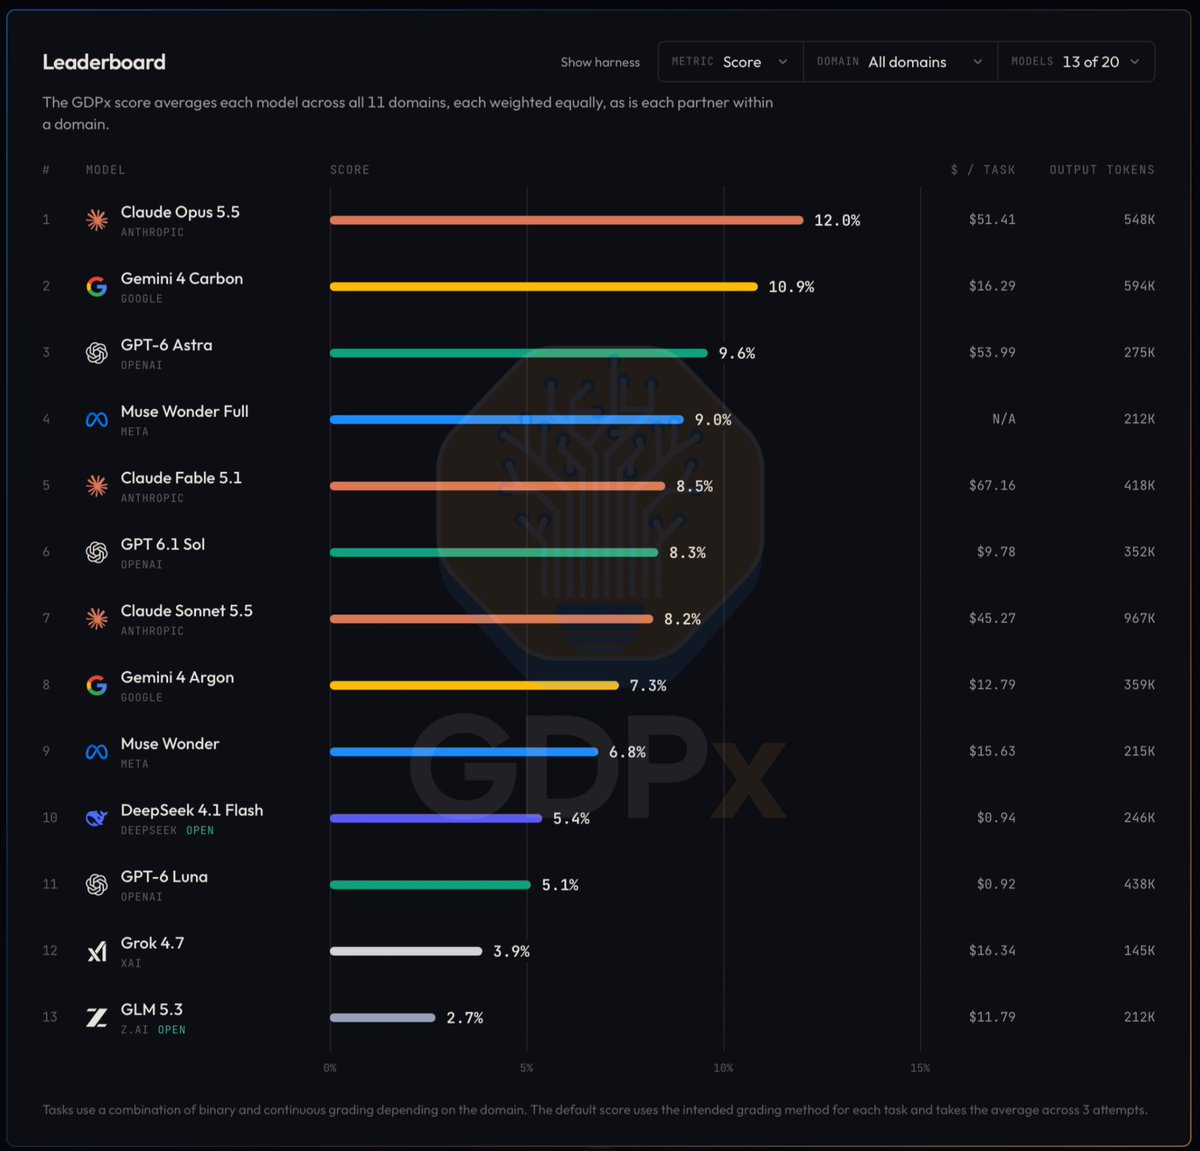
Esas posiciones no significan que un único modelo sea el mejor para cualquier proyecto. El propio análisis describe especializaciones.
Opus 5.5 gana en trading cuantitativo, hardware y chip design. Gemini 4 Carbon lidera en biología e ingeniería de software.
GPT 6 Astra aparece a la cabeza en auto mejora recursiva y ciencia de materiales.
En finanzas y derecho, SemiAnalysis reporta que prácticamente todos los modelos quedan en cero cuando la evaluación binaria exige cumplir todos los criterios.
La empresa también alerta que los clasificadores de seguridad afectan algunos resultados en ciberseguridad, biología y alineación. Al remover esos dominios, el orden cambia. Esta es una salvedad importante para interpretar un promedio agregado.
El ranking público muestra una fotografía de la versión inicial, no una garantía de desempeño en cada entorno de producción.
Para otro recorte de evaluación, mira nuestro análisis del Artificial Analysis Intelligence Index v5.
Por qué GDPx prueba más allá de una respuesta correcta
El caso del compresor muestra la diferencia entre pasar por una etapa y concluir la tarea. SemiAnalysis reporta 12 rollouts, tres por modelo, y ninguno alcanzó aprobación completa.
La diferencia entre pasar algunas verificaciones y entregar un resultado utilizable ayuda a entender el objetivo de GDPx. En ingeniería, una pieza puede parecer correcta y aun así fallar cuando cambia una dimensión o cuando necesita ser fabricada.
SnowPR también evalúa agentes en tareas basadas en pull requests reales.
Nuestro artículo sobre SnowPR de Snowflake explica por qué ese resultado no define un ganador universal.
Una puntuación baja no prueba incapacidad total, y una puntuación alta no garantiza éxito fuera de la muestra.
El resultado depende del dominio, de la regla de aprobación y de la configuración evaluada.
La propia fuente muestra ese efecto en finanzas. Como la puntuación binaria dejaba a todos los modelos en cero, los autores también reportaron promedios parciales para que se pudieran observar diferencias dentro de las tareas.
Cómo interpretar GDPx antes de elegir un agente
El primer paso es revisar el dominio que más se acerca a tu trabajo. Un promedio de 11 áreas puede ocultar un modelo fuerte en software y débil en ciberseguridad, o viceversa.
El segundo paso es leer cómo se puntuó cada tarea. Algunas usan criterios binarios, otras permiten puntos parciales, y cada dominio puede tener verificadores y artefactos diferentes.
También vale observar el entorno y los límites de la evaluación. GDPx reúne tareas de varios socios y usa verificaciones propias.
Por eso, las condiciones no equivalen a una prueba independiente hecha en tu código, en tus datos o en tus procesos.
Por último, trata el ranking como un mapa de investigación. Ayuda a formular preguntas de prueba, pero la elección debe validarse con tareas similares a las que el agente realmente recibirá.
Preguntas frecuentes sobre el benchmark GDPx de SemiAnalysis
¿Qué es el benchmark GDPx?
GDPx es una evaluación de SemiAnalysis para agentes de IA en 11 dominios especializados. Combina tareas prácticas con criterios de evaluación distintos por área.
¿Qué modelo lidera el ranking de GDPx?
Claude Opus 5.5 lidera la tabla general publicada, con 12%. Gemini 4 Carbon aparece con 10,9%, seguido por GPT 6 Astra con 9,6%.
¿Qué significa la puntuación de 12% en GDPx?
Es la puntuación agregada del leaderboard inicial, que da el mismo peso a 11 dominios. No es una garantía de que el modelo resolverá el 12% de cualquier tarea en el mundo real.
¿GDPx prueba qué agente es mejor para cualquier proyecto?
No. Los resultados varían por dominio, método de puntuación y configuración. SemiAnalysis también informa que el orden cambia cuando se retiran algunos dominios por efecto de clasificadores de seguridad.
¿Con qué frecuencia se actualizará GDPx?
SemiAnalysis dice que pretende lanzar nuevas versiones cada tres a seis meses para acompañar la evolución de los modelos y de las tareas.
La GDPx refuerza la necesidad de probar agentes por tarea
La contribución principal de GDPx es mostrar la diferencia entre una demostración convincente y un flujo especializado que resista verificaciones, revisiones y cambios.
Los resultados iniciales muestran un progreso desigual entre dominios.
Para quien desarrolla con IA, la lección es comparar modelos por tarea y revisar el resultado antes de confiar en la puntuación agregada. GDPx es un punto de partida para pruebas más cercanas al propio trabajo.
Usted define el objetivo y los agentes dividen las tareas: uno planea, otro ejecuta, otro revisa. Vea cómo funciona la orquestación en bridgecode.
Fuente: SemiAnalysis
Tags:#GDPx#SemiAnalysis#benchmarks#agentes de IA#engenharia de software#modelos de IA
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Benchmarks
Inkling 2 Small suelta 316 palabrotas en benchmarks: lo que revela
Inkling 2 Small soltó 316 palabrotas en 2.655 ejecuciones de benchmark. Lo que esto revela sobre los bucles de razonamiento y sobre la lectura de benchmarks.
6 min

Benchmarks
Construction AI Leaderboard: Claude Opus 5.5 lidera en 5 ejes
ONESTRUCTION publicó el 7 de noviembre de 2026 un ranking de 20 modelos de IA en cinco ejes de trabajo real de construcción. Claude Opus 5.5 lideró con 73,7 puntos.
6 min

Benchmarks
CloudOpsBench: agentes de IA en operaciones en la nube
CloudOpsBench mide cómo los agentes de IA ejecutan tareas reales de operación en la nube. El mejor agente resuelve el 60,6% de las 45 tareas en AWS. Mira los números.
7 min