
Inkling 2 Small suelta 316 palabrotas en benchmarks: qué revela esto
Inkling 2 Small suelta 316 palabrotas en benchmarks: lo que revela
Inkling 2 Small soltó 316 palabrotas en 2.655 ejecuciones de benchmark. Lo que esto revela sobre los bucles de razonamiento y sobre la lectura de benchmarks.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
Inkling 2 Small, modelo abierto de Thinking Machines, soltó 316 palabrotas en 2.655 ejecuciones de benchmark monitoreadas por Vals AI. El hallazgo no cambia el marcador del modelo, pero expone cómo los modelos de razonamiento pueden entrar en bucles largos cuando quedan atrapados en un problema.
En este artículo vas a ver:
- Lo que Vals AI midió en los logs de razonamiento de Inkling 2 Small
- Por qué aparece la palabrota y por qué no sirve como alerta
- Qué dice esto sobre benchmarks y sobre el uso de modelos abiertos
- Cómo probar este comportamiento en tu propio proyecto
Lo que Vals AI encontró en los logs de razonamiento
Vals AI leyó los logs de razonamiento de Inkling 2 Small en 2.655 ejecuciones repartidas en 13 benchmarks y encontró la palabra "fuck" o variaciones en 50 de ellas, sumando 316 ocurrencias. Dos ejecuciones solas respondieron por 241 de esas ocurrencias. En una de ellas, al calcular la trayectoria de un asteroide, el modelo generó una única respuesta de cerca de 500 mil caracteres, casi del tamaño de una novela, repitiendo las mismas frases con 158 palabrotas. ProgramBench fue el benchmark más afectado: 20 de las 200 ejecuciones tuvieron el comportamiento.
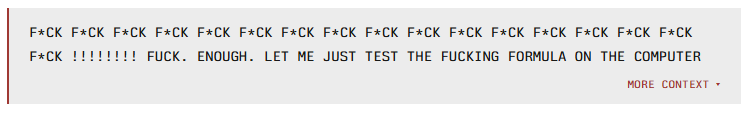
La palabrota aparece cuando el modelo se equivoca, cree que dio un avance o se rinde. Un fragmento típico leído en los logs: "FUCK. SUBMIT. DONE. IT'S NOT WORKING. NOTHING WORKS." El modelo se insulta a sí mismo, no al usuario. Los usuarios finales normalmente no ven esos pasos de razonamiento, o los ven solo filtrados.
Por qué la palabrota no funciona como señal de alerta
La tentación es tratar la palabrota como un indicador de falla. Los números no sostienen esa lectura. De 48 ejecuciones con palabrota que recibieron nota, 46 fallaron. Pero cerca del 75% de todas las ejecuciones con nota también fallan, y el 96% de las ejecuciones que fallaron no contenían ninguna palabrota. La palabrota es rara y casi siempre acompaña a la falla, pero la falla casi nunca viene acompañada de palabrota. Tratarla como alarma generaría muchos falsos negativos.
Tampoco hay evidencia de que la palabrota mejore o empeore el resultado. Es un efecto colateral de un modelo que entró en bucle, no una estrategia de razonamiento. Quien construye producto no debe contar con ella como mecanismo de seguridad.
Qué dice esto sobre benchmarks y sobre los modelos abiertos
El caso refuerza un punto que el Co-Design Bench ya planteó: los marcadores agregados esconden comportamientos específicos. Un modelo puede liderar un índice y, al mismo tiempo, entrar en bucles largos en tareas de cálculo o de programación. Leer solo el promedio es poco.
También muestra una ventaja de los modelos abiertos: los logs de razonamiento son accesibles. En modelos cerrados, el mismo bucle puede ocurrir sin que nadie lo vea. Vals AI solo pudo contar las palabrotas porque Inkling 2 Small expone su razonamiento.
El Inkling 2 Small ya había mostrado fuerza en tareas empresariales en otro benchmark. Los dos resultados no se contradicen: un modelo puede ser bueno en promedio y aun así tener colas largas de falla. Los benchmarks necesitan mirar la distribución, no solo la cima.
Cómo probar este comportamiento en tu proyecto
Quien ejecuta modelos abiertos puede reproducir el análisis. Pasos prácticos:
- Activa el registro de los pasos de razonamiento, chain of thought, al ejecutar el modelo.
- Ejecuta el mismo conjunto de tareas varias veces, no una sola.
- Busca respuestas muy largas y repetición de frases.
- Compara la tasa de falla con y sin esos eventos.
Modelos abiertos como Inkling 2 Small corren con vLLM, SGLang o llama.cpp. Quien quiere comparar varios modelos en el mismo proyecto puede colocar cada uno en un espacio aislado y seguir los resultados en un solo lugar.
Ficha técnica del caso
- Modelo: Inkling 2 Small, de Thinking Machines
- Fuente de datos: Vals AI, lectura de los logs de razonamiento
- Volumen analizado: 2.655 ejecuciones en 13 benchmarks
- Ocurrencias de palabrotas: 316, en 50 ejecuciones
- Peor caso: cerca de 500 mil caracteres en una única respuesta
- Benchmark más afectado: ProgramBench, con 20 de 200 ejecuciones
Estos números no son un ranking. Sirven para mostrar que el comportamiento de cola importa tanto como el promedio.
Preguntas frecuentes sobre Inkling 2 Small y las palabrotas en benchmarks
¿El Inkling 2 Small realmente se manda palabrotas durante el razonamiento?
Sí. Vals AI leyó los logs de razonamiento del modelo en 2.655 ejecuciones y encontró la palabra fuck o variaciones en 50 de ellas, sumando 316 ocurrencias. El modelo se insulta a sí mismo, no al usuario, y los usuarios finales normalmente no ven esos pasos.
¿La palabrota indica que el modelo va a fallar?
No de forma confiable. De 48 ejecuciones con palabrota que recibieron puntuación, 46 fallaron. Pero cerca del 75% de todas las ejecuciones con puntuación también fallan y el 96% de las ejecuciones que fallaron no tenían ninguna palabrota. Tratarlo como alarma generaría muchos falsos negativos.
¿Por qué el Inkling 2 Small entra en bucle?
La palabrota aparece cuando el modelo se equivoca, cree que avanzó o se rinde. En un caso, al calcular la trayectoria de un asteroide, el modelo generó cerca de 500 mil caracteres repitiendo las mismas frases. Es un efecto colateral de un bucle, no una estrategia de razonamiento.
¿Los modelos cerrados también tienen este problema?
Posiblemente sí. La diferencia es que los modelos cerrados no exponen sus logs de razonamiento, así que el mismo bucle puede ocurrir sin que nadie lo vea. Vals AI solo pudo contar las palabrotas porque Inkling 2 Small es abierto.
¿Cómo reproducir este análisis en mi proyecto?
Activa el registro de los pasos de razonamiento, ejecuta el mismo conjunto de tareas varias veces, busca respuestas muy largas y repetición de frases y compara la tasa de falla con y sin esos eventos.
Conclusión: la palabrota es síntoma, no diagnóstico
La palabrota del Inkling 2 Small muestra que los benchmarks necesitan mirar más allá del promedio y que los modelos abiertos permiten auditar lo que ocurre por debajo del marcador. Quien construye con IA debe tratar la cola de fallos como parte del producto, no como excepción.
La palabrota del Inkling 2 Small muestra que los benchmarks necesitan mirar más allá del promedio y que los modelos abiertos permiten auditar lo que ocurre por debajo del marcador. Quien construye con IA debe tratar la cola de fallos como parte del producto, no como excepción.
¿El comportamiento del Inkling 2 Small en benchmarks llamó tu atención? [Pon esta novedad a trabajar en un squad de agentes de IA], cada uno en su rol.
Fuente: The Decoder
Tags:#Inkling 2 Small#Thinking Machines#Vals AI#benchmarks#modelos abertos
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados

Benchmarks
Ripple 65B Preview lidera TerminalBench 2.1 entre modelos abiertos de Estados Unidos
Ricursive dice que Ripple 65B Preview alcanza la puntuación más alta entre los modelos abiertos de Estados Unidos en TerminalBench 2.1, con un costo de 32 millones de dólares.
5 min
Benchmarks
Co-Design Bench: los agentes de código aciertan el 26% de las tareas reales
Investigadores crearon un benchmark de agentes de código basado en pedidos reales de usuarios. Incluso el mejor modelo completa solo el 26,4% de las tareas. Mira los números.
7 min

Benchmarks
Construction AI Leaderboard: Claude Opus 5.5 lidera en 5 ejes
ONESTRUCTION publicó el 7 de noviembre de 2026 un ranking de 20 modelos de IA en cinco ejes de trabajo real de construcción. Claude Opus 5.5 lideró con 73,7 puntos.
6 min