
ONESTRUCTION publicó el 7 de noviembre de 2026 el Construction AI Leaderboard, un ranking que mide 20 modelos de IA en cinco ejes de trabajo real de construcción. Claude Opus 5.5 quedó en primer lugar general con 73,7 puntos, seguido de cerca por Gemini 4 Argon con 73,6 y Claude Opus 5 con 72,7.

Construction AI Leaderboard: Claude Opus 5.5 lidera en 5 ejes
ONESTRUCTION publicó el 7 de noviembre de 2026 un ranking de 20 modelos de IA en cinco ejes de trabajo real de construcción. Claude Opus 5.5 lideró con 73,7 puntos.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
El resultado importa porque la mayoría de los benchmarks de modelos evalúan código o razonamiento genérico. Este intenta medir lo que ocurre cuando la IA necesita leer planos, editar modelos BIM, responder preguntas de presupuesto y generar especificaciones de infraestructura digital. Son tareas en las que un error de interpretación cuesta caro y retrasa la obra.
En este artículo verás:
- Qué mide el Construction AI Leaderboard y cómo se construyó.
- Los cinco ejes de evaluación y por qué fueron elegidos.
- Los resultados generales y los líderes en cada eje.
- Lo que lograron los modelos open-weight frente a los propietarios.
- Cómo leer costo y tiempo sin confundir precio con calidad.
¿Qué es el Construction AI Leaderboard
El Construction AI Leaderboard fue creado por ONESTRUCTION para responder a una pregunta práctica: qué modelo de IA funciona mejor en trabajo de construcción. La propuesta no es medir conocimiento general, sino simular actividades que equipos de ingeniería, arquitectura y planificación ejecutan todos los días.
El ranking combina cinco benchmarks existentes y propios, cada uno representando una categoría de tarea. El score general es el promedio de los cinco ejes, convertido a una escala de 100 puntos. Son 20 modelos evaluados, entre propietarios y open-weight, con inferencia ejecutándose en OpenRouter para los propietarios y en GPUs H200 propias para los modelos abiertos.
La evaluación se realizó en octubre de 2026 y se publicó el 7 de noviembre. El conjunto de modelos incluye GPT-6 Astra, GPT-6.1 Sol, Claude Opus 5 y 5.5, Claude Sonnet 5 y 5.5, Gemini 3.1 Pro, Gemini 3.7 Flash, Gemini 4 Argon, Grok 4.7, Muse Spark 1.3, además de modelos open-weight como Qwen3.8-27B, GLM-5.3-Flash, DeepSeek V4.1 Flash, Kimi K3, Gemma 4 31B IT y otros.
Los cinco ejes de evaluación
Cada eje usa un benchmark con método propio y score convertido a 100 puntos. El promedio de los cinco forma el score general.
- Dibujos y documentos (AEC-Bench): preguntas y detección de conflictos en planos y documentos de construcción. El agente convierte PDFs en imágenes, extrae texto y ejecuta código para llegar a una respuesta en JSONL.
- Edición de BIM (BIM-Edit): editar modelos IFC siguiendo instrucciones en lenguaje natural.
- Comprensión de BIM (IFC-Bench-V2): explorar modelos IFC y responder preguntas sobre ellos.
- Preguntas de presupuesto (CEQuest): conocimiento de estimación y lectura de planos.
- Generación de IDS (Ishigaki-IDS-Bench): generar especificaciones IDS en XML a partir de requisitos de información BIM.
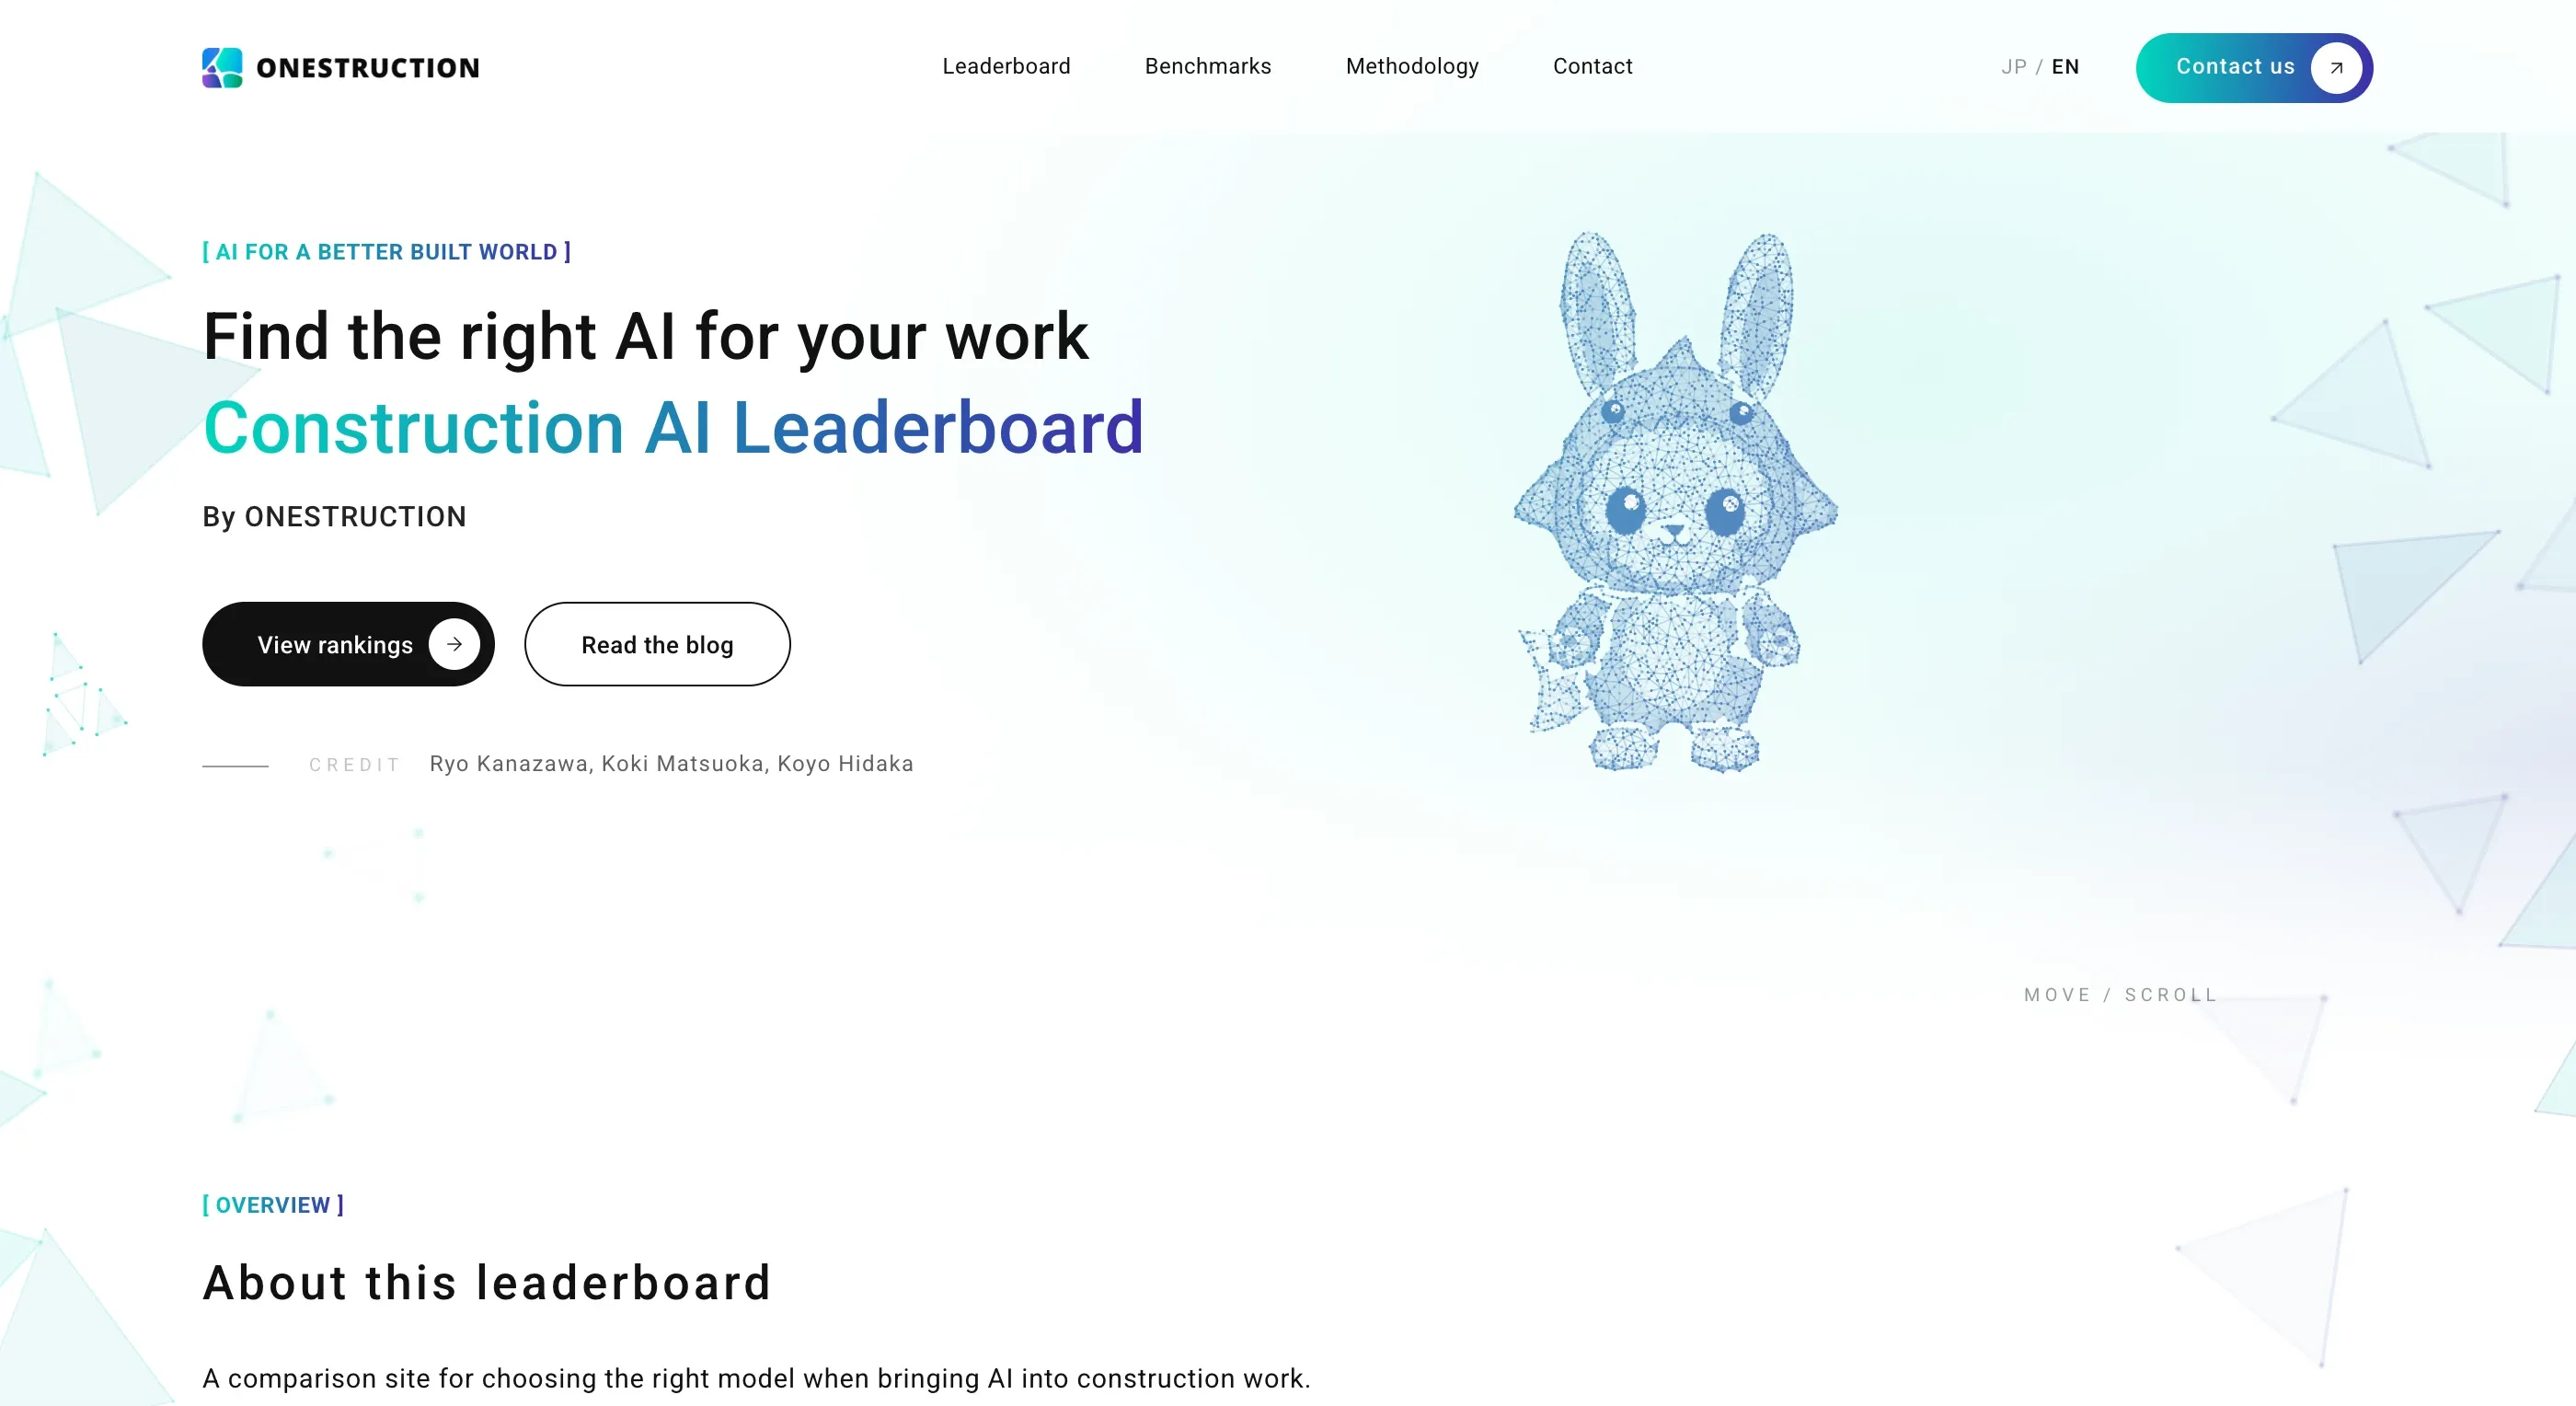
La elección de los ejes refleja lo que ONESTRUCTION considera esencial en obra: leer documentos, entender y modificar modelos digitales, estimar costos y generar especificaciones. Ninguno de los cinco cubre todo el trabajo de construcción, y la empresa afirma estar desarrollando un benchmark propio llamado BIMGenBench para generación de modelos BIM a partir de planos.
Resultados generales: Claude Opus 5.5 a la cabeza
Claude Opus 5.5 lideró con 73,7 puntos, apenas 0,1 punto por delante de Gemini 4 Argon con 73,6. Claude Opus 5 quedó en tercero con 72,7. GPT-6 Astra marcó 70,1, casi empatado con GPT-6.1 Sol con 70,2. Entre los modelos open-weight, DeepSeek V4.1 Flash (versión del 17 de octubre) alcanzó 67,6 en dibujos y documentos, superando a GPT-6 Astra con 66,2 en ese eje.
La cercanía entre Opus 5.5 y Gemini 4 Argon muestra que el liderazgo no es holgado. Diferencias de décimas de punto pueden cambiar con ajuste de prompt, versión del modelo o configuración de inferencia. El ranking es un retrato, no una verdad absoluta.
Líderes por eje de evaluación
Los primeros lugares se dividieron entre cuatro modelos, lo que refuerza la idea de que no existe un modelo universalmente mejor.
- Dibujos y documentos: Claude Opus 5.5 con 70,2 puntos.
- Generación de IDS: Claude Opus 5.5 con 63,0 puntos.
- Comprensión de BIM: Claude Opus 5 con 79,7 puntos.
- Edición de BIM: Gemini 4 Argon con 78,9 puntos.
- Preguntas de presupuesto: Gemini 3.7 Flash con 95,5 puntos.
Claude Opus 5.5 fue el único en liderar dos ejes. Gemini 4 Argon quedó primero en edición de BIM y segundo en el general. Gemini 3.7 Flash, aunque marcó 95,5 en presupuesto, no aparece entre los tres primeros en el score general, lo que muestra cómo un eje aislado puede distorsionar la elección si no se ve en conjunto.
Modelos open-weight que sorprenden
El ranking incluyó modelos open-weight y algunos de ellos superaron a propietarios en ejes específicos.
- DeepSeek V4.1 Flash (17 de octubre) marcó 67,6 en dibujos y documentos, contra 66,2 de GPT-6 Astra. Es un resultado expresivo para un modelo que puede ejecutarse en infraestructura propia.
- GLM-5.3-Flash marcó 61,9 en dibujos y documentos, superando a Claude Sonnet 5.5 con 58,6, y 78,9 en edición de BIM, casi empatado con Claude Fable 5 con 79,7.
Estos resultados muestran que los modelos abiertos ya compiten en tareas de dominio específico, siempre que el equipo tenga capacidad de hospedaje y ajuste. La diferencia de costo puede ser decisiva para empresas que procesan grandes volúmenes de planos y modelos BIM.
Costo y tiempo: lo que el número no dice
Construction AI Leaderboard también registró costo por tarea y tiempo de procesamiento, lo que ayuda a separar desempeño de viabilidad económica.
- Claude Opus 5.5 costó cerca de 0,33 dólar por tarea y tardó 1,7 minuto, contra 1,80 dólar y 5,0 minutos de la generación anterior. Es decir, mejoró siete puntos en dibujos y documentos con una quinta parte del costo y un tercio del tiempo.
- GPT-6.1 Sol quedó en cuarto lugar general con 70,2 puntos, casi igual que GPT-6 Astra con 70,1, pero a una sexta parte del costo por tarea (0,12 dólar contra 0,78).
- Claude Sonnet 5.5 marcó 66,9 puntos generales con un costo de 0,14 dólar, apareciendo como opción entre los modelos propietarios de bajo costo.
El costo por tarea no es precio de API. Es el costo medido en la ejecución del benchmark, incluyendo tokens y tiempo. Para una empresa que procesa miles de planos, la diferencia entre 0,12 y 1,80 dólar por tarea puede definir qué modelo entra en producción, aunque el más caro tenga una puntuación un poco mayor.
Preguntas frecuentes sobre el Construction AI Leaderboard
¿Qué es el Construction AI Leaderboard?
Es un ranking de ONESTRUCTION que mide 20 modelos de IA en cinco ejes de trabajo real de construcción, publicado el 7 de noviembre de 2026. El score general es el promedio de los cinco ejes en escala de 100 puntos.
¿Qué modelo lideró el Construction AI Leaderboard?
Claude Opus 5.5 lideró con 73,7 puntos, seguido por Gemini 4 Argon con 73,6 y Claude Opus 5 con 72,7. La diferencia entre los dos primeros fue de apenas 0,1 punto.
¿Cuáles son los cinco ejes de evaluación?
Dibujos y documentos (AEC-Bench), edición de BIM (BIM-Edit), comprensión de BIM (IFC-Bench-V2), preguntas de presupuesto (CEQuest) y generación de especificaciones IDS (Ishigaki-IDS-Bench).
¿Los modelos open weight compiten con los propietarios?
En algunos ejes sí. DeepSeek V4.1 Flash superó a GPT-6 Astra en dibujos y documentos, y GLM-5.3-Flash casi empató con Claude Fable 5 en edición de BIM. El hosting propio tiene un costo oculto no reflejado en el ranking.
¿Cómo usar este benchmark en la práctica?
Mira el eje que corresponde a tu tarea real, no solo el score general. Considera también el costo por tarea, el tiempo de procesamiento y la fecha de la evaluación, ya que los modelos evolucionan rápido.
Cómo usar este benchmark en la práctica
Si tu equipo trabaja con BIM y documentos de obra, Construction AI Leaderboard ofrece un punto de partida mejor que benchmarks genéricos. Pero tres cuidados son importantes.
Primero, el score general puede ocultar fuerza en un eje específico. Un modelo con 95,5 en presupuesto puede ser la mejor elección para un equipo de estimación, aunque no lidere en general. Segundo, los modelos open-weight necesitan infraestructura propia y ajuste de prompt, lo que tiene un costo oculto no reflejado en el ranking. Tercero, la evaluación se hizo en octubre de 2026 y los modelos evolucionan rápido; un resultado de hoy puede cambiar en semanas.
Para equipos que usan agentes de IA en el desarrollo de software, la lección es similar a la de otros benchmarks cubiertos en el blog, como el CloudOpsBench para operaciones de nube y el SuperCLUE de noviembre de 2026: mira a la tarea real, no al número agregado.
¿Tienes una idea de producto que necesita validación? Divide planificación, implementación y revisión entre especialistas y arma tu squad de agentes de IA en bridgecode.
Fuente: Hugging Face
Tags:#benchmark#construção#BIM#Claude Opus 5.5#Gemini 4 Argon#modelos de IA
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Benchmarks
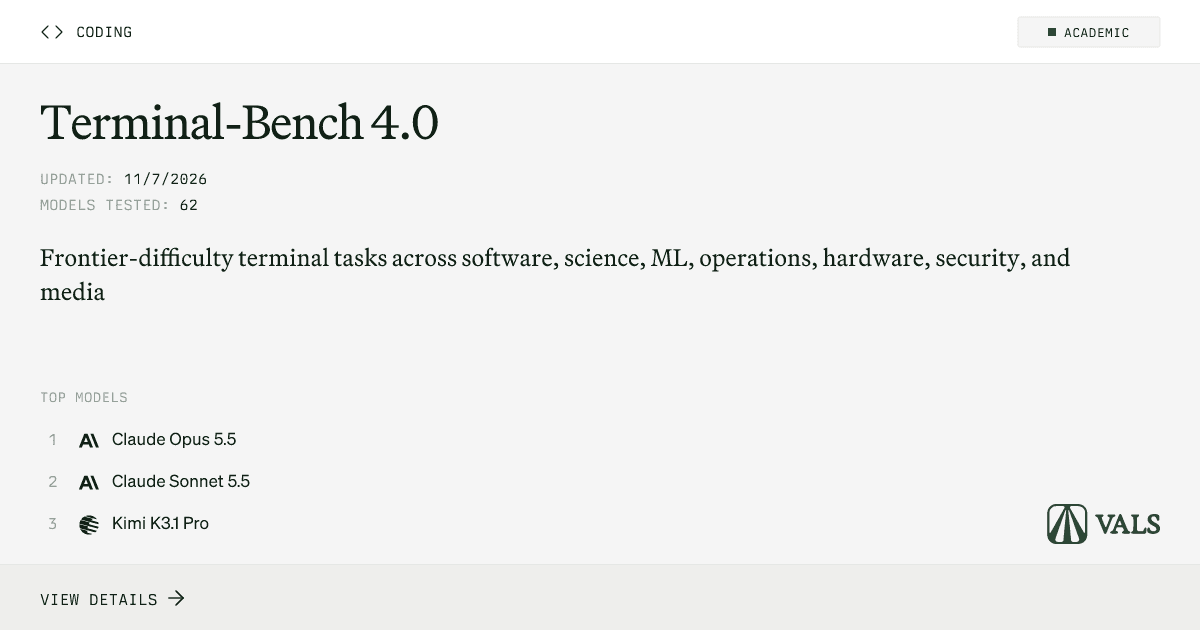
Terminal-Bench 4.0: Claude Opus 5.5 y Sonnet 5.5 lideran operaciones en terminal con 65%
Terminal-Bench 4.0 evalúa agentes de IA resolviendo problemas en terminal Linux real. Claude Opus 5.5 lidera con 65,15%, seguido por Sonnet 5.5 con 64,14%.
5 min
Benchmarks
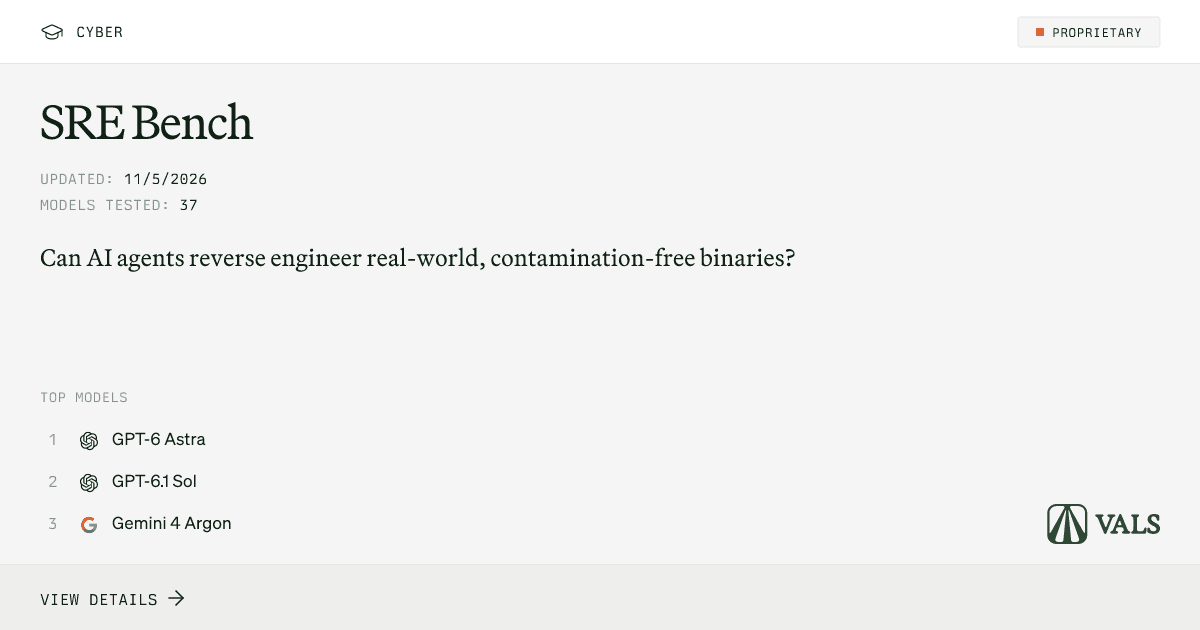
SRE Bench: ¿la IA hace ingeniería inversa de binarios?
SRE Bench prueba si los agentes de IA logran hacer ingeniería inversa de binarios sin código fuente. GPT-6 Astra lidera con 56,87%.
5 min
Benchmarks
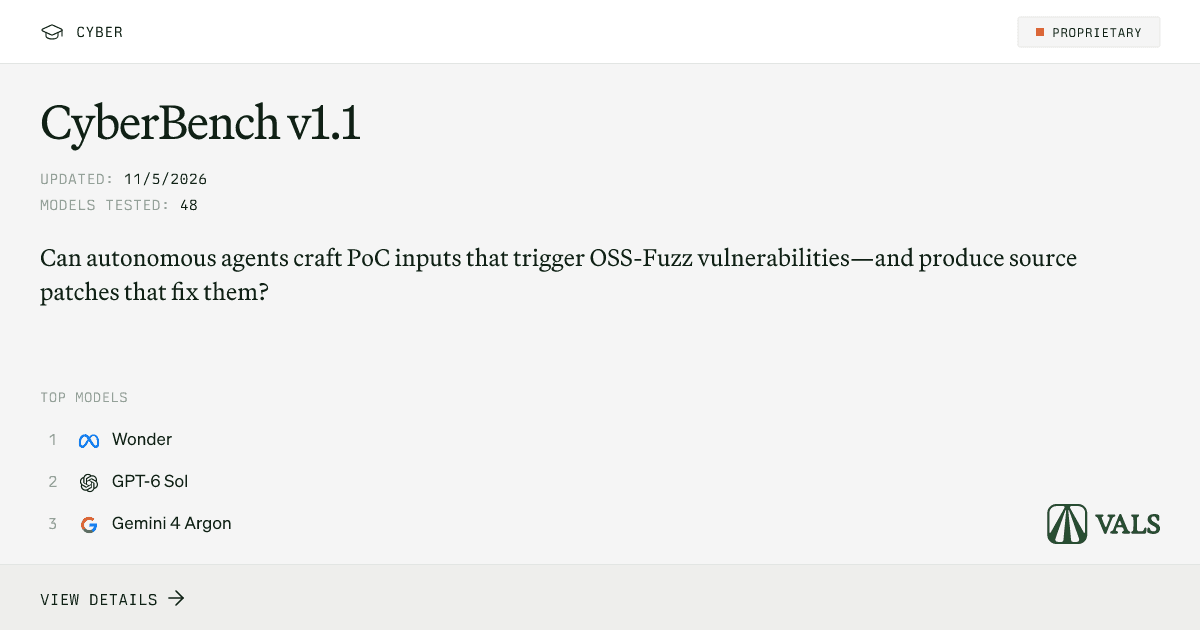
CyberBench: ¿la IA encuentra bugs de seguridad?
CyberBench prueba si los agentes de IA logran encontrar fallas de seguridad en código y producir parches. Wonder, de Meta, lidera con 80,36%.
5 min