
A Amazon publicou no blog do Hugging Face em 9 de novembro de 2026 o HOPE, um método de segunda ordem para podar experts em modelos Mixture of Experts. O objetivo é reduzir a memória sem destruir grupos de experts que cooperam entre si, algo que métodos anteriores ignoravam.
HOPE: podar experts em modelos MoE sem quebrar a cooperação
A Amazon publicou o HOPE, método de segunda ordem que poda experts em modelos MoE considerando a cooperação entre eles, com ganho de até 6,1% em código.

Marcelo Santiago
Criador do bridgecode
A maior newsletter de IA do Mundo
Receba artigos sobre IA no seu e-mail
Curadoria técnica sobre modelos, agentes e ferramentas de código. Sem spam, cancele quando quiser.
Modelos MoE alcançam desempenho de ponta com centenas de bilhões de parâmetros, mas cada expert ocupa memória. Podar experts é a forma mais direta de encolher o modelo, mas os métodos existentes decidem o corte de cada expert de forma independente, como se a contribuição de cada um fosse aditiva. Na prática, experts cooperam: remover um pode desmontar um circuito que dependia dele.
O que é o HOPE, o método de poda de segunda ordem da Amazon
HOPE significa Higher-Order Pruning of Experts. É um objetivo de poda de segunda ordem que considera as interações par a par entre experts ao decidir quais remover. A ideia central é que experts não trabalham sozinhos: padrões de co-seleção aparecem cedo no treinamento e se estabilizam ao longo dele.
Um método de primeira ordem pontua cada expert sozinho. Se o expert A parece dispensável, ele é removido. O problema aparece quando o expert B, que coopera frequentemente com A, é importante. Remover A desmonta o grupo cooperativo, e a queda de desempenho vai além do que a pontuação individual previa. Esse efeito se acumula em taxas agressivas de poda, de 40% a 50%, justamente onde a redução de memória mais importa para produção.
O paper mostra que o REAP, método de primeira ordem considerado estado da arte, é um caso especial do HOPE em que os termos de interação são zerados. Em outras palavras, o HOPE generaliza o REAP ao adicionar a matriz de interação entre experts.
Como o HOPE identifica o conjunto a podar
O HOPE formula a poda como a minimização de uma cota superior sobre o erro resultante da remoção. A matriz de interação F mede a cooperação par a par: F i,j é a média de g i(x) g j(x) nas entradas em que ambos os experts são selecionados, normalizada pelas normas de suas saídas. Quanto maior F i,j, mais os dois experts trabalham juntos.
Em vez de ordenar experts por uma pontuação individual, o HOPE busca o subconjunto cuja remoção minimiza p transposto F p, o erro de saída que o corte realmente causa. Isso captura o fato de que dois experts redundantes são baratos de remover juntos, enquanto dois complementares não são. Uma ordenação por expert não consegue distinguir os dois casos.
Na prática, o método poda cada camada de forma independente e não considera interações entre camadas. Isso mantém o custo computacional viável, mas é uma limitação declarada no paper.
Os resultados divulgados: +6,1% em código com 50% de poda
Os autores avaliaram o HOPE em modelos MoE de larga escala, incluindo GLM-4.7, Qwen3-Coder-480B e outras variantes. A métrica principal é a posição média entre os métodos comparados, com menor sendo melhor.
Com 50% de experts removidos, o HOPE obteve a melhor posição média entre todos os métodos testados. Em tarefas agênticas de código, o ganho chega a +6,1% sobre o segundo melhor método de poda. A vantagem é mais pronunciada em taxas altas, de 40% a 50%. Em taxas baixas, de 10% a 20%, métodos de primeira ordem como REAP e MAN às vezes são competitivos e a vantagem do HOPE encolhe.
A explicação é direta: quanto mais experts são removidos, mais interações são quebradas, e os termos fora da diagonal de F ganham peso. Em 50%, muitos pares cooperativos são rompidos ao mesmo tempo, e a pontuação individual não consegue prever nem prevenir esse dano.
Os ganhos também aparecem em tarefas de uso de ferramentas e múltipla escolha, com a vantagem aumentando conforme a taxa de poda cresce.
Limitações honestas do HOPE
O paper é claro sobre o que o método não faz. Primeiro, o HOPE poda cada camada de forma independente e não considera interações entre camadas. Segundo, a matriz F é estimada a partir de dados de calibração, então a qualidade depende da representatividade desses dados. Terceiro, a vantagem sobre métodos de primeira ordem é pequena em taxas baixas, onde a simplicidade do REAP pode bastar.
Também vale lembrar que o paper é da Amazon e os resultados são auto reportados, sem replicação independente até o momento. Quem quiser aplicar o HOPE deve validar no próprio conjunto de modelos e tarefas.
Como testar o HOPE hoje
O código do HOPE está disponível no repositório oficial da Amazon no GitHub, vinculado ao paper. A implementação trabalha sobre modelos MoE hospedados no Hugging Face, como Qwen3-Coder e GLM, e permite reproduzir os experimentos com dados de calibração fornecidos.
Para quem quer avaliar poda de experts em um modelo próprio, o fluxo é: escolher o modelo MoE, coletar dados de calibração representativos, calcular a matriz F por camada e rodar o HOPE com a taxa de poda desejada. Compare com o REAP no mesmo conjunto de avaliação antes de decidir.
Os checkpoints podados publicados pela Amazon no Hugging Face permitem testar o resultado sem rodar a poda do zero.
Perguntas frequentes sobre o HOPE para poda de experts em modelos MoE
O que é o HOPE?
HOPE significa Higher-Order Pruning of Experts. É um método de segunda ordem para podar experts em modelos Mixture of Experts, considerando as interações par a par entre experts.
Por que a cooperação entre experts importa na poda?
Experts cooperam em grupos. Remover um expert individual pode desmontar um circuito que dependia dele, causando queda de desempenho maior do que a pontuação individual previa.
O REAP é um caso especial do HOPE?
Sim. O HOPE generaliza o REAP ao adicionar a matriz de interação entre experts. O REAP é o caso em que os termos de interação são zerados.
Quanto o HOPE melhora em relação a outros métodos?
Com 50% de experts removidos, o HOPE obteve a melhor posição média entre os métodos testados, com ganho de até 6,1% em tarefas agênticas de código sobre o segundo melhor método.
Quais são as limitações do HOPE?
O HOPE poda cada camada de forma independente, sem considerar interações entre camadas. A matriz de interação depende dos dados de calibração, e a vantagem é pequena em taxas baixas de poda.
Conclusão: poda que respeita a cooperação entre experts
O HOPE não substitui a poda de primeira ordem em todos os casos, mas mostra que ignorar a cooperação entre experts custa desempenho, principalmente em taxas agressivas. A ideia de tratar a poda como um problema de interação, e não de pontuação individual, muda como pensamos sobre compressão de modelos MoE.
Para quem roda modelos MoE em produção com restrição de memória, o HOPE é um candidato sério a testar, especialmente quando a meta é cortar metade dos experts sem perder qualidade em código. Quem acompanha a corrida dos modelos abertos também pode comparar com a análise sobre como modelos open-source fecham a lacuna em cibersegurança e com o caso do Arete-27B, que reeduca o Qwen para valores ocidentais.
Fonte: Hugging Face
Tags:#MoE#pruning#HOPE#Amazon#modelos abertos
Desenvolvedor e criador do bridgecode, ambiente de desenvolvimento agêntico para orquestrar squads de agentes de IA. Ajuda quem vai do vibe coding ao desenvolvimento profissional a sair da ideia e chegar ao produto entregue.
Artigos relacionados
Newsletter
Automattic une apps de vibe coding em uma plataforma para publicar no mundo web
Automattic une apps de vibe coding em uma plataforma para publicar apps no mundo web. Veja como funciona e o que muda para equipes que criam com IA.
4 min
Newsletter
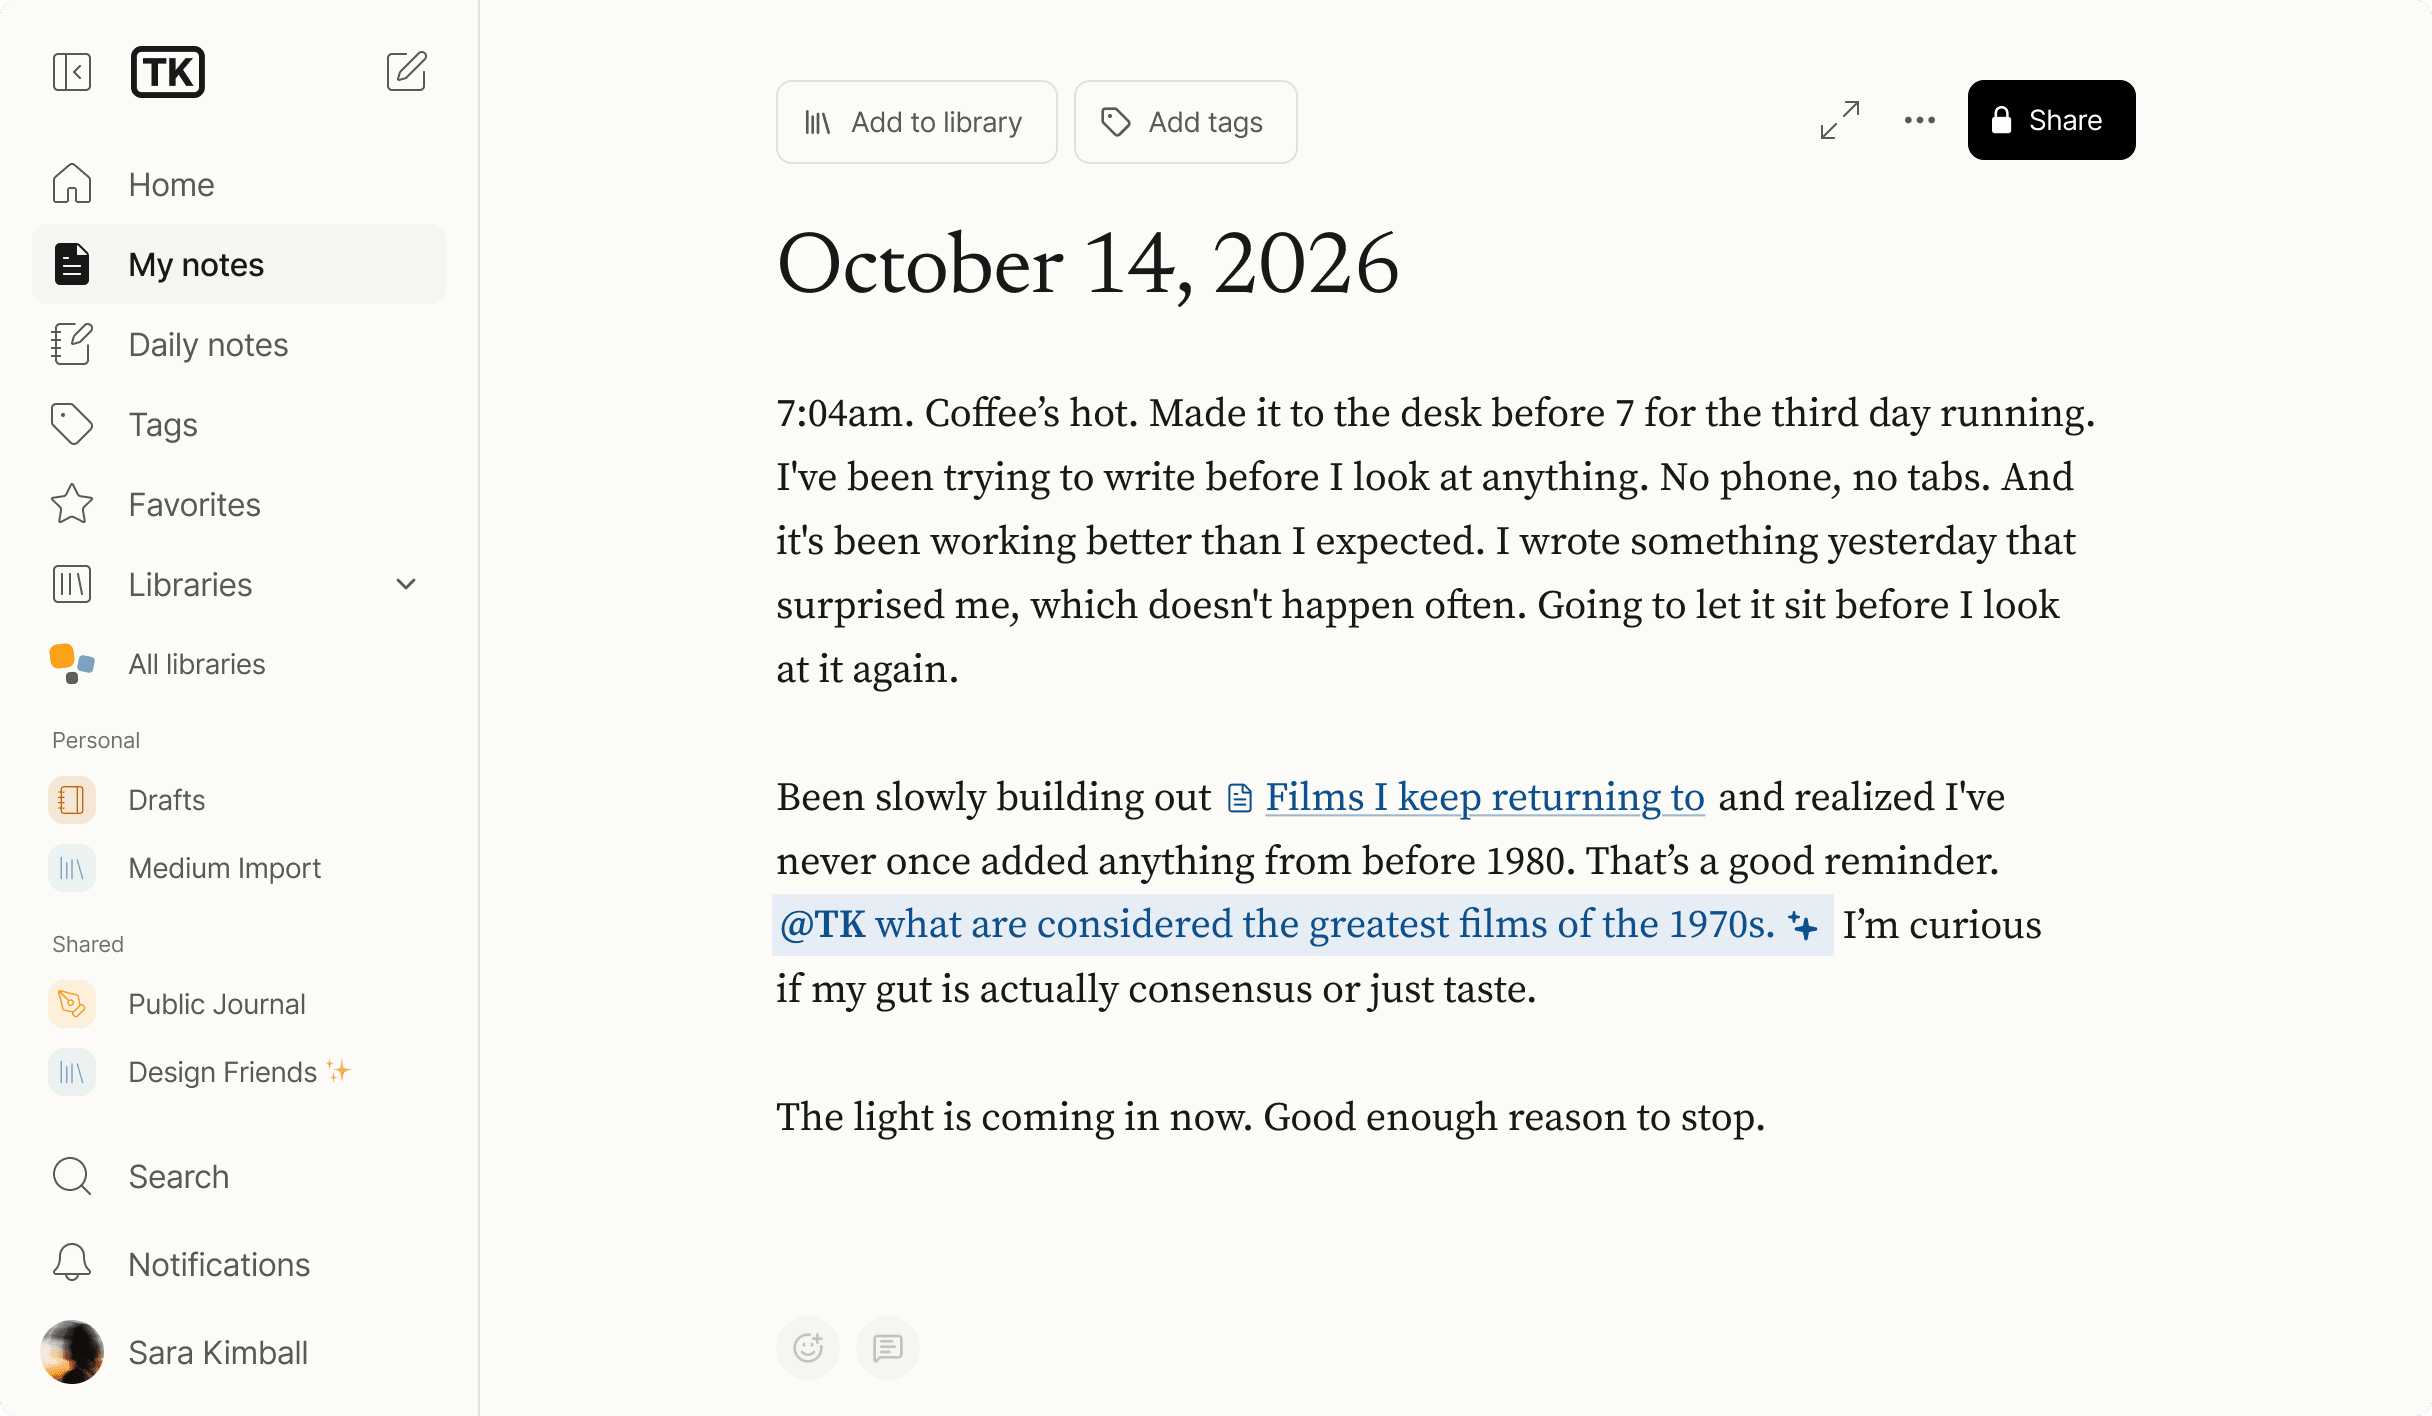
Medium lança TK, app de notas com IA no editor
O Medium lançou o TK, um app de notas e escrita com assistente de IA embutido no editor. Veja como funciona e o que muda para quem escreve.
6 min
Newsletter
Otter.ai lança maior expansão multilíngue da sua história
O Otter.ai anunciou 27 novos idiomas e transcrição multilíngue que acompanha a troca de idioma dentro de uma mesma reunião. Veja o que muda e como testar.
6 min