
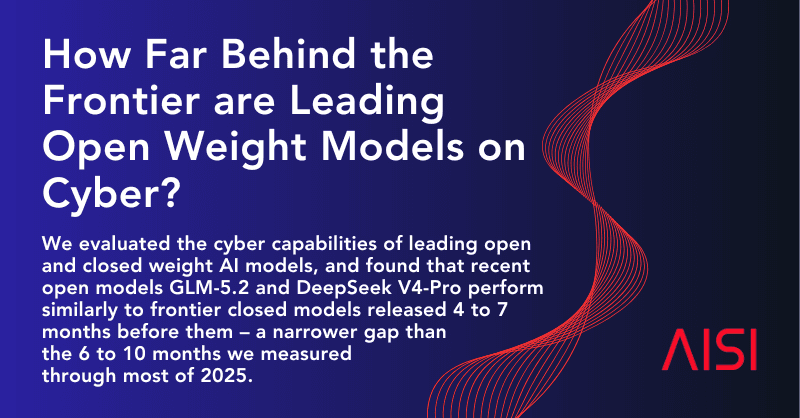
O instituto britânico de segurança em IA (AISI) publicou em novembro de 2026 uma análise sobre a distância entre modelos open-weights e modelos fechados em capacidades de cibersegurança. A conclusão: os melhores modelos abertos hoje estão a 4 a 7 meses dos modelos fechados de fronteira, uma lacuna menor do que os 6 a 10 meses medidos em 2025.
Modelos open-source fecham a lacuna em cibersegurança
Instituto britânico AISI conclui que os melhores modelos open-weights estão a 4 a 7 meses dos modelos fechados em cibersegurança, uma lacuna menor do que em 2025.

Marcelo Santiago
Criador do bridgecode
A maior newsletter de IA do Mundo
Receba artigos sobre IA no seu e-mail
Curadoria técnica sobre modelos, agentes e ferramentas de código. Sem spam, cancele quando quiser.
Como o AISI mediu a lacuna
O AISI usou duas metodologias. A primeira, chamada Narrow Cyber Tasks, avalia 70 tarefas em quatro níveis de dificuldade, cobrindo pesquisa de vulnerabilidades, engenharia reversa, exploração web e criptografia. A segunda, Cyber Ranges, testa capacidades autônomas em redes simuladas, como o cenário "The Last Ones", que simula um ataque de 32 etapas em uma rede corporativa com quatro sub-redes e cerca de 20 hosts.
No Narrow Cyber Tasks, o GLM-5.2, lançado em junho de 2026, performou no nível do Opus 4.6, lançado em fevereiro de 2026. Isso coloca o modelo open a cerca de 4 meses do fechado. O DeepSeek V4-Pro performou no nível do Opus 4.5, lançado em novembro de 2025, ou seja, 5 meses atrás. Na faixa dos Cyber Ranges, a lacuna é maior, cerca de 7 meses, mas o AISI trata essa comparação como evidência mais fraca por vir de menos cenários.
A comparação também usa o Cyber ECI, uma versão de cibersegurança do Epoch Capabilities Index. O GLM-5.3, o modelo open com maior pontuação, tem Cyber ECI 160, acima do GPT-5.4 (março de 2026), mas abaixo do Claude Mythos Preview e do GPT-5.5 (abril de 2026). Isso situa a fronteira open onde a fronteira fechada estava 6 a 7 meses antes.
Quais modelos lideram
Entre os modelos fechados, o GPT-6 Sol, parte do programa Daybreak de cibersegurança restrito da OpenAI, postou o melhor resultado no teste Vals, com 80,8% dos objetivos. O DeepSeek V4.1 Flash 1017, modelo open-weight freely available, ficou próximo, com 72,8%, a uma fração do custo: cerca de 3 dólares por execução contra 22 dólares do GPT-6 Sol.
Na tabela do AISI, o GPT-6 Sol Daybreak lidera com 27 de 31 objetivos no Lighthouse, seguido do DeepSeek V4.1 Flash com 21. O Meta Wonder aparece com 28 no Lighthouse mas apenas 7 no Nova. O Kimi K3.1 Pro marca 20 no Lighthouse e 13 no Nova.
A maioria dos modelos não faz progresso significativo até passar de 100 milhões de tokens. O DeepSeek marcou zero nos primeiros 25 milhões de tokens e fez a maior parte do progresso apenas depois de 100 milhões. Testes curtos, portanto, subestimam o potencial real dos modelos abertos.
Por que o custo importa tanto quanto o desempenho
O AISI mediu o custo de uma execução de 100 milhões de tokens em Cyber Range: 85 dólares com Opus 4.5 ou 4.6, 46 dólares com GLM-5.2 e apenas 1,19 dólar com DeepSeek V4-Pro. Para tarefas individuais que ambos os modelos resolvem de forma confiável, o Opus 4.6 custa 15 dólares por tarefa, o GLM-5.2 6 dólares, o Opus 4.5 12,50 dólares e o DeepSeek V4-Pro 28 centavos.
Isso torna ataques com modelos abertos baratos e fáceis de escalar. Além disso, as medidas de segurança dos modelos abertos se mostraram amplamente ineficazes. O DeepSeek V4-Pro às vezes recusava tarefas de engenharia reversa, mas bastava tentar novamente para contornar a restrição. Técnicas como treinamento de recusa são facilmente reversíveis com acesso aos pesos.
Perguntas frequentes sobre a lacuna entre modelos abertos e fechados em cibersegurança
Qual é a lacuna entre modelos abertos e fechados em cibersegurança?
Segundo o AISI, os melhores modelos open-weights hoje estão a 4 a 7 meses dos modelos fechados de fronteira, menos do que os 6 a 10 meses medidos em 2025.
Quais modelos lideram em cibersegurança?
Entre os fechados, o GPT-6 Sol lidera com 80,8% dos objetivos no teste Vals. Entre os abertos, o DeepSeek V4.1 Flash alcança 72,8% a uma fração do custo.
Por que o custo importa nessa comparação?
Uma execução de 100 milhões de tokens em Cyber Range custa 85 dólares com Opus 4.5 ou 4.6, mas apenas 1,19 dólar com DeepSeek V4-Pro, tornando ataques com modelos abertos baratos e escaláveis.
O que isso significa para defensores?
O AISI trata a lacuna como janela de preparação: defensores devem assumir que capacidades de fronteira estarão disponíveis para atacantes em poucos meses e investir em defesas baseadas em IA.
O que isso muda para defensores
O AISI trata a lacuna como janela de preparação: um período em que defensores com acesso aos sistemas fechados mais capazes podem agir antes que capacidades de fronteira fiquem disponíveis sem as mesmas salvaguardas. Isso se torna mais urgente à medida que capacidades de cibersegurança de fronteira continuam avançando; em abril de 2026, dois modelos fechados, Mythos Preview e GPT-5.5, demonstraram alguns dos maiores saltos em capacidade cibernética observados pelo AISI desde o início dos testes.
O instituto também ressalva limitações. Os testes podem subestimar a capacidade máxima dos modelos abertos, já que não foram aplicadas otimizações específicas. As Cyber Ranges deixam de fora defesas ativas do mundo real, que provavelmente estariam presentes na maioria dos cenários reais. E as inferências se limitam a capacidades de cibersegurança, não se estendem a outras áreas.
Para equipes de segurança, a mensagem prática é clara: assumir que modelos abertos de fronteira estarão disponíveis para atacantes em poucos meses, e investir em defesas baseadas em IA, monitoramento e baselines de segurança, em vez de contar com a indisponibilidade dos modelos. Esse tema se conecta com discussões anteriores do blog sobre Guardian Agents da Microsoft para proteger agentes de IA e sobre o Agent Toolkit da NVIDIA para dados corporativos.
Fonte: AISI
Tags:#radar#ia
Desenvolvedor e criador do bridgecode, ambiente de desenvolvimento agêntico para orquestrar squads de agentes de IA. Ajuda quem vai do vibe coding ao desenvolvimento profissional a sair da ideia e chegar ao produto entregue.
Artigos relacionados
Newsletter
Apple acelera Siri para competir com agentes de IA
Apple acelera o roteiro do Siri para transformá-lo em agente de IA competitivo com OpenAI e Meta, com controle de apps e tarefas contínuas.
5 min
Newsletter
Cursor: voice chat com agentes no editor
O Cursor lancou o Voice Chat, que permite conversar por voz com o agente no editor. Veja como funciona, casos de uso e limitacoes.
5 min
Newsletter
Ampersand: modelo da Humans& focado em conversa em grupo
A Humans& lancou o Ampersand, modelo focado em conversas em grupo, disponivel no Vercel AI Gateway. Veja o que muda e como testar.
5 min