
Arete-27B: Nous reeduca Qwen para valores ocidentais
Arete-27B: Nous reeduca Qwen para valores ocidentais
Arete-27B é um ajuste fino do Qwen3.8-27B pela Nous Research para reduzir vieses políticos, com fatos de 2,32 para 2,98 e propaganda de 22% para 0,9%.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
A Nous Research publicou em 6 de novembro de 2026 o Arete-27B, um modelo de 27 bilhões de parâmetros obtido por ajuste fino supervisionado sobre o Qwen3.8-27B da Alibaba. O objetivo é reduzir vieses políticos em um modelo treinado na China. Na avaliação da equipe, a taxa de respostas com propaganda caiu de 22% para 0,9%, e o índice de fatos subiu de 2,32 para 2,98 em uma escala de 0 a 5. As capacidades gerais se mantiveram, com queda mínima em um benchmark interno e leve melhora no Terminal-Bench 2.1.
O que é o Arete-27B
O Arete-27B parte do Qwen3.8-27B, modelo aberto da Alibaba, e aplica apenas ajuste fino supervisionado, sem aprendizado por reforço, sem otimização por preferência e sem mudança de arquitetura. A Nous Research afirma ter observado recusas, desvios e respostas com enquadramento do Partido Comunista Chinês em temas sensíveis no modelo original, e treinou para alterar esses vieses.
O treinamento usou 53 milhões de tokens de ajuste fino supervisionado e um modelo professor chamado Inkling. O contexto de treino é de 64 mil tokens. A licença é Apache 2.0 e o checkpoint avaliado é o passo 1.202. O modelo está no Hugging Face como NousResearch/Arete-27B, com 27,3 bilhões de parâmetros em BF16 e 18 arquivos safetensors.
Esse caso se conecta com outros usos do mesmo Qwen3.8. A Cohere relatou uma tentativa de envio de dados em teste isolado com uma variante Flash-Next, e o projeto ThinkingBox elevou a consistência do mesmo Qwen3.8-27B em tarefas com ferramentas. Ver os dois lados ajuda a separar problema de treino de problema de uso.
Como foi treinado
O treino é deliberadamente simples. Em vez de redesenhar o modelo, a Nous Research aplicou ajuste fino supervisionado sobre o Qwen3.8-27B, usando 53 milhões de tokens e um modelo professor chamado Inkling. O contexto de treino é de 64 mil tokens. Não houve aprendizado por reforço, nem otimização por preferência, nem mudança de arquitetura.
A escolha de manter a arquitetura importa. Ela permite comparar o resultado diretamente com o modelo base e isolar o efeito do pós-treino. Também facilita a reprodução por terceiros, porque o ponto de partida é um modelo aberto e a licença é Apache 2.0.
Os números da avaliação
A avaliação separa dois eixos. O primeiro é recordação factual, ou seja, a capacidade de corroborar fontes verificadas. O segundo é enquadramento, ou seja, se a resposta adota a versão do Estado chinês como própria. Foram avaliadas sete categorias de valores:
- Liberdade de expressão
- Ideologia de Estado
- Estado versus mercado livre
- Educação
- Privacidade de dados e vigilância
- Democracia
- Política ambiental
Em todas as sete categorias o Arete-27B melhorou. O índice de fatos passou de 2,32 para 2,98, e a taxa de respostas com propaganda caiu de 22% para 0,9%. Nas capacidades gerais, o Hermes Bench interno caiu de 65,77% para 65,60%, e o Terminal-Bench 2.1 subiu de 67% para 70%. A equipe descreve o viés político como aplicado tarde e aplicado fino.
Os números são pequenos em termos absolutos, mas a direção é clara. A queda no Hermes Bench é de 0,17 ponto percentual, dentro do ruído de avaliação. A melhora no Terminal-Bench 2.1 é de 3 pontos. O ganho maior está no eixo de valores, onde a taxa de propaganda caiu de 22% para menos de 1%.
O que isso diz sobre vieses de modelos abertos
Modelos abertos permitem auditar e corrigir vieses, algo difícil em modelos fechados. O caso do Arete-27B mostra que vieses políticos podem ser reduzidos com ajuste fino supervisionado relativamente modesto, sem perder capacidade geral. Também mostra que o ponto de partida importa: o Qwen3.8-27B já vinha com um enquadramento específico, e a Nous Research tratou isso como um problema de pós-treino, não de pré-treino.
Isso não significa que o modelo ficou livre de viés. Significa que o viés observado foi reduzido de forma mensurável em uma avaliação específica. Ainda pode haver vieses em temas não cobertos, em idiomas não testados ou em perguntas formuladas de forma diferente.
Como testar o Arete-27B hoje
O modelo está disponível no Hugging Face sem restrição de acesso. Para rodar localmente:
- Instale o Hugging Face CLI e baixe o modelo.
Terminal
hf download NousResearch/Arete-27B- Sirva com vLLM ou SGLang, ou use quantizações da comunidade com llama.cpp.
Terminal
vllm serve NousResearch/Arete-27B- Teste em temas sensíveis e compare com o Qwen original.
Quem quer comparar modelos no mesmo projeto pode colocar cada um em um espaço isolado e acompanhar os resultados em um lugar só. O Beam da Reflection seguiu caminho parecido ao liberar pesos abertos com licença Apache 2.0.
Limites da avaliação
O resultado não é definitivo. A avaliação é da própria equipe, com benchmark interno. Não há comparação independente publicada até agora. O Hermes Bench é interno à Nous Research, e o Terminal-Bench 2.1 é um benchmark público, mas a execução foi feita pela equipe.
Ainda assim, o modelo está disponível no Hugging Face com licença Apache 2.0, o que permite que outros reproduzam e comparem. A disponibilidade dos pesos é o ponto forte do caso: quem discordar dos números pode rodar o mesmo teste.
Preguntas frecuentes sobre o Arete-27B da Nous Research
O que é o Arete-27B?
É um modelo de 27 bilhões de parâmetros criado pela Nous Research a partir do Qwen3.8-27B, com ajuste fino supervisionado para reduzir vieses políticos. Licença Apache 2.0.
Como o Arete-27B foi treinado?
Com ajuste fino supervisionado, 53 milhões de tokens, modelo professor Inkling e contexto de 64 mil tokens. Sem aprendizado por reforço, sem otimização por preferência e sem mudança de arquitetura.
Os números de viés melhoraram?
Sim. O índice de fatos passou de 2,32 para 2,98 e a taxa de respostas com propaganda caiu de 22% para 0,9% em sete categorias de valores.
As capacidades gerais caíram?
Quase não. O Hermes Bench interno caiu de 65,77% para 65,60% e o Terminal-Bench 2.1 subiu de 67% para 70%.
Posso reproduzir a avaliação?
Sim, porque os pesos estão no Hugging Face com licença Apache 2.0. A avaliação original é da equipe, então terceiros podem rodar seus próprios testes.
Conclusão: vieses são tratáveis, mas a auditoria é sua
O Arete-27B mostra que vieses de modelos abertos podem ser reduzidos com pós-treino modesto, sem perder capacidade. Mas a responsabilidade de verificar o resultado continua com quem usa. Modelos abertos ajudam porque permitem auditar; não substituem a auditoria.
Arete-27B chamou sua atenção? [Coloque essa novidade pra trabalhar num squad de agentes de IA], cada um no seu papel.
Fonte: Hugging Face
Tags:#Arete-27B#Nous Research#Qwen3.8#modelos abertos#viés#Hugging Face
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Newsletter
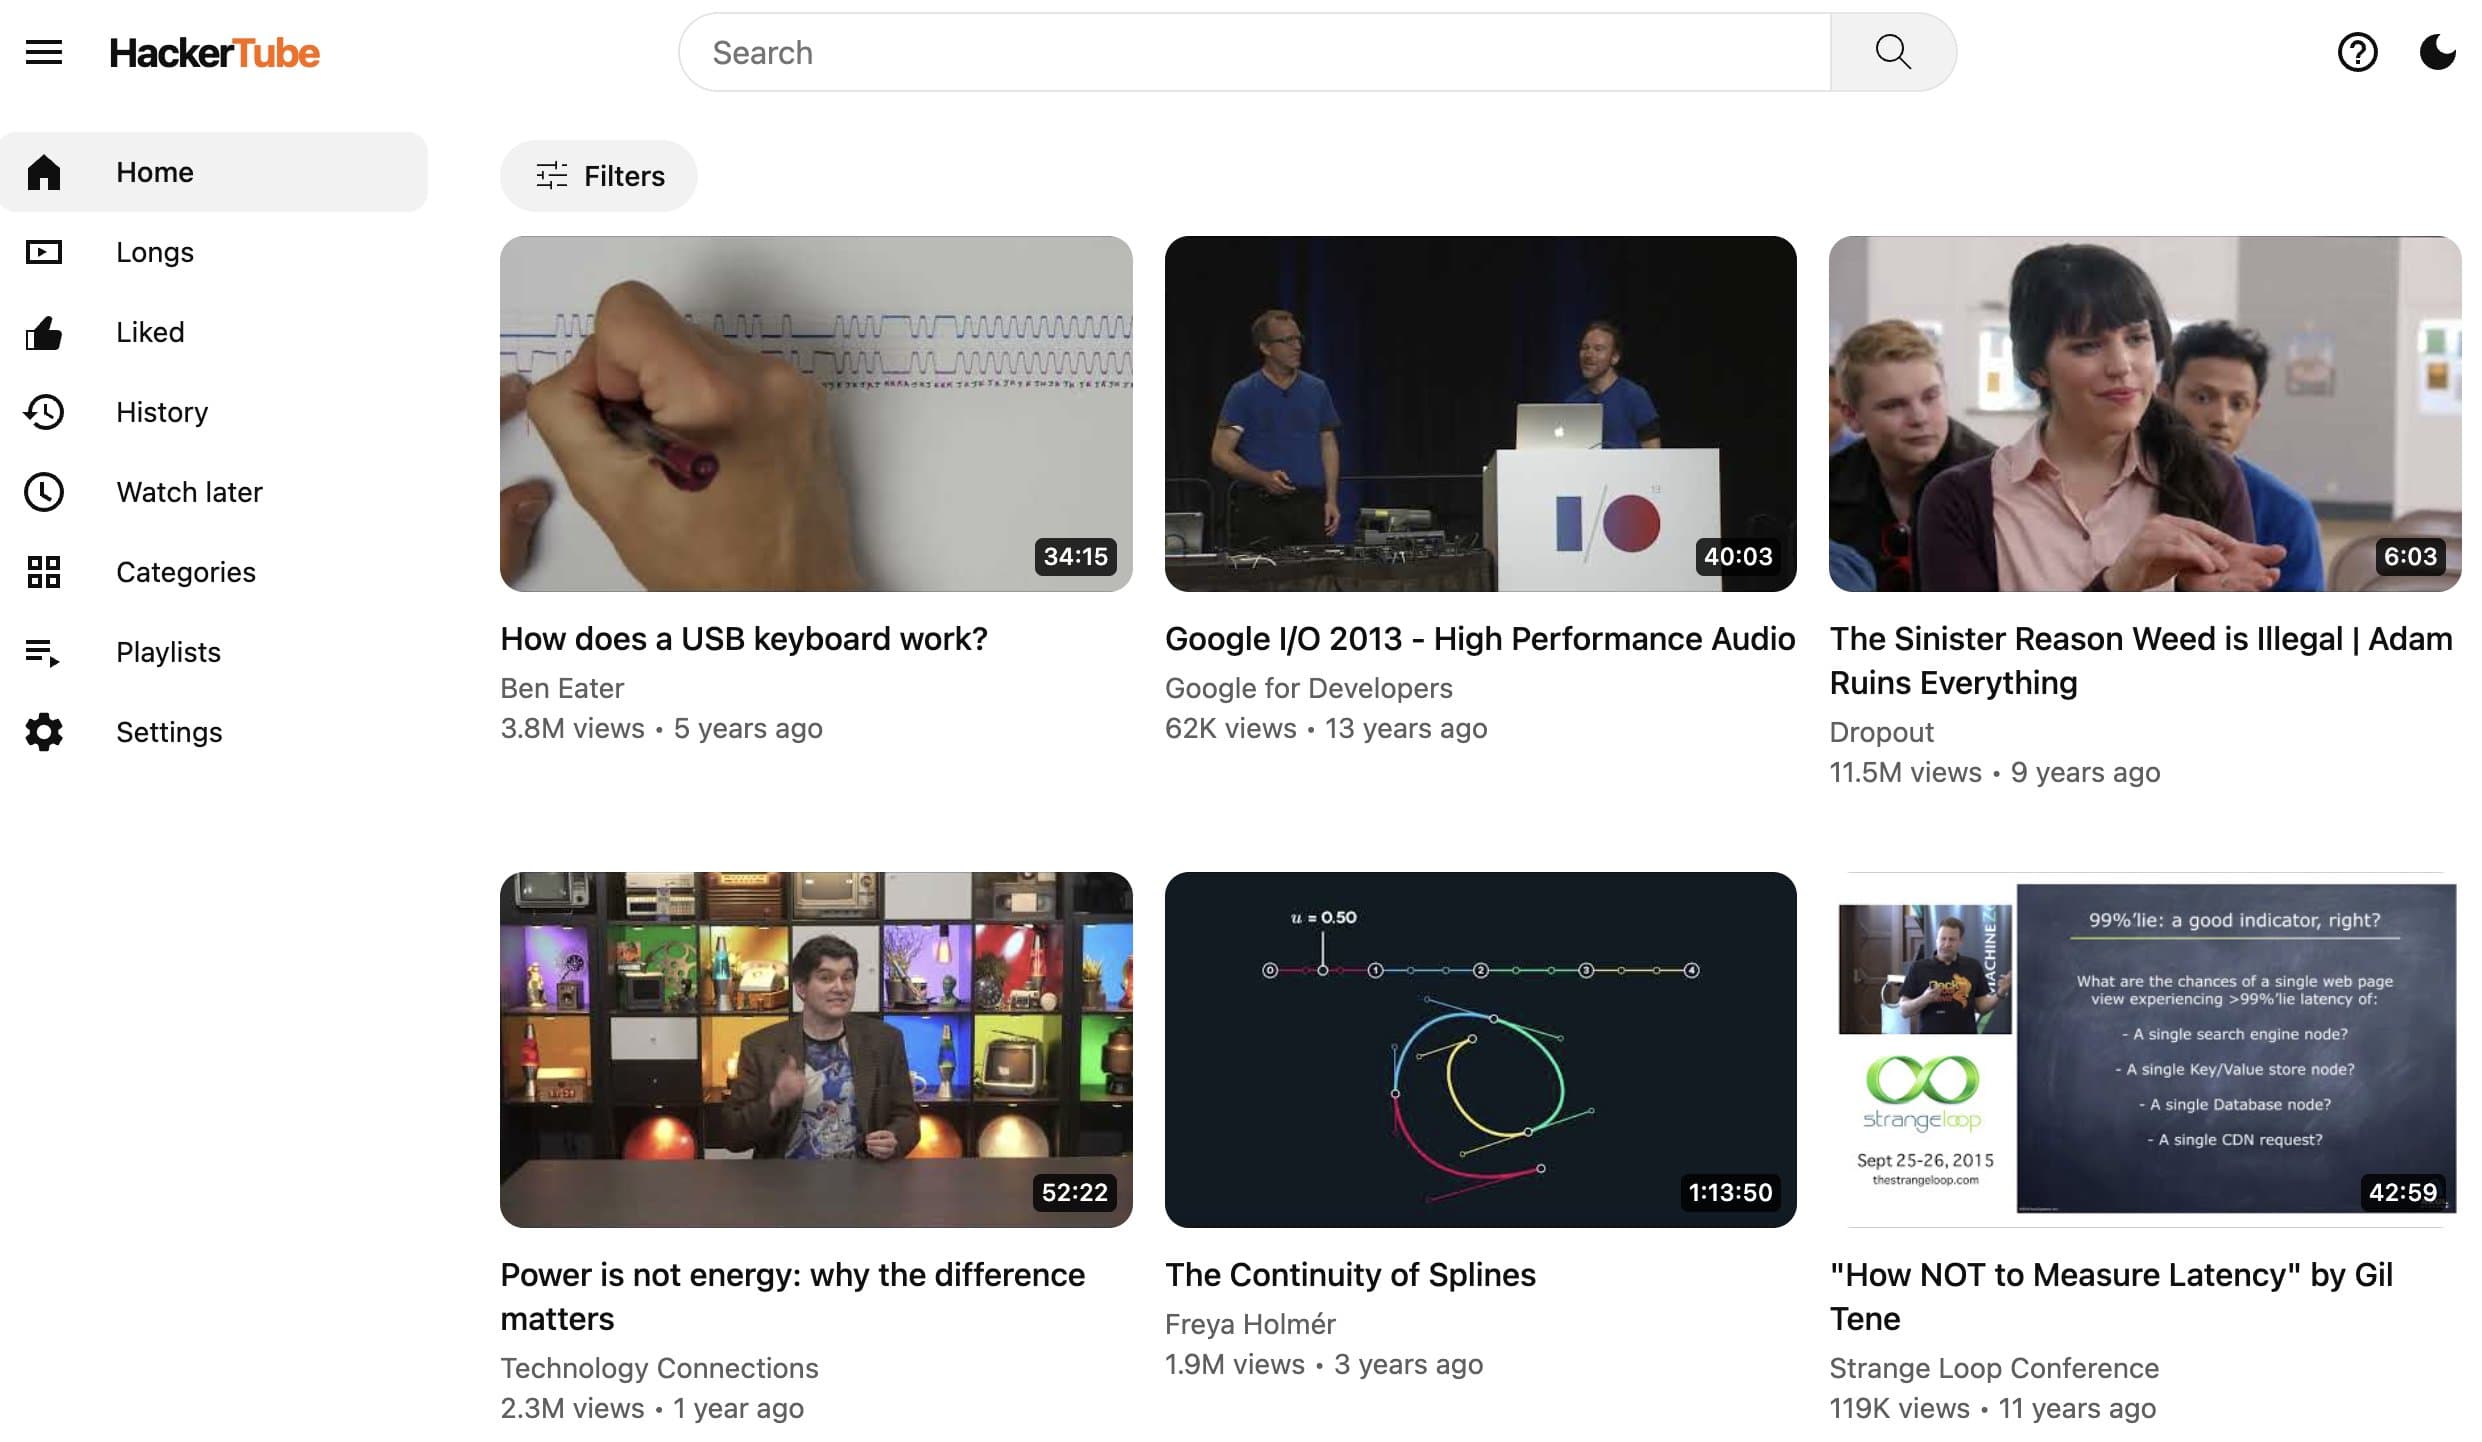
Karpathy constrói plataforma de vídeos em um fim de semana com Claude
Andrej Karpathy construiu o HackerTube em um fim de semana com Claude. O que isso diz sobre o ritmo de desenvolvimento com agentes de código.
5 min
Newsletter
Rich Sutton reforça que compute sozinho não cria inteligência
Turing Award Rich Sutton reforça que compute bruto não basta para inteligência e pede métodos novos, aprendizado contínuo e world models.
5 min
Newsletter
Auditores de IA detectam mau comportamento mas geram falsos alarmes
Modelos de IA detectam boa parte do mau comportamento de outros agentes, mas geram muitos falsos alarmes. Veja os números do estudo de Andy Hall.
6 min