
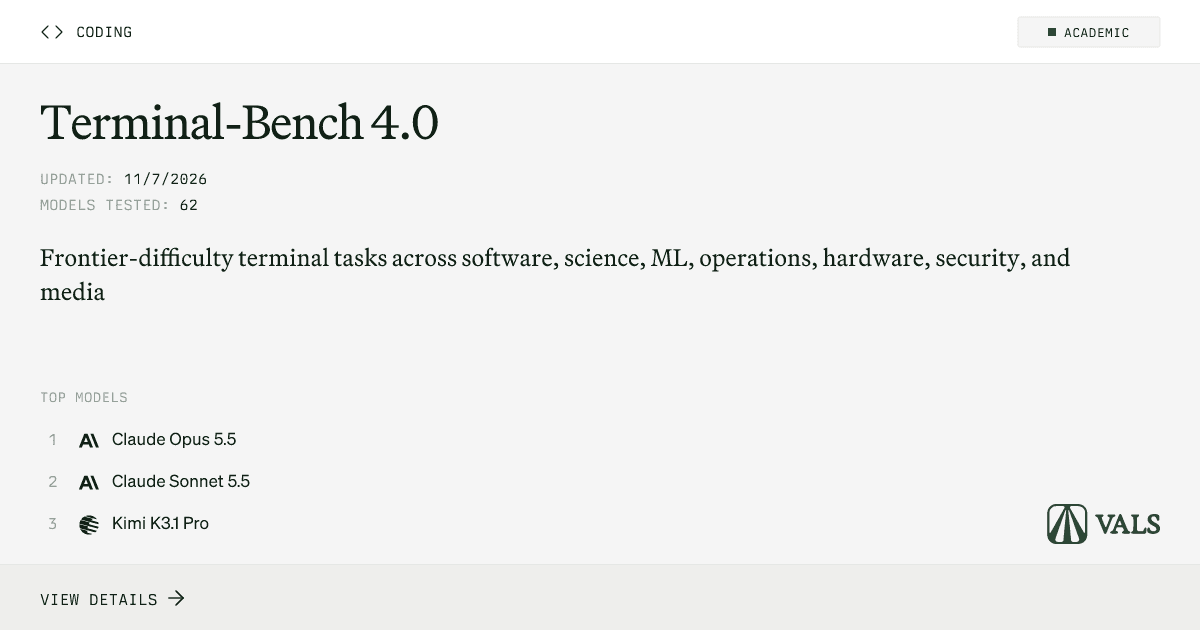
A Vals AI publicou os resultados atualizados do Terminal-Bench 4.0, uma das avaliações mais rigorosas para agentes autônomos que operam diretamente na linha de comando de sistemas Linux. Os dados revelam que o Claude Opus 5.5 e o Claude Sonnet 5.5 conquistaram o topo da tabela, atingindo respectivamente 65,15% e 64,14% de taxa de resolução de problemas de engenharia e infraestrutura.
InícioBlogBenchmarksTerminal-Bench 4.0: Claude Opus 5.5 e Sonnet 5.5 lideram operações em terminal com 65%
Benchmark5 min
Terminal-Bench 4.0: Claude Opus 5.5 e Sonnet 5.5 lideram operações em terminal com 65%
O Terminal-Bench 4.0 avalia agentes de IA resolvendo problemas em terminal Linux real. Claude Opus 5.5 lidera com 65,15%, seguido por Sonnet 5.5 com 64,14%.

Marcelo Santiago
Criador do bridgecode
A maior newsletter de IA do Mundo
Receba artigos sobre IA no seu e-mail
Curadoria técnica sobre modelos, agentes e ferramentas de código. Sem spam, cancele quando quiser.
Diferente de avaliações sintéticas que apenas validam respostas de código em caixas isoladas, o Terminal-Bench coloca os modelos diante de ambientes com sistemas de arquivos reais, ferramentas de linha de comando (git, bash, compilers, debuggers) e restrições práticas de execução.
O que o Terminal-Bench 4.0 avalia
O benchmark simula tarefas reais enfrentadas por engenheiros de software, administradores de sistemas e especialistas em DevOps no dia a dia de servidores e repositórios de código aberto:
- Investigação de falhas: diagnosticar por que um serviço falhou ao iniciar usando logs do systemd e utilitários de rede.
- Compilação e build: configurar toolchains, resolver dependências ausentes e corrigir erros de compilação em C, Rust e Python.
- Manipulação de dados e texto: filtrar e transformar grandes volumes de registros usando comandos UNIX como grep, sed, awk e jq.
- Automação de repositórios: operações complexas de git, resolução de conflitos de merge e aplicação de patches.
Para comparar com testes de segurança cibernética e engenharia reversa no mesmo ecossistema, veja também nossa análise do SRE Bench da Vals AI.
Como funciona a metodologia com Mini-SWE-agent
Todos os testes são executados através do harness Mini-SWE-agent, um ambiente controlado que concede ao agente uma sessão bash interativa com permissões limitadas dentro de containers Docker efêmeros.
A cada turno de conversação, o modelo:
- Emite um comando no terminal (ex.:
cat /var/log/nginx/error.logoupytest -q). - Recebe a saída do stdout e stderr do shell.
- Analisa os resultados e planeja a próxima ação corretiva.
- Conclui com um comando de finalização quando a tarefa é cumprida.
A avaliação valida o estado final do sistema operacional executando uma suíte determinística de testes automatizados e asserções que o agente não tem acesso para inspecionar.
O ranking de líderes do Terminal-Bench 4.0
A tabela de resultados consolidados da Vals AI traz um panorama competitivo acirrado entre as famílias de modelos de ponta:
| Posição | Modelo | Harness | Taxa de Resolução | Custo Médio / Teste | Tokens / Teste | Duração Média |
|---|---|---|---|---|---|---|
| 1 | Claude Opus 5.5 | Mini-SWE-agent | 65,15% | $12,04 | 28,27m | 1h04m |
| 2 | Claude Sonnet 5.5 | Mini-SWE-agent | 64,14% | $10,75 | 58,53m | 1h22m |
| 3 | Kimi K3.1 Pro | Mini-SWE-agent | 63,64% | $4,57 | 16,57m | 49m21s |
| 4 | Gemini 4 Carbon | Mini-SWE-agent | 63,13% | $7,45 | 12,46m | 45m07s |
| 5 | GPT-6 Astra | Mini-SWE-agent | 59,60% | $9,58 | 3,01m | 35m42s |
| 6 | Claude Fable 5.1 | Mini-SWE-agent | 58,08% | $17,18 | 18,82m | 1h00m |
| 7 | Wonder Full | Mini-SWE-agent | 58,08% | $10,53 | 31,82m | 1h12m |
| 8 | Gemini 4 Argon | Mini-SWE-agent | 57,58% | $17,64 | 16,66m | 53m35s |
| 9 | GPT-6.1 Sol | Mini-SWE-agent | 55,05% | $1,72 | 2,86m | 45m12s |
Os dados revelam que o Claude Sonnet 5.5 oferece quase o mesmo desempenho do Opus 5.5 (64,14% contra 65,15%) com menor custo financeiro por execução. Já o Kimi K3.1 Pro surpreendeu ao figurar na 3ª posição custando apenas $4,57 por teste, menos da metade do Claude Opus. Para uma análise complementar sobre benchmarks que testam códigos em repositórios reais, confira o guia do SWE-bench Pro.
Eficiência de tokens e tempo de resolução
Além da taxa de acerto bruta, o Terminal-Bench 4.0 mede o comportamento operacional dos modelos:
- GPT-6 Astra é o mais veloz e econômico em tokens, consumindo apenas 3,01 milhões de tokens e completando o ciclo em 35 minutos.
- Claude Sonnet 5.5 usa um raciocínio iterativo mais longo (58,53 milhões de tokens), explorando ativamente comandos de diagnóstico antes de tomar decisões definitivas.
- GPT-6.1 Sol registrou o menor custo financeiro absoluto ($1,72 por teste), embora com uma taxa de resolução 10% inferior aos líderes.
Como rodar agentes em terminais paralelos no bridgecode
O grande desafio de operar agentes em terminais reais é evitar que uma sessão trave o seu ambiente ou gere alterações conflitantes no seu branch de trabalho.
Com o bridgecode, você tem terminais dedicados para cada CLI (Claude Code, OpenCode, Codex e Antigravity), operando em git worktrees separadas. Isso permite rodar um agente executando comandos pesados em segundo plano enquanto você continua programando sem interrupções. Explore o ecossistema bridgecode para colocar squads de agentes para trabalhar nos seus projetos.
Perguntas frequentes sobre o Terminal-Bench 4.0
O que é o Terminal-Bench 4.0 da Vals AI?
É um benchmark rigoroso que avalia a capacidade de modelos e agentes de IA de operarem diretamente em terminais Linux reais para diagnosticar falhas de sistema, compilar código e resolver tarefas de DevOps.
Quais modelos lideram o Terminal-Bench 4.0?
Claude Opus 5.5 lidera com 65,15% de taxa de resolução, seguido de perto por Claude Sonnet 5.5 com 64,14% e Kimi K3.1 Pro com 63,64%.
Qual modelo apresentou o melhor custo-benefício?
Kimi K3.1 Pro ficou na 3ª posição geral com taxa de 63,64% e custo médio de $4,57 por teste, menos da metade do custo do Claude Opus ($12,04).
Como os agentes são avaliados no Terminal-Bench?
Através do harness Mini-SWE-agent, onde o agente emite comandos bash em um container efêmero e o resultado final é validado por suítes de testes determinísticas ocultas do modelo.
Conclusão: a evolução do uso de linha de comando por IA
O Terminal-Bench 4.0 demonstra que os modelos de IA ultrapassaram a barreira da teoria e agora dominam ambientes de linha de comando Linux com estabilidade acima de 65%. À medida que modelos como Sonnet 5.5 e Kimi K3.1 Pro equilibram alta assertividade com custos acessíveis, a operação automatizada de servidores e repositórios entra em uma nova fase prática.
Fonte: Vals AI (Terminal-Bench 4.0)
Tags:#benchmark#claude#terminal#agentes-ia#linux
Desenvolvedor e criador do bridgecode, ambiente de desenvolvimento agêntico para orquestrar squads de agentes de IA. Ajuda quem vai do vibe coding ao desenvolvimento profissional a sair da ideia e chegar ao produto entregue.
Artigos relacionados
Benchmarks
SRE Bench: IA faz engenharia reversa de binários?
O SRE Bench testa se agentes de IA conseguem fazer engenharia reversa de binários sem código-fonte. GPT-6 Astra lidera com 56,87%.
5 min
Benchmarks
CyberBench: IA encontra bugs de segurança?
O CyberBench testa se agentes de IA conseguem encontrar falhas de segurança em código e produzir patches. Wonder, da Meta, lidera com 80,36%.
5 min
Benchmarks
Vibe Code Bench: IA constrói app web do zero?
O Vibe Code Bench testa se modelos de IA conseguem construir aplicações web completas a partir de uma descrição. Claude Sonnet 5.5 no OpenHands lidera com 92,39%.
5 min