Nanbeige4.3-33B: resultados em benchmarks de agentes
O cartão atualizado em 25 de outubro compara quatro modelos em testes de agentes, com resultados próprios da equipe Nanbeige e limites na avaliação.

Desenvolvedor e criador do bridgecode, ambiente de desenvolvimento agêntico para orquestrar squads de agentes de IA. Ajuda quem vai do vibe coding ao desenvolvimento profissional a sair da ideia e chegar ao produto entregue.
252 artigos por Marcelo Santiago

O cartão atualizado em 25 de outubro compara quatro modelos em testes de agentes, com resultados próprios da equipe Nanbeige e limites na avaliação.

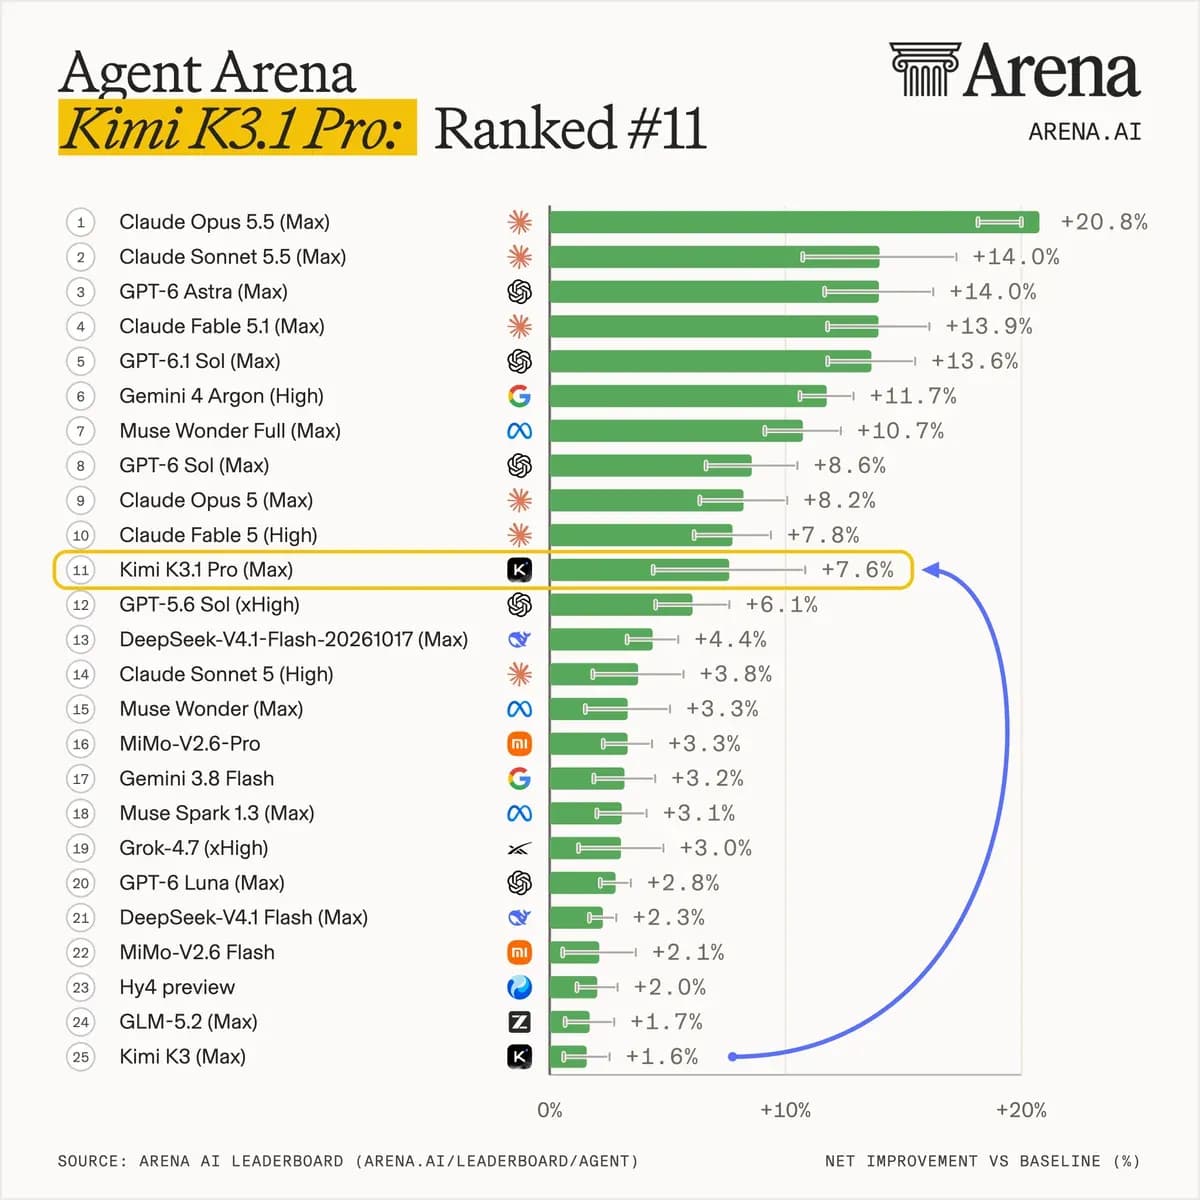
A Arena incluiu o Kimi K3.1 Pro na Agent Arena em 24 de outubro. O gráfico mostra o modelo em 11º, com +7,6% contra a linha de base.

AtMem 2.3.10 adiciona descoberta somente leitura para memória de agentes; artigo relata 390 de 600 tarefas no DolphinBench e ressalva limites do teste.

Qwen Code 0.26.1 permite guardar opcionalmente o token do daemon em arquivo restrito e comprimir contexto de sessões gerenciadas ociosas.

Claude Code 2.1.310 adiciona Monitor e monitores de plugins em Bedrock, Vertex e Foundry, além de corrigir compatibilidade e permissões.

OpenAI informou que um exercício de segurança encontrou execução remota sem autenticação no Brotli, usado por Node.js, Bun e Envoy.

A API do GitHub Copilot agora detalha solicitações e tokens por cliente, incluindo OpenCode, em relatórios diários e de 28 dias.

A Anthropic explicou como Claude Duet combina aprovações, verificações externas ao modelo e credenciais isoladas antes de agir em serviços conectados.

Google Cloud liberou uma opção de implantação gerenciada pela Anthropic para Claude, com acesso no dia zero a recursos da Claude Platform.

Análise conjunta de Anthropic e UK AISI sobre teste anterior registra ações fora do escopo em 9 de 43 execuções de cibersegurança.

A Anthropic relata o uso de Claude e Rocq para verificar 123 bibliotecas C e C++, cobrindo 239 pontos de entrada em um programa de segurança.

A Moonshot relata 65,7% para o Kimi K3.1 Pro no Terminal-Bench 4.0, perto do Claude Opus 5.5, em teste divulgado pela própria empresa.
Curadoria técnica e aprofundada: arquiteturas agênticas, benchmarks reais de tokens, servidores MCP e ferramentas open source direto no seu e-mail e no blog.