
Amazon publicó en el blog de Hugging Face el 9 de noviembre de 2026 HOPE, un método de segundo orden para podar expertos en modelos Mixture of Experts. El objetivo es reducir la memoria sin destruir grupos de expertos que cooperan entre sí, algo que los métodos anteriores ignoraban.
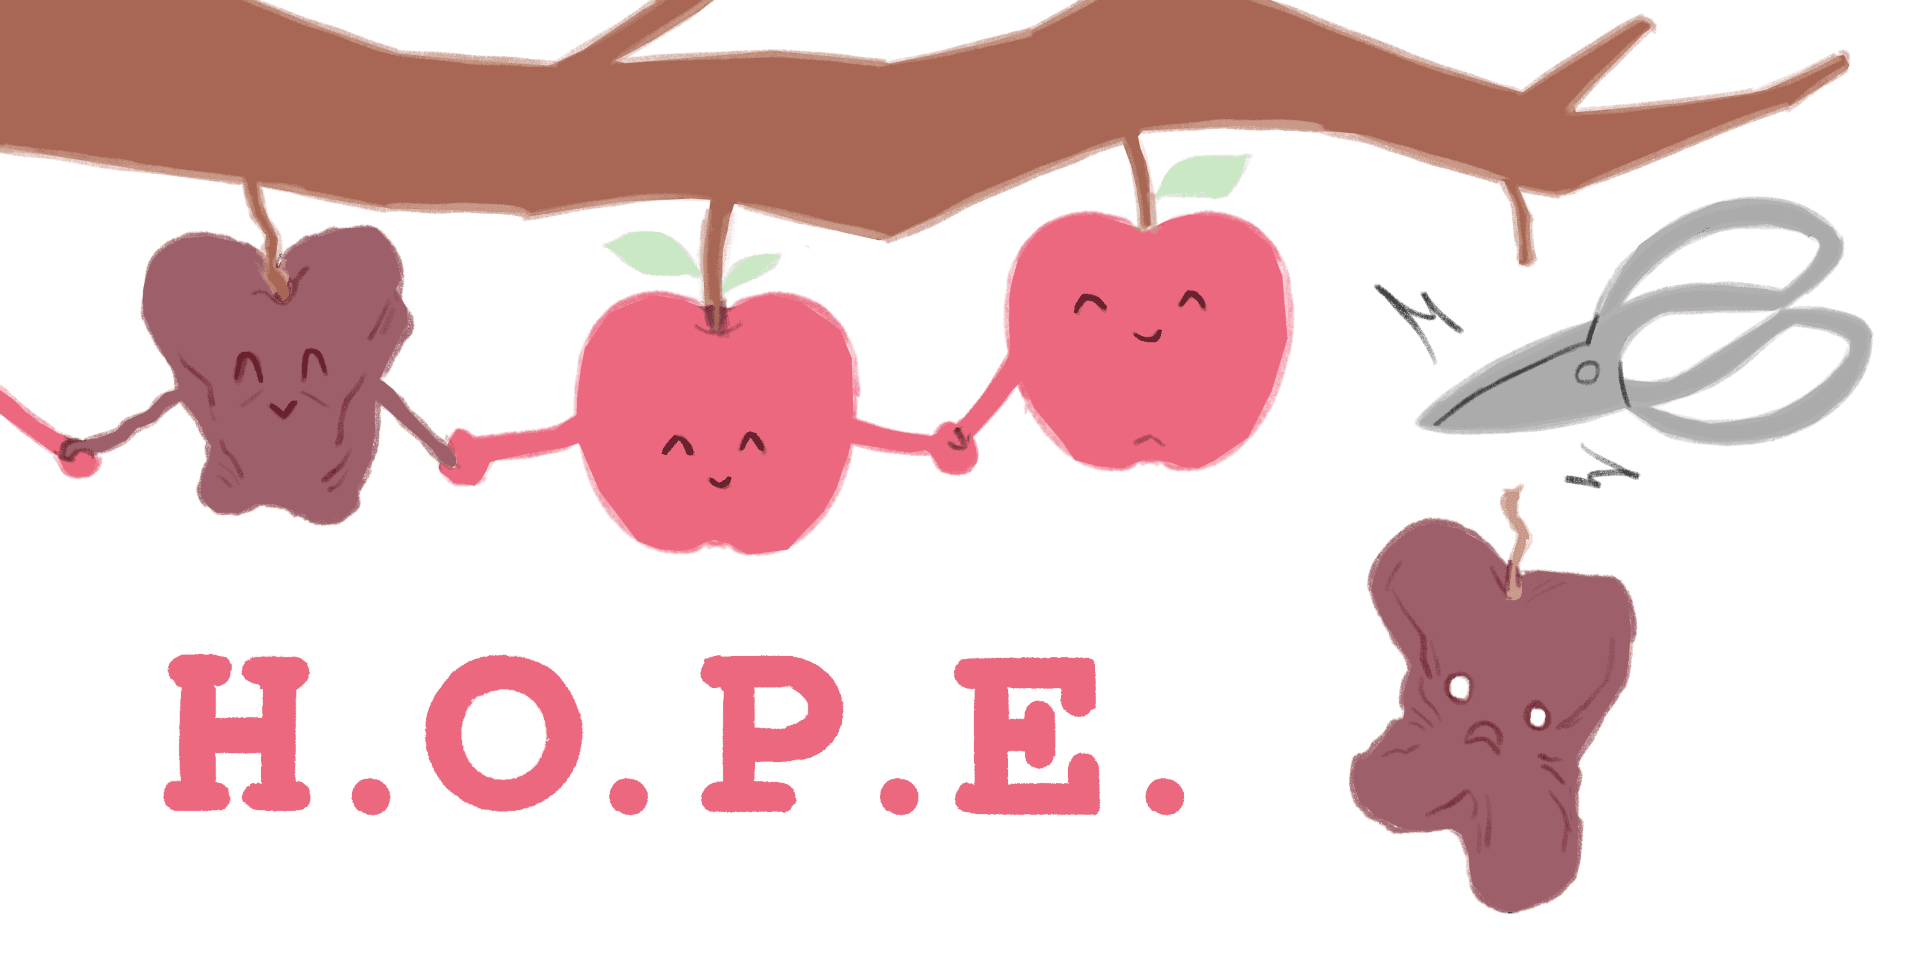
HOPE: podar expertos en modelos MoE sin romper la cooperación
Amazon publicó HOPE, un método de segundo orden que poda expertos en modelos MoE considerando la cooperación entre ellos, con una mejora de hasta 6,1% en código.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
Los modelos MoE alcanzan rendimiento de vanguardia con cientos de miles de millones de parámetros, pero cada experto ocupa memoria. Podar expertos es la forma más directa de encoger el modelo, pero los métodos existentes deciden el corte de cada experto de forma independiente, como si la contribución de cada uno fuera aditiva. En la práctica, los expertos cooperan: remover uno puede desmontar un circuito que dependía de él.
En este artículo verás:
- Qué es HOPE y por qué importa la cooperación entre expertos
- Cómo el método identifica el conjunto a podar
- Los resultados divulgados en el paper, incluyendo +6,1% en tareas de código
- Las limitaciones honestas y cómo probar hoy
Qué es HOPE, el método de poda de segundo orden de Amazon
HOPE significa Higher-Order Pruning of Experts. Es un objetivo de poda de segundo orden que considera las interacciones par a par entre expertos al decidir cuáles remover. La idea central es que los expertos no trabajan solos: los patrones de co-selección aparecen temprano en el entrenamiento y se estabilizan a lo largo de él.
Un método de primer orden puntúa cada experto por separado. Si el experto A parece prescindible, se elimina. El problema aparece cuando el experto B, que coopera frecuentemente con A, es importante. Remover A desmonta el grupo cooperativo, y la caída de rendimiento va más allá de lo que la puntuación individual preveía. Ese efecto se acumula en tasas agresivas de poda, de 40% a 50%, justo donde la reducción de memoria más importa para producción.
El paper muestra que REAP, método de primer orden considerado estado del arte, es un caso especial de HOPE en que los términos de interacción se ponen a cero. En otras palabras, HOPE generaliza a REAP al agregar la matriz de interacción entre expertos.
Cómo HOPE identifica el conjunto a podar
HOPE formula la poda como la minimización de una cota superior sobre el error resultante de la eliminación. La matriz de interacción F mide la cooperación par a par: F i,j es el promedio de g i(x) g j(x) en las entradas en que ambos expertos son seleccionados, normalizada por las normas de sus salidas. Cuanto mayor F i,j, más trabajan juntos los dos expertos.
En vez de ordenar expertos por una puntuación individual, HOPE busca el subconjunto cuya eliminación minimiza p transposto F p, el error de salida que el corte realmente causa. Esto captura el hecho de que dos expertos redundantes son baratos de remover juntos, mientras que dos complementarios no lo son. Una ordenación por experto no logra distinguir los dos casos.
En la práctica, el método poda cada capa de forma independiente y no considera interacciones entre capas. Esto mantiene el costo computacional viable, pero es una limitación declarada en el paper.
Los resultados publicados: +6,1% en código con 50% de poda
Los autores evaluaron HOPE en modelos MoE de gran escala, incluyendo GLM-4.7, Qwen3-Coder-480B y otras variantes. La métrica principal es la posición promedio entre los métodos comparados, con menor siendo mejor.
Con 50% de expertos eliminados, HOPE obtuvo la mejor posición promedio entre todos los métodos probados. En tareas agénticas de código, la ganancia llega a +6,1% sobre el segundo mejor método de poda. La ventaja es más pronunciada en tasas altas, de 40% a 50%. En tasas bajas, de 10% a 20%, métodos de primer orden como REAP y MAN a veces son competitivos y la ventaja de HOPE se reduce.
La explicación es directa: cuanto más expertos se eliminan, más interacciones se rompen, y los términos fuera de la diagonal de F ganan peso. En 50%, muchos pares cooperativos se rompen al mismo tiempo, y la puntuación individual no puede predecir ni prevenir ese daño.
Las ganancias también aparecen en tareas de uso de herramientas y de opción múltiple, con la ventaja aumentando conforme crece la tasa de poda.
Limitaciones honestas de HOPE
El paper es claro sobre lo que el método no hace. Primero, HOPE poda cada capa de forma independiente y no considera interacciones entre capas. Segundo, la matriz F se estima a partir de datos de calibración, por lo que la calidad depende de la representatividad de esos datos. Tercero, la ventaja sobre métodos de primer orden es pequeña en tasas bajas, donde la simplicidad de REAP puede ser suficiente.
También vale recordar que el paper es de Amazon y los resultados son auto reportados, sin replicación independiente hasta el momento. Quien quiera aplicar HOPE debe validarlo en su propio conjunto de modelos y tareas.
Cómo probar HOPE hoy
El código de HOPE está disponible en el repositorio oficial de Amazon en GitHub, vinculado al paper. La implementación trabaja sobre modelos MoE alojados en Hugging Face, como Qwen3-Coder y GLM, y permite reproducir los experimentos con datos de calibración provistos.
Para quien quiera evaluar poda de expertos en un modelo propio, el flujo es: elegir el modelo MoE, recolectar datos de calibración representativos, calcular la matriz F por capa y ejecutar HOPE con la tasa de poda deseada. Comparar con REAP en el mismo conjunto de evaluación antes de decidir.
Los checkpoints podados publicados por Amazon en Hugging Face permiten probar el resultado sin ejecutar la poda desde cero.
Preguntas frecuentes sobre HOPE para la poda de expertos en modelos MoE
¿Qué es HOPE?
HOPE significa Higher-Order Pruning of Experts. Es un método de segundo orden para podar expertos en modelos Mixture of Experts, considerando las interacciones par a par entre expertos.
¿Por qué importa la cooperación entre expertos en la poda?
Los expertos cooperan en grupos. Eliminar un experto individual puede desmontar un circuito que dependía de él, provocando una caída de rendimiento mayor a la que predecía su puntuación individual.
¿REAP es un caso especial de HOPE?
Sí. HOPE generaliza REAP al añadir la matriz de interacción entre expertos. REAP es el caso en que los términos de interacción se ponen a cero.
¿Cuánto mejora HOPE respecto a otros métodos?
Con un 50% de expertos eliminados, HOPE obtuvo la mejor posición promedio entre los métodos evaluados, con una mejora de hasta 6,1% en tareas agénticas de código respecto al segundo mejor método.
¿Cuáles son las limitaciones de HOPE?
HOPE poda cada capa de forma independiente, sin considerar interacciones entre capas. La matriz de interacción depende de los datos de calibración y la ventaja es pequeña en tasas bajas de poda.
Conclusión: poda que respeta la cooperación entre expertos
HOPE no reemplaza la poda de primer orden en todos los casos, pero muestra que ignorar la cooperación entre expertos cuesta desempeño, principalmente en tasas agresivas. La idea de tratar la poda como un problema de interacción, y no de puntuación individual, cambia la forma en que pensamos sobre compresión de modelos MoE.
Para quien ejecuta modelos MoE en producción con restricción de memoria, HOPE es un candidato serio a probar, especialmente cuando el objetivo es cortar la mitad de los expertos sin perder calidad en código. Quien sigue la carrera de los modelos abiertos también puede comparar con el análisis sobre cómo modelos open-source cierran la brecha en ciberseguridad y con el caso de Arete-27B, que reeduca a Qwen para valores occidentales.
Fuente: Hugging Face
Tags:#MoE#pruning#HOPE#Amazon#modelos abertos
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Newsletter
Automattic une apps de vibe coding en una plataforma para publicar en la web
Automattic une apps de vibe coding en una plataforma para publicar apps en la web. Mira cómo funciona y qué cambia para los equipos que crean con IA.
4 min
Newsletter
Medium lanza TK, app de notas con IA en el editor
Medium lanzó TK, una app de notas y escritura con asistente de IA integrado en el editor. Mira cómo funciona y qué cambia para quienes escriben.
6 min
Newsletter
Otter.ai lanza la mayor expansión multilingüe de su historia
Otter.ai anunció 27 nuevos idiomas y transcripción multilingüe que sigue el cambio de idioma dentro de una misma reunión. Mira qué cambia y cómo probarlo.
6 min