
El benchmark de agentes suele resumirse a un porcentaje. Ese número, por sí solo, no revela qué se probó, cuántos intentos entraron en la cuenta o si el resultado se transfiere a otro entorno.

Dicas6 min
7 consejos para evaluar benchmarks de agentes de IA
Siete verificaciones para comparar benchmarks de agentes: unidad de la tarea, muestra, generalización, condiciones de prueba y límites del puntaje.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
Esta guía organiza siete verificaciones para interpretar resultados sin confundir una tarea de laboratorio con el desempeño general de un producto.
En este artículo verás:
- Cómo definir la unidad de evaluación y separar entrenamiento de prueba.
- Por qué publicar conteos, muestra y casos sin solución.
- Cómo mantener las condiciones comparables y reportar incertidumbre.
- Qué no mide una tasa de éxito.
7 consejos para evaluar benchmarks de agentes de IA
Consejo 1: define qué cuenta como un intento
Un intento puede ser una llamada de herramienta, una acción individual o una tarea entera. Escribe esa unidad antes de recolectar resultados, porque cambiar el denominador cambia el significado del porcentaje.
ToyBlocks, de AI2, muestra resultados por comando y por episodio.
Una habilidad de manipulación puede funcionar en una acción, mientras que una secuencia completa aún falla en algún paso. El artículo de ToyBlocks explica por qué estas medidas no deben mezclarse.
Consejo 2: separa ejemplos conocidos de casos nuevos
Una prueba de generalización debe mantener ejemplos de evaluación fuera del conjunto usado para ajustar al agente. Indica qué aspecto cambió, por ejemplo la disposición de los objetos, la formulación de la petición o la combinación de herramientas.
En el gráfico de ToyBlocks, dos tareas tenían éxito dentro del dominio del 83% y del 90%. La generalización inicial era del 5% y del 29%.
La combinación de estrategias llegó al 81% y al 89%, respectivamente, según AI2. Son dos tareas específicas, no una tasa universal de robótica.
Consejo 3: muestra éxitos y intentos junto con el porcentaje
Una tasa sin numerador y denominador esconde el tamaño de la muestra. En tareas simples de ToyBlocks, el equipo reportó 111 éxitos en 200 episodios simulados y 15 en 30 episodios en el robot real, según los resultados de AI2.
Estos datos hacen visible la limitación. La muestra física es pequeña, así que el porcentaje no prueba que el desempeño se mantendrá en otros robots o escenas. Prefiere escribir “15 de 30” a presentar “50%” sin contexto.
Consejo 4: incluye casos en los que la respuesta correcta es detenerse
No toda petición tiene una solución segura o posible. Un agente que ejecuta cualquier comando puede parecer productivo, pero el benchmark también debe verificar si identifica límites, pide confirmación o informa que no puede completar la tarea.
En las pruebas de búsqueda de letras de ToyBlocks, la mitad de las escenas preparadas no tenía una solución posible. La evaluación consideraba tanto concluir la tarea como reconocer correctamente los casos inviables, según la descripción de AI2.
Consejo 5: mantén fijas las reglas y las herramientas
Para una comparación justa, registra modelo, proveedor, versión, instrucciones, herramientas disponibles y reglas del ambiente. Si una condición cambia, márcala como otra configuración, en lugar de atribuir toda la diferencia al modelo.
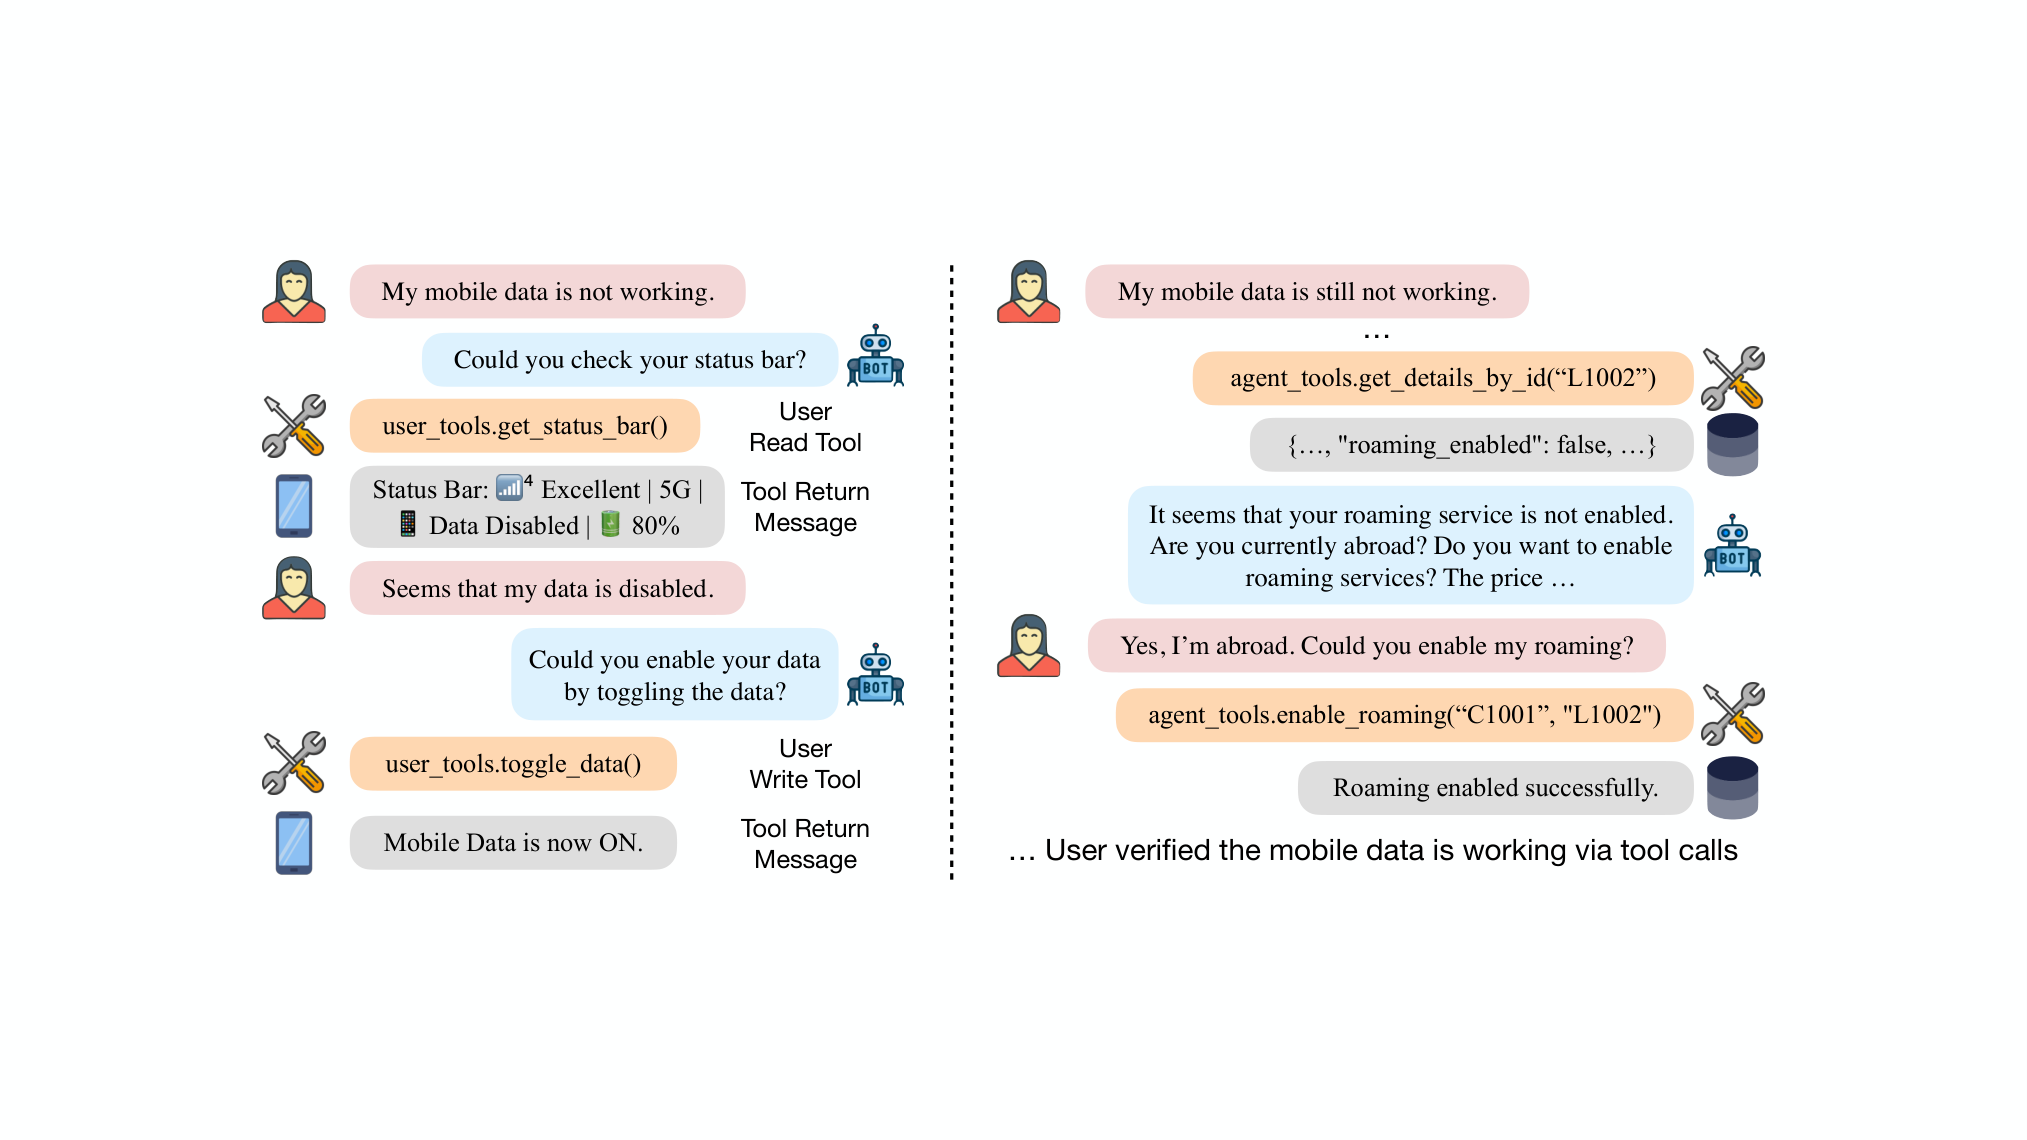
τ²-Bench evalúa agentes en escenarios con reglas y herramientas definidas. El artículo del benchmark describe ese formato de interacción. El resultado de GPT-5.1 en τ²-Bench Airline también muestra por qué vale la pena registrar la integración modelo-proveedor.
Consejo 6: publica la incertidumbre, no solo el promedio
Muestra cuántas tareas entraron en el análisis e incluye intervalo de confianza u otra medida de incertidumbre cuando el método lo permita. Si no es posible calcularlo, explica la limitación en lugar de tratar pequeñas diferencias como una victoria concluyente.
El BioBasicsBench de OpenAI presenta una evaluación con 100 tareas para medir el trabajo de agentes en actividades de ciencia de laboratorio.
Usa el estudio como ejemplo de que la definición del conjunto y el método deben acompañar la puntuación, no quedar escondidos detrás de ella.
Consejo 7: indica qué dimensiones quedaron fuera de la prueba
Una tasa de conclusión no mide automáticamente latencia, costo computacional, seguridad, facilidad de auditoría o cantidad de intervención humana. Declara qué se observó y qué no entró en el benchmark.
El mismo cuidado aparece en benchmarks de software. FeatureLoop evalúa requisitos que evolucionan durante la tarea, pero eso no sustituye pruebas propias de seguridad, costo o experiencia de usuario.
Checklist para comparar dos benchmarks de agentes
Antes de elegir un agente a partir de una tabla, registra la unidad evaluada, la composición del conjunto de prueba, el número de intentos y las reglas de éxito.
Luego verifica que modelo, proveedor y herramientas estuvieran en condiciones comparables.
Lee los resultados por tipo de tarea cuando estén disponibles. Si un estudio presenta solo el promedio, anota esa limitación y evita extrapolar a operaciones que no fueron testeadas.
Por último, ejecuta una evaluación pequeña en tu propio flujo antes de llevar el ranking a producción. Reutiliza tareas representativas, define los criterios antes de ejecutar y guarda ejemplos de fallas para que el equipo pueda reproducir el análisis.
Preguntas frecuentes sobre benchmarks de agentes de IA
¿Qué mide un benchmark de agentes de IA?
Mide la ejecución de tareas definidas bajo reglas, herramientas y criterios específicos. La puntuación no representa el desempeño general del agente en cualquier contexto.
¿Por qué publicar numerador y denominador?
Muestran cuántos intentos sustentan el porcentaje. En ToyBlocks, AI2 informa 15 éxitos en 30 episodios físicos, una muestra que debe leerse con cautela.
¿Cuál es la diferencia entre éxito por comando y por episodio?
La métrica por comando evalúa una acción aislada, mientras que la por episodio evalúa una tarea completa. Los resultados no son intercambiables.
¿Qué significa la generalización fuera de dominio?
Es el desempeño en configuraciones que difieren de las usadas en el entrenamiento. ToyBlocks compara escenarios espaciales familiares y diferentes.
¿Los benchmarks prueban que un agente funcionará en producción?
No. Miden las tareas y condiciones definidas por el estudio. Es necesario probar el flujo propio, con reglas, herramientas, datos y riesgos relevantes.
Una puntuación solo es útil con método y denominador
Los benchmarks ayudan a formular hipótesis, siempre que muestren la tarea, la muestra y los límites del resultado. Empieza verificando la unidad, busca los datos brutos detrás del porcentaje y trata simulación, herramienta y ambiente real como condiciones distintas.
Un benchmark mide una tarea específica. Un squad puede dividir planificación, ejecución y revisión del proyecto, y eso es lo que montas como squad de agentes en bridgecode.
Fuente: OpenAI
Tags:#benchmarks de agentes#avaliação de IA#generalização#amostragem#uso de ferramentas#BioBasicsBench
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Dicas
Kilo Code: agente de código de código abierto para VS Code y CLI
Kilo Code es un agente de código de código abierto para VS Code, JetBrains y CLI, con más de 500 modelos y precio directo del proveedor.
6 min

Dicas
Cómo probar agentes de IA en operaciones de nube con CloudOpsBench
CloudOpsBench publica 45 tareas de operación en la nube para probar tu agente de IA. Mira cómo clonar, validar y ejecutar contra un emulador o AWS real.
6 min
Dicas
Hy4 de Tencent: 1M de contexto, visión y tool calling
Hy4 de Tencent trae 1 millón de tokens de contexto, visión y tool calling nativo para agentes de código y tareas de larga duración.
5 min