
Em 6 de novembro de 2026, às 15:59 UTC, o leaderboard tau2-Bench Airline do OpenRouter mostrava o GPT-5.1 da OpenAI em primeiro lugar, com 80,0% de sucesso. É um resultado de uso de ferramentas em uma simulação de atendimento aéreo, não um selo de que o modelo seja melhor para qualquer tarefa.

Benchmark6 min
GPT-5.1 lidera tau2-Bench Airline com 80%
No placar tau2-Bench Airline de 6 de novembro, GPT-5.1 marcou 80,0%. Entenda método, amostra mínima e limites antes de escolher um agente.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
O que o tau2-Bench Airline mede
O tau2-Bench Airline avalia um agente que conversa com um cliente simulado e usa ferramentas de uma companhia aérea. O objetivo é concluir pedidos dentro de regras de negócio, em vez de apenas responder com texto convincente.
As tarefas podem exigir a consulta de uma reserva, alteração ou cancelamento de voo e outras ações apoiadas pelas ferramentas disponíveis. O agente precisa entender o pedido, escolher a operação adequada e respeitar a política definida para o cenário.
Esse formato importa porque uma conversa pode parecer correta e ainda terminar sem a ação solicitada. Em uma avaliação de agente, o estado final da reserva e a conformidade com a política pesam mais do que uma resposta bem escrita.
O benchmark também limita o ambiente. Os modelos recebem o mesmo contexto da tarefa, as mesmas regras, o mesmo cliente simulado e o mesmo conjunto de ferramentas. Isso ajuda a comparar execuções sem transformar o teste em uma avaliação de conhecimento geral.
O artigo do benchmark τ²-Bench explica a avaliação de agentes em cenários de controle compartilhado. A página do leaderboard Airline do OpenRouter descreve a configuração usada para os resultados exibidos no serviço.
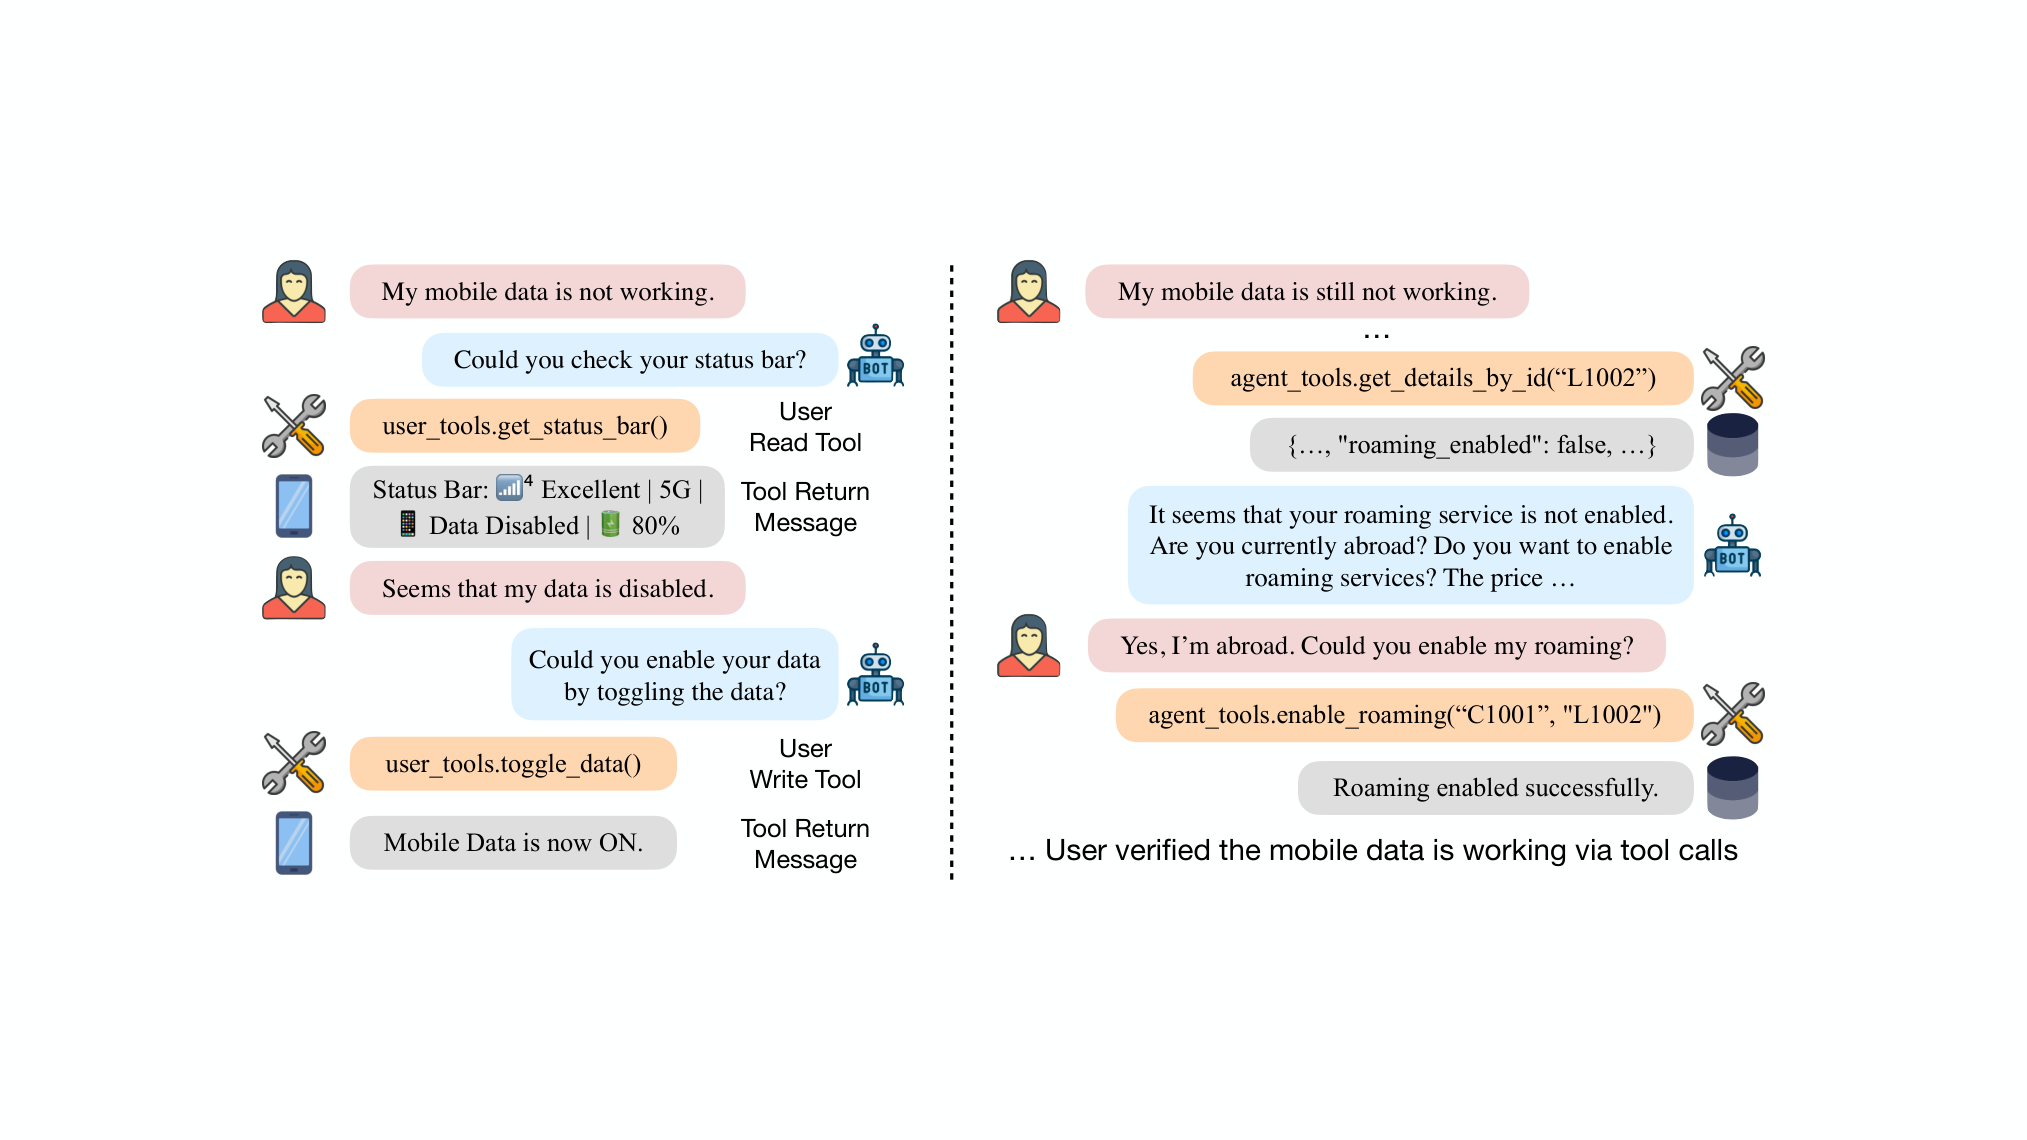
Esse exemplo de Telecom ilustra o formato de interação, não o placar Airline de 2026. Veja a pesquisa original para o contexto.
Como o OpenRouter calcula os 80,0%
A página consultada registrava o resultado às 15:59 UTC de 6 de novembro. Naquele recorte, OpenAI GPT-5.1 aparecia no topo com taxa de sucesso de 80,0% no domínio Airline.
A nota não vem de uma única conversa escolhida para ilustrar o modelo. O OpenRouter agrega execuções bem-sucedidas dos 90 dias anteriores e pondera o cálculo pelo número de tarefas. A janela móvel faz o placar acompanhar a atividade recente, mas também significa que ele pode mudar quando novas execuções entram ou as antigas saem do período.
Há ainda uma condição mínima: cada par de modelo e provedor precisa de pelo menos 45 tarefas avaliadas para aparecer no ranking. O OpenRouter mostra desvio padrão junto às notas, mas esse número não substitui a leitura do método nem revela, sozinho, a distribuição completa dos casos.
| Item | O que a página informa |
|---|---|
| Modelo no topo | OpenAI GPT-5.1 |
| Sucesso exibido | 80,0% |
| Recorte consultado | 6 de novembro de 2026, 15:59 UTC |
| Janela de agregação | 90 dias anteriores |
| Amostra mínima | 45 tarefas avaliadas por par modelo e provedor |
A comparação é entre integrações modelo-provedor, não apenas entre nomes de modelos. Roteamento, disponibilidade e configuração do provedor fazem parte do sistema observado, então dois serviços que oferecem o mesmo modelo podem não produzir números idênticos.
O que o primeiro lugar não prova
A taxa de 80,0% não significa que o GPT-5.1 acerte oito de cada dez solicitações reais de qualquer companhia aérea. Ela descreve o conjunto de tarefas e as regras específicas do tau2-Bench Airline.
A amostra mínima de 45 tarefas também merece atenção. É suficiente para o OpenRouter incluir uma integração no placar, mas não equivale a milhares de interações com clientes nem garante que diferenças pequenas entre modelos sejam estáveis.
A média ponderada esconde variação entre tipos de pedido. Um agente pode ser forte em consultar itinerários e ter mais dificuldade em alterações com várias restrições. Por isso, a taxa agregada não substitui a leitura de resultados por cenário, quando eles estão disponíveis.
O benchmark tampouco mede todos os fatores de uma operação: qualidade dos dados, exceções, segurança da conta, latência percebida e volume de intervenções humanas. Esses aspectos exigem avaliações próprias.
Esse cuidado vale para outros testes: o FeatureLoop avalia requisitos de código em evolução, enquanto o GDPx compara domínios distintos.
Como usar o leaderboard na escolha de um agente
Use o tau2-Bench Airline como filtro inicial se o seu produto depende de agentes que consultam dados e executam operações com regras. Ele é mais informativo que um teste de conversa livre para esse tipo de fluxo, porque inclui ações e estado final.
Antes de comparar dois provedores, confira a data de atualização, a janela de 90 dias, o mínimo de tarefas e o desvio padrão exibido. Registre também o modelo exato e o provedor, para não atribuir ao modelo sozinho um resultado que pode depender da integração.
Depois, reproduza a ideia do teste no seu domínio. Monte casos com pedidos frequentes, exceções, políticas incompatíveis e operações que exigem confirmação. Defina antes o que conta como sucesso, como evitar alterações indevidas e como avaliar uma conversa interrompida.
Separe métricas de tarefa e de experiência. A conclusão da ação pode ser medida em uma e a clareza da conversa, o tempo de resposta e a necessidade de intervenção humana em outras. Isso evita que uma média única esconda uma falha que seria crítica para o usuário.
Se houver dados internos, faça uma avaliação controlada com os mesmos casos para cada opção. Preserve os logs necessários, retire informações pessoais e compare também os erros por tipo de tarefa. O leaderboard ajuda a formular uma hipótese; a validação no fluxo real decide se ela se sustenta.
Preguntas frecuentes sobre o resultado do GPT-5.1 no tau2-Bench Airline
O que o tau2-Bench Airline mede?
Ele avalia agentes que conversam com um cliente simulado e executam operações de uma companhia aérea dentro de regras definidas. A pontuação considera a conclusão das tarefas do cenário, não só a qualidade do texto.
Qual foi o resultado do GPT-5.1 no tau2-Bench Airline?
No registro de 6 de novembro de 2026, às 15:59 UTC, o OpenAI GPT-5.1 aparecia em primeiro lugar com 80,0% de sucesso.
Qual é o tamanho mínimo da amostra no ranking do OpenRouter?
O OpenRouter exige pelo menos 45 tarefas avaliadas por par de modelo e provedor para exibir a integração. A nota agrega execuções bem-sucedidas dos 90 dias anteriores, ponderadas pelo número de tarefas.
O resultado de 80,0% prova que o GPT-5.1 é melhor para qualquer agente?
Não. O número descreve o tau2-Bench Airline e a integração modelo-provedor observada. Ele não garante desempenho igual em outros setores, políticas ou fluxos de produção.
O que muda para quem desenvolve agentes de atendimento
O GPT-5.1 liderar esse recorte é um sinal útil sobre execução de ferramentas em tarefas aéreas, desde que a data e a amostra acompanhem a leitura. A nota não deve virar promessa de desempenho em suporte, vendas ou automação fora desse cenário.
Para um time técnico, o valor do ranking está em mostrar uma capacidade que pode ser testada: seguir políticas e concluir ações em uma simulação compartilhada. O passo seguinte é repetir a avaliação com os próprios fluxos e observar onde o agente precisa de validação humana.
O resultado merece atenção, mas só faz sentido junto do modelo, provedor, janela, amostra e definição de sucesso.
Testar agentes em ferramentas separadas fragmenta o fluxo. Coordene seus agentes num só fluxo no bridgecode.
Fonte: OpenRouter
Tags:#OpenRouter#GPT-5.1#tau2-Bench Airline#benchmark#agentes de IA
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados

Benchmarks
CloudOpsBench: agentes de IA em operações de nuvem
O CloudOpsBench mede como agentes de IA executam tarefas reais de operação em nuvem. O melhor agente resolve 60,6% das 45 tarefas na AWS. Veja os números.
7 min

Benchmarks
RoleRouteBench: o que o roteamento revela em multi-agentes
RoleRouteBench é um ambiente reproduzível para avaliar roteamento dinâmico de papéis em tarefas multi-etapa. Veja os resultados do JEV 1.13 nos quatro domínios.
6 min

Benchmarks
SuperCLUE novembro 2026: líderes diferentes por categoria
SuperCLUE publicou em novembro de 2026 a tabela com 19 modelos e líderes diferentes em cada categoria. O ranking dividido é mais útil como mapa de shortlist do que como veredito final.
6 min