
Um agente pode terminar uma tarefa aparentemente correta e ainda falhar quando o requisito seguinte chega. O preprint Benchmarking Coding Agents under Evolving Requirements, publicado no arXiv em 26 de outubro e revisado em 29 de outubro de 2026, apresenta o FeatureLoop: um benchmark que acompanha o mesmo código à medida que o usuário acrescenta requisitos e relata falhas.

Benchmark7 min
FeatureLoop: benchmark revela falhas de agentes com requisitos em evolução
O preprint FeatureLoop avalia agentes de código em tarefas com requisitos que evoluem. O estudo mostra que feedback ajuda, mas que correções locais nem sempre preservam tudo o que já foi solicitado.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
O que o FeatureLoop mede
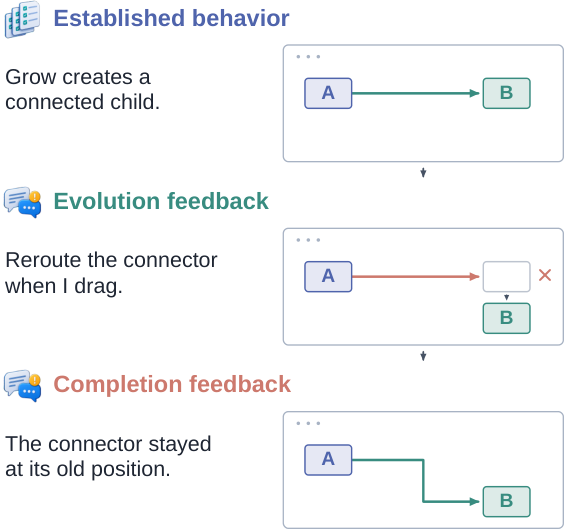
Muitos benchmarks verificam se um agente concluiu uma tarefa isolada. O FeatureLoop acompanha uma sequência: primeiro há um pedido inicial; depois, novos requisitos ampliam o produto; por fim, o usuário informa comportamentos que ainda falham. O agente continua trabalhando no mesmo espaço de trabalho, e cada etapa precisa preservar o que já funcionava.
O paper compara três cenários: requisitos completos entregues de uma vez (Full), pedidos progressivos sem correções (Evo) e pedidos progressivos com feedback corretivo (Evo+Comp). As verificações executáveis avaliam tanto a nova funcionalidade quanto os requisitos anteriores e o comportamento-base do repositório.
Os resultados principais
No conjunto agregado de modelos, a taxa de conclusão estrita ficou em 40,3% quando todo o escopo foi especificado de início, 51,6% com pedidos progressivos e 64,1% com pedidos progressivos mais correções. Isso mostra que, nessa avaliação, a interação ao longo do trabalho ajudou — mas não eliminou falhas.
O melhor resultado individual no cenário com pedidos e correções foi 72,1% para GPT-6 Astra. Esse número não é a média dos modelos: é o resultado do modelo mais bem colocado na métrica de conclusão estrita do estudo. Outro dado chama atenção: entre os estados que haviam falhado, apenas 15,4% foram recuperados em até duas revisões corretivas. E, mesmo quando uma correção local funcionava, em 20,9% dos casos outras exigências já informadas continuavam incompletas.
Esses números tratam de métricas diferentes. Os 64,1% são o resultado agregado do cenário Evo+Comp; 72,1% é o melhor modelo nesse cenário; 15,4% mede recuperação de estados falhos em até duas revisões. Não são taxas intercambiáveis nem uma previsão do desempenho de qualquer agente em qualquer projeto.
Para comparar o FeatureLoop com outros estudos de coding agents em repositórios, veja também o benchmark SnowPR, baseado em pull requests reais da Snowflake, e o GenXR-Bench para tarefas de desenvolvimento XR.
Como o estudo foi montado — e quais são os limites
O FeatureLoop reúne 61 tarefas revisadas por pessoas, provenientes de 34 repositórios e cobrindo cinco linguagens principais e sete tipos de software. Os autores avaliaram 12 modelos em 2.196 execuções; todos usaram Claude Code como harness compartilhado. Os testes acumulam requisitos ao longo das etapas e também verificam regressões no comportamento que já existia.
O estudo é um preprint no arXiv, não uma prova independente de que todo agente falha da mesma forma. A amostra tem 61 tarefas, o método de avaliação foi construído pelos autores e os resultados dependem dos modelos, configurações e verificações escolhidos. Use-os para entender um tipo específico de trabalho iterativo, não como ranking universal de coding agents.
O que builders podem aplicar
- Escreva critérios de aceite observáveis para cada requisito, não apenas uma descrição geral do resultado desejado.
- Quando uma mudança chegar, transforme a falha relatada em um teste reproduzível.
- Após corrigir o ponto local, rode também os testes dos requisitos anteriores e do comportamento-base.
- Registre o que foi verificado e o que continua pendente; não trate uma resposta do agente dizendo “corrigido” como evidência de que todo o fluxo funciona.
- Em tarefas longas, avance em etapas pequenas e peça ao agente para relatar os testes executados e os limites da verificação.
Preguntas frecuentes sobre o benchmark FeatureLoop
O que o FeatureLoop avalia?
FeatureLoop é um benchmark de tarefas de desenvolvimento em repositórios onde os requisitos são revelados progressivamente e o agente recebe, em parte dos cenários, feedback sobre falhas observadas.
O que significa a taxa de 15,4%?
15,4% é a parcela de estados de falha observados que foram recuperados em até duas revisões corretivas. Não significa que 15,4% de todas as tarefas foram concluídas.
Os 72,1% são a média de todos os modelos?
Não. 72,1% foi o melhor StrictPass individual no cenário com pedidos progressivos e correções, para GPT-6 Astra. A taxa agregada do cenário foi 64,1%.
O FeatureLoop prova que agentes de código falham em qualquer projeto?
Não. O paper analisa 61 tarefas em 34 repositórios, 12 modelos e uma configuração de avaliação compartilhada. Os resultados não são um ranking universal nem garantem o mesmo desempenho em outro projeto.
Conclusão
O FeatureLoop destaca uma diferença prática: atender ao pedido mais recente não garante que o conjunto de requisitos continue funcionando. O feedback ajuda, mas a recuperação completa e a preservação de funcionalidades anteriores permanecem desafios no benchmark. Para builders, testes cumulativos e revisão por etapa são parte do fluxo de trabalho, não um acabamento opcional.
Para estruturar planejamento, execução e revisão em projetos com agentes, veja como o BridgeCode organiza workflows multiagente.
Fonte: Feng et al., FeatureLoop — arXiv:2610.35488, versão 2 · Paper em PDF
Tags:#FeatureLoop#benchmark de agentes de código#requisitos em evolução#regressão de software#arXiv
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados

Benchmarks
RoleRouteBench: o que o roteamento revela em multi-agentes
RoleRouteBench é um ambiente reproduzível para avaliar roteamento dinâmico de papéis em tarefas multi-etapa. Veja os resultados do JEV 1.13 nos quatro domínios.
6 min

Benchmarks
CloudOpsBench: agentes de IA em operações de nuvem
O CloudOpsBench mede como agentes de IA executam tarefas reais de operação em nuvem. O melhor agente resolve 60,6% das 45 tarefas na AWS. Veja os números.
7 min

Benchmarks
SuperCLUE novembro 2026: líderes diferentes por categoria
SuperCLUE publicou em novembro de 2026 a tabela com 19 modelos e líderes diferentes em cada categoria. O ranking dividido é mais útil como mapa de shortlist do que como veredito final.
6 min