
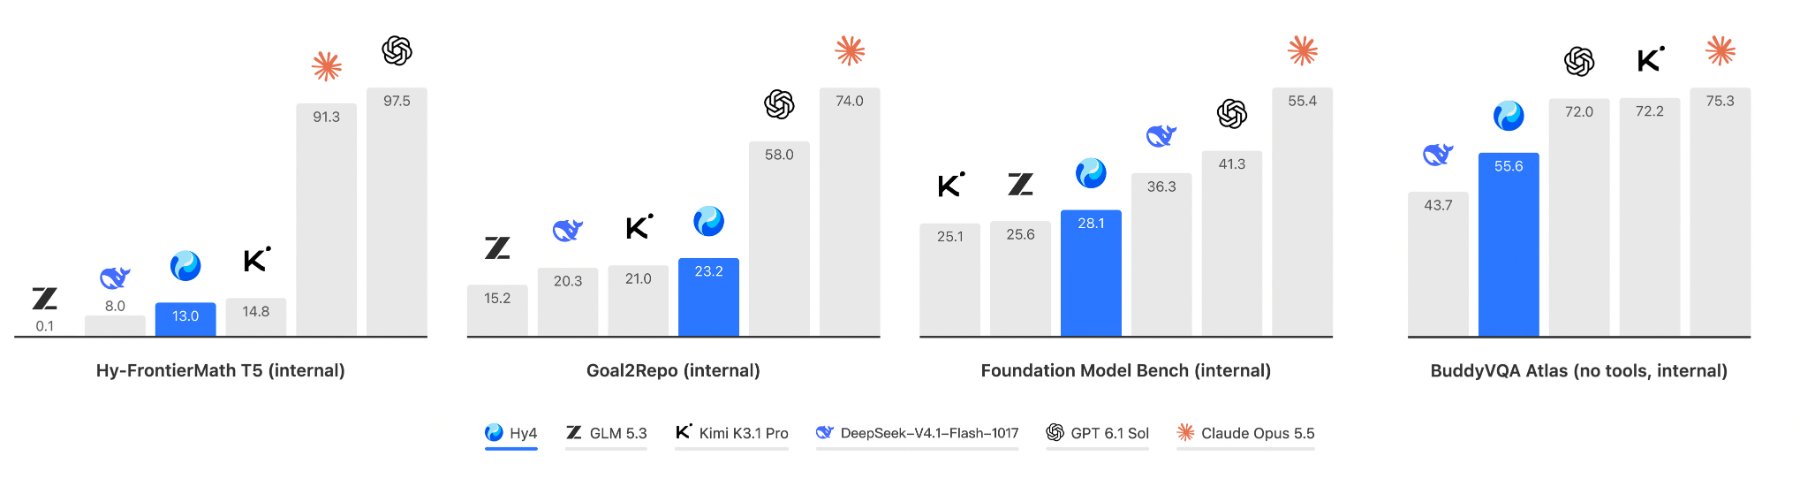
Tencent lanzó el 4 de noviembre de 2026 Hy4, un modelo de lenguaje con 1.048.576 tokens de contexto, soporte de visión y tool calling nativo. El modelo tiene 770 mil millones de parámetros en total, con 49 mil millones activos, y está orientado a agentes de código, flujos de tool-use complejos y tareas de productividad de larga duración.
Dicas5 min
Hy4 de Tencent: 1M de contexto, visión y tool calling
Hy4 de Tencent trae 1 millón de tokens de contexto, visión y tool calling nativo para agentes de código y tareas de larga duración.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
Para quien arma agentes de código, la combinación de contexto largo, visión y tool calling en un solo modelo cambia el diseño del agente. En lugar de dividir el trabajo en varias llamadas cortas, se puede mantener un historial largo, analizar capturas de pantalla y llamar herramientas dentro del mismo flujo.
En este artículo vas a ver:
- Qué es Hy4 y cómo se diferencia de Hy4 preview.
- Cuándo usar contexto de 1 millón de tokens en la práctica.
- Cómo activar visión y tool calling en el mismo agente.
- Límites y costos para planificar la adopción.
- Cómo probar Hy4 hoy vía OpenRouter.
Qué es Hy4
Hy4 es un modelo Mixture of Experts de Tencent. La versión oficial entrega mejoras sustanciales respecto a Hy4 preview, con ganancias particularmente fuertes en capacidades agénticas y desempeño en tareas de productividad a largo plazo. La novedad más visible es la introducción del entendimiento visual por primera vez en la línea.
El modelo acepta texto e imágenes como entrada y devuelve texto. Soporta tool calling con tools y tool_choice, además de salidas estructuradas vía JSON schema en response_format. El límite de conclusión es de 65.536 tokens por respuesta.
La diferencia práctica respecto al preview es el foco en agentes. El preview ya se describía como modelo para agentes de código y flujos complejos de tool-use. La versión oficial refuerza esto con mejoras en planificación, continuidad de contexto y ejecución sostenida en múltiples etapas.
Cuándo usar 1 millón de tokens de contexto
Un millón de tokens no es para toda tarea. El uso tiene sentido cuando el agente necesita mantener historial largo de una sesión, analizar bases de código enteras o seguir conversaciones extensas sin perder el hilo.
Casos típicos: análisis de repositorio grande en una sola pasada, agentes de soporte que acumulan contexto de días, y flujos de investigación donde el modelo necesita cruzar muchos documentos. Para tareas cortas, el costo de contexto no se justifica y un modelo más pequeño responde más rápido.
El consejo práctico es medir. Comienza con una ventana corta, aumenta conforme el agente pierda información y observa el costo. El contexto largo es un recurso, no un estándar.
Visión y tool calling en el mismo flujo
Hy4 acepta imágenes junto con texto. Esto permite que un agente de código analice capturas de pantalla de interfaz, diagramas de arquitectura o prints de error sin necesitar un modelo separado para visión.
Con tool calling nativo, el modelo puede llamar funciones externas, como buscar en el repositorio, ejecutar tests o consultar APIs. La combinación con visión abre flujos como: recibir un print de bug, identificar el componente, llamar la herramienta de búsqueda en el código y proponer la corrección, todo en una sola conversación.
Para quien ya usa otros agentes, vale comparar con lo que tiene. Claude Code 2.1.319 trae MCP tasks en segundo plano, útil cuando el modelo llama herramientas lentas. Hy4 puede servir como modelo detrás de esas llamadas cuando el contexto sea el cuello de botella.
Limites y costos
El modelo se sirve vía OpenRouter con un precio de 0,417 dólar por millón de tokens de entrada y 1,251 dólar por millón de tokens de salida. La lectura de caché cuesta 0,021 dólar por millón. La tasa de finalización máxima es de 65.536 tokens.
La ventana de 1 millón de tokens es grande, pero llenarla por completo tiene costo. Un agente que envía 500 mil tokens de contexto en cada llamada multiplica el gasto rápidamente. Planifica la adopción midiendo tokens por tarea y comparando con modelos más pequeños.
La disponibilidad reportada es alta, 99,91% en los últimos tres días, con un throughput de 55 tokens por segundo. Para flujos sensibles a la latencia, prueba antes de migrar. Si estás eligiendo entre modelos, SuperCLUE ayuda a comparar líderes por categoría.
Cómo probar Hy4 hoy
El camino más simple es vía OpenRouter, que expone el modelo con API compatible con OpenAI. Cambia el base URL y el model slug a tencent/hy4 y mantén el resto del código.
Antes de migrar un flujo real, ejecuta una prueba controlada: una tarea de análisis de repositorio con contexto largo, una tarea con imagen y una tarea con tool calling. Compara resultado, latencia y costo con el modelo actual.
Si el caso de uso es un agente de código con contexto largo y visión, Hy4 es un candidato fuerte. Si es una tarea corta y barata, un modelo más pequeño puede ser más eficiente.
Preguntas frecuentes sobre el modelo Hy4 de Tencent
¿Qué es el Hy4 de Tencent?
Es un modelo Mixture of Experts con 1.048.576 tokens de contexto, soporte para visión y tool calling nativo, orientado a agentes de código y tareas de larga duración.
¿Cuándo usar un contexto de 1 millón de tokens?
Cuando el agente necesita mantener un historial largo, analizar bases de código completas o seguir conversaciones extensas sin perder contexto.
¿Hy4 soporta visión y tool calling juntos?
Sí. Acepta imágenes junto con texto y permite llamar herramientas externas en el mismo flujo.
¿Cuánto cuesta usar Hy4?
Vía OpenRouter, 0,417 dólar por millón de tokens de entrada y 1,251 dólar por millón de tokens de salida.
¿Cómo probar Hy4 hoy?
Vía OpenRouter, con API compatible con OpenAI, cambiando el base URL y el model slug a tencent/hy4.
Conclusión
Hy4 de Tencent llega con una propuesta clara: contexto de 1 millón de tokens, visión y tool calling en un único modelo orientado a agentes. Para quien monta agentes de código, la pregunta práctica es si el contexto largo y la visión justifican el costo frente a los modelos ya en uso.
Prueba en una tarea real, mide tokens y latencia, y decide con datos. El contexto largo es un recurso poderoso cuando se usa con propósito.
Tu empresa con un equipo de IA: agentes de atención, contenido, análisis y operación coordinados juntos en bridgecode.
Fuente: The Decoder
Tags:#tencent#hy4#agentes#contexto#tool-calling
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados

Dicas
Cómo probar agentes de IA en operaciones de nube con CloudOpsBench
CloudOpsBench publica 45 tareas de operación en la nube para probar tu agente de IA. Mira cómo clonar, validar y ejecutar contra un emulador o AWS real.
6 min
Dicas
5 consejos para operar el escritorio con agent-desktop
Vercel Labs lanzó agent-desktop, una herramienta que permite a agentes de IA operar aplicaciones de escritorio a través del árbol de accesibilidad. Mira cómo funciona.
6 min
Dicas
Cómo seguir las releases de Codex CLI sin romper tu flujo
El repositorio openai/codex publica releases con frecuencia. Mira cómo seguir las nuevas versiones sin poner en riesgo tu flujo de trabajo.
5 min