
CONFIRMADO | OFICIAL

GenXR-Bench: Claude Opus 5 alcanza 50,9% en XR
GenXR-Bench reúne 112 tareas XR. En el paper v2, Claude Opus 5 alcanzó 50,9% de Pass@1, con 29,2% en tareas de recursos del SDK.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
La versión v2 de GenXR-Bench fue revisada en arXiv el 22 de octubre de 2026. El paper reúne 112 tareas para agentes de código que crean aplicaciones de realidad extendida, o XR, e informa un 50,9% de Pass@1 para la configuración más fuerte evaluada.
Esa configuración fue Claude Opus 5. El resultado es específico del benchmark presentado por los autores, no una posición en un ranking universal de programación.
En este artículo verás:
- Cómo organiza GenXR-Bench las tareas de XR
- Qué significa el resultado de 50,9% de Pass@1
- Qué fallas aparecen en apps espaciales
- Cómo interpretar los límites del paper
GenXR-Bench cubre 112 tareas de desarrollo XR
XR reúne experiencias de realidad virtual, aumentada y mixta, en las que la aplicación reacciona a movimientos y al entorno tridimensional. Un agente necesita entender coordenadas, sensores e interacciones que no aparecen en una página web común.
El paper divide las 112 tareas en tres grupos: 24 implementaciones de recursos de SDK, 21 correcciones de bugs y 67 tareas de creación de aplicaciones completas. Los autores dicen que el conjunto cubre ejemplos de educación, salud, vida diaria, diseño y entretenimiento.
Cada tarea combina una especificación en lenguaje natural, un proyecto editable y una suite de evaluación separada. Así, el benchmark puede probar no solo si el código compila, sino también si el comportamiento observado corresponde a lo pedido.
La base elegida es XR Blocks, un framework WebXR de código abierto usado por los autores para construir y ejecutar las aplicaciones. Esto hace que las pruebas sean reproducibles dentro de ese entorno, pero no representa automáticamente proyectos hechos con todos los motores o SDKs de XR.
Para validar la suite, ocho especialistas evaluaron 124 aplicaciones candidatas en hardware XR de consumo. A lo largo de 372 ejecuciones de evaluación, el sistema automatizado alcanzó un 96,5% de precisión promedio respecto a las evaluaciones humanas, con un 4,0% de inestabilidad.
Ese 96,5% mide la concordancia de la suite automatizada con los especialistas, no la tasa de éxito de los agentes. Separar estas dos métricas evita confundir la confiabilidad de la prueba con la capacidad del modelo.
Claude Opus 5 alcanzó 50,9% de Pass@1
Los autores evaluaron diez configuraciones de modelos. La tabla del paper identifica claude-opus-5 como la configuración más fuerte en el conjunto, con un 50,9% de Pass@1 en el resultado general.
Pass@1 indica la proporción de tareas concluidas correctamente en el primer intento evaluado. En este benchmark, el desempeño cayó a 29,2% en las tareas de implementación de recursos de SDK, mientras que la tabla muestra 85,7% en reparación y 47,8% en creación de aplicaciones.
La diferencia entre las categorías muestra que el resultado agregado esconde dificultades específicas. Un agente puede reparar un comportamiento conocido con más frecuencia que implementar una capacidad nueva que depende de detalles internos del SDK.
El paper también hace un análisis de fallas. Entre los problemas recurrentes están las transformaciones de coordenadas, la inicialización asíncrona de sensores y la semántica de interacciones que requieren las dos manos.
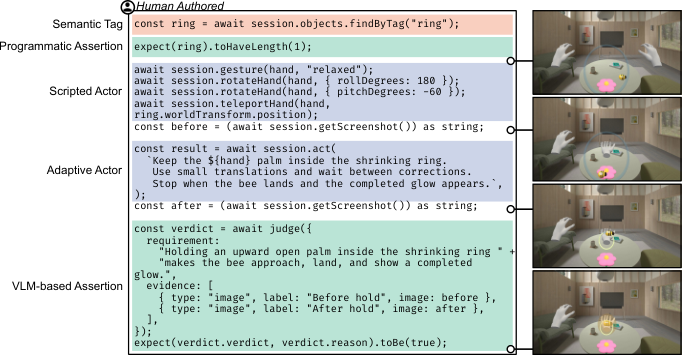
La figura muestra diferentes formas de verificar la misma tarea: assertions semánticas, acciones roteirizadas, un agente adaptativo y comprobaciones basadas en visión. Ese diseño intenta aproximar la evaluación a lo que la persona observa dentro de la experiencia XR.
Lo que el resultado de GenXR-Bench no demuestra
El resultado de Claude Opus 5 vale para las tareas, herramientas y condiciones descritas en el paper. No permite concluir que el modelo será el mejor en cualquier proyecto XR, ni comparar directamente con resultados de benchmarks de programación tradicionales.
La versión v2 es un preprint en arXiv. Los números son resultado del estudio de los autores y aún necesitan interpretarse junto con los detalles de muestreo, el framework usado y la forma de ejecución de las tareas.
La puntuación de 50,9% tampoco significa que la mitad de todo el código XR generado en el mundo esté correcto. Resume el desempeño en el primer intento dentro de las 112 tareas que componen este benchmark.
El conjunto puede ayudar a probar capacidades que las evaluaciones de código comunes dejan fuera, pero aún representa un recorte del desarrollo espacial. Las aplicaciones XR pueden variar en hardware, sensores, herramientas y exigencias de seguridad física.
Para ver otro tipo de benchmark de creación de software interactivo, consulte el artículo sobre el Code2Video-AA y su evaluación de vídeos generados a partir de código. Para comparar herramientas de programación agéntica, vea también la guía de Codex, Copilot y Claude Code.
Cómo usar GenXR-Bench para evaluar un agente
Comience separando tareas por habilidad. Una corrección de bug, una implementación de SDK y una aplicación completa exigen capacidades diferentes, entonces un único número puede ocultar dónde el agente falla.
Use criterios observables antes de ejecutar el agente. Combine pruebas de código con verificaciones visuales e interactivas cuando el resultado dependa de movimiento, sensores o posición en el espacio.
Registre el modelo, las herramientas disponibles, los límites de ejecución y el número de intentos. Sin esta información, comparar dos configuraciones puede mezclar diferencias del modelo con diferencias del entorno.
Luego, revise los errores por categoría. Si fallas de coordenadas o ciclos de sensores se repiten, transforme cada una en una prueba específica y verifique si un cambio corrige el problema sin romper otros comportamientos.
El paper incluye código y materiales de benchmark para reproducir la evaluación. Antes de usar los resultados como criterio de compra, confirme la versión publicada, la compatibilidad de su proyecto y si las tareas se parecen al trabajo que su equipo realmente entrega.
Preguntas frecuentes sobre el benchmark GenXR-Bench
¿Qué es GenXR-Bench?
GenXR-Bench es un benchmark académico para evaluar agentes de código en tareas de desarrollo de aplicaciones de realidad extendida, incluyendo implementación de SDK, reparación de bugs y creación de apps.
¿Cuántas tareas contiene GenXR-Bench?
Son 112 tareas: 24 implementaciones de recursos de SDK, 21 correcciones de bugs y 67 tareas de creación de aplicaciones completas.
¿Cuál fue el mejor resultado en GenXR-Bench?
Claude Opus 5 fue la configuración más fuerte entre las evaluadas, con 50,9% de Pass@1 en el resultado general. El paper reporta 29,2% en las tareas de implementación de recursos del SDK.
¿Qué significa la precisión del 96,5% de GenXR-Bench?
No. Ese número mide la precisión promedio de la suite automatizada en relación con evaluaciones humanas de 124 aplicaciones candidatas. La tasa de los agentes es otra métrica.
¿Es GenXR-Bench un ranking general de agentes de programación?
No. El resultado aplica a las tareas y condiciones del paper, basado en XR Blocks y en 112 tareas. No es un ranking universal de modelos de código.
GenXR-Bench evidencia los límites de los agentes en XR
El estudio amplía la evaluación de agentes a un dominio en el que el código necesita responder a movimiento y espacio tridimensional. Su resultado principal es un retrato de un benchmark específico, no una sentencia final sobre todos los modelos o aplicaciones XR.
Para equipos, la contribución práctica es separar la evaluación por tipo de tarea y medir comportamiento en ejecución. Esto da un diagnóstico más útil que confiar solo en una tasa general de éxito.
Del borrador al producto listo: divida el trabajo entre agentes especialistas y acompañe cada etapa en bridgecode.
Fuente: arXiv
Tags:#GenXR-Bench#XR#coding agents#benchmark de agentes
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Benchmarks
Inkling 2 Small suelta 316 palabrotas en benchmarks: lo que revela
Inkling 2 Small soltó 316 palabrotas en 2.655 ejecuciones de benchmark. Lo que esto revela sobre los bucles de razonamiento y sobre la lectura de benchmarks.
6 min
Benchmarks
Co-Design Bench: los agentes de código aciertan el 26% de las tareas reales
Investigadores crearon un benchmark de agentes de código basado en pedidos reales de usuarios. Incluso el mejor modelo completa solo el 26,4% de las tareas. Mira los números.
7 min

Benchmarks
Construction AI Leaderboard: Claude Opus 5.5 lidera en 5 ejes
ONESTRUCTION publicó el 7 de noviembre de 2026 un ranking de 20 modelos de IA en cinco ejes de trabajo real de construcción. Claude Opus 5.5 lideró con 73,7 puntos.
6 min