
El 29 de octubre de 2026, Doximity publicó un benchmark de dosificaciones. Nueve modelos de lenguaje se equivocaron en al menos el 2,3% de las respuestas evaluadas.

Benchmark de Doximity: los LLMs se equivocan en el 2,3% de las dosis
Doximity evaluó nueve LLMs en 261.508 dosis y encontró al menos un 2,3% de errores, incluyendo fallas graves o potencialmente letales.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
El resultado mide un riesgo específico de la IA clínica. No demuestra que todo uso médico de LLM sea inseguro.
En este artículo vas a ver:
- Cómo Doximity armó la prueba de dosificación.
- Qué errores aparecieron con más frecuencia.
- Qué verifica DoseCheck sin otro LLM.
- Qué permite concluir el benchmark y qué no permite.
Lo que Doximity evaluó en el benchmark de dosis
La evaluación reunió nueve LLM lanzados en 2026 y preguntas de dosificación inspiradas en consultas médicas. La publicación informa 8.530 preguntas respondidas por modelo, cubriendo 2.204 medicamentos.
En total, Doximity analizó 261.508 dosificaciones. La empresa dice que la tasa de error de al menos 2,3% es un límite inferior conservador, no un conteo completo de toda falla posible.
Las preguntas incluían factores que cambian una recomendación, como edad, peso, función renal o hepática e interacciones entre medicamentos. La prueba verificó si los modelos consideraban esa información cuando estaba en el enunciado.
Este recorte importa porque una dosis no depende solo del nombre del medicamento. La formulación, la vía de administración, la frecuencia y las condiciones de la persona también pueden alterar lo que sería apropiado.
La prueba evaluó respuestas sin herramientas externas y con el presupuesto de razonamiento en el nivel más bajo, según la descripción del gráfico. Por lo tanto, mide una configuración específica, no todas las formas de usar los mismos modelos.
Lo que los números de Doximity revelan sobre errores de dosis
Doximity reporta que al menos el 2,3% de las dosificaciones estaban incorrectas. La tasa se presenta como conservadora porque algunas fallas pueden no identificarse con el método de clasificación usado en el estudio.
Casi 20 respuestas por cada mil contenían un error grave, según la escala EQUIP citada por la empresa. En un análisis de sensibilidad con la escala NCC MERP, cerca de 30,5 respuestas por mil quedaron en las categorías E a H.
La publicación clasifica el 43,8% de los errores detectados como graves y el 3,4% como potencialmente letales.
Estos porcentajes describen los errores identificados en el estudio, no la proporción de todas las respuestas dadas en uso real.
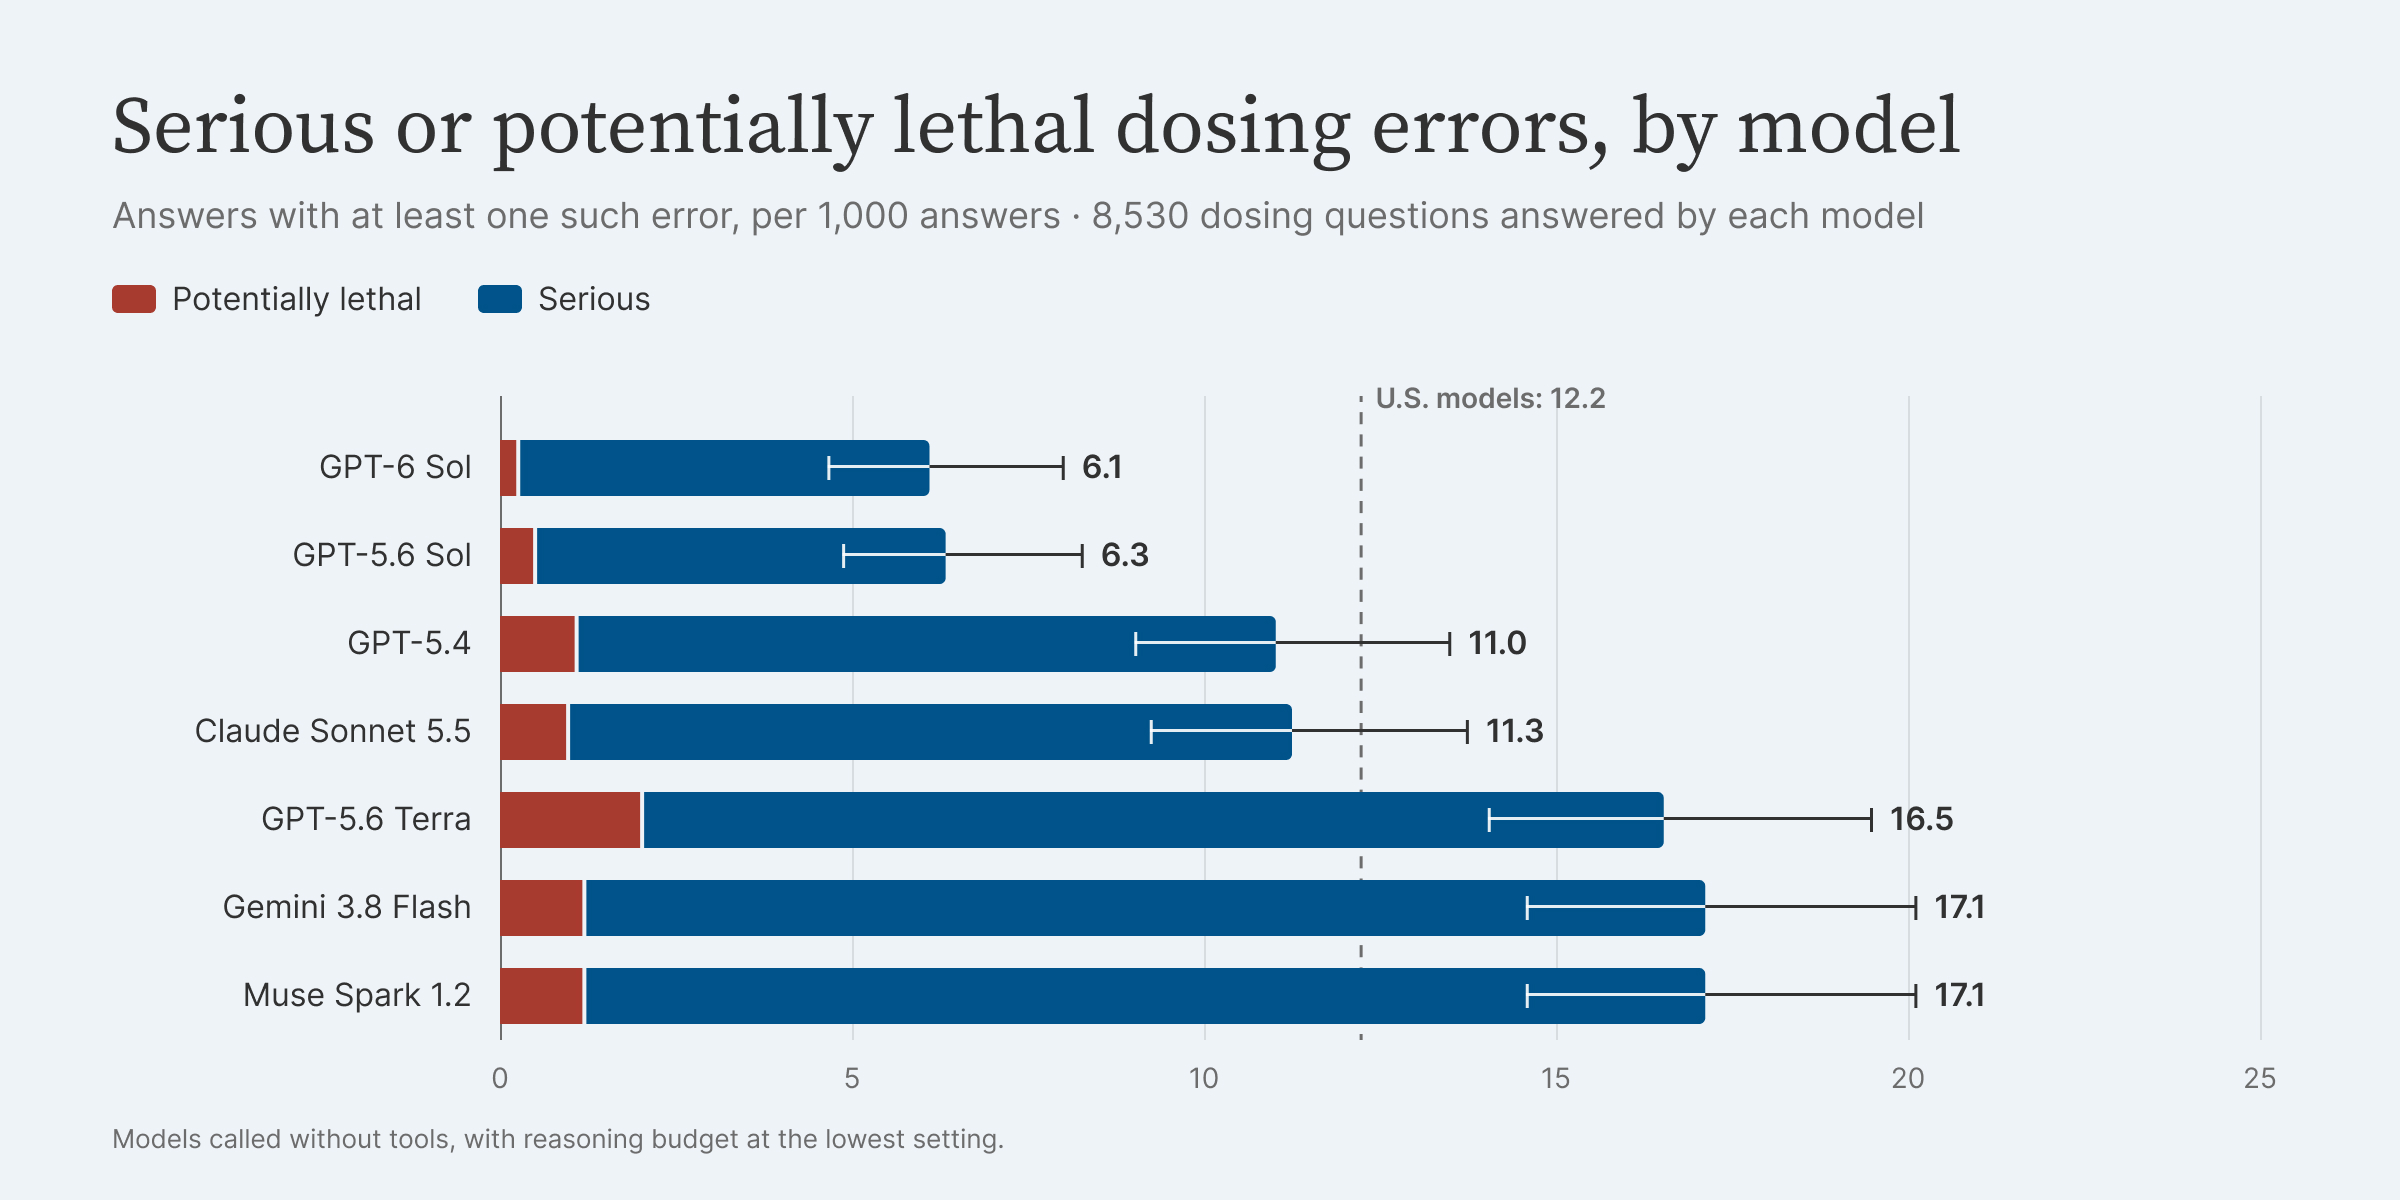
El patrón más común fue no ajustar la dosis a las características de la persona, incluso cuando la pregunta proporcionaba edad, peso o condiciones clínicas. Doximity también observó mayor riesgo en medicamentos aprobados en 2024 o después.
En el análisis divulgado, los medicamentos más recientes tuvieron 5,1 veces las probabilidades de error, tras ajustes por modelo, tipo de pregunta y vía de administración. La empresa informa un intervalo de confianza de 3,9 a 6,5 para esa estimación.
| Medida informada por Doximity | Resultado |
|---|---|
| Modelos evaluados | 9, todos lanzados en 2026 |
| Preguntas respondidas por modelo | 8.530 |
| Medicamentos cubiertos | 2.204 |
| Dosificaciones evaluadas | 261.508 |
| Dosificaciones incorrectas | Al menos 2,3% |
| Errores graves | Casi 20 por mil respuestas |
Como el DoseCheck verifica una dosis sin consultar otro LLM
Junto al estudio, Doximity presentó DoseCheck, una capa de verificación de dosis para Doximity Ask. En lugar de pedirle a otro modelo que revise la respuesta, el sistema compara las afirmaciones con una base estructurada de medicamentos.
La empresa describe un flujo que extrae el medicamento, la dosis, la vía, la frecuencia y las indicaciones relevantes. Luego, compara esos campos con referencias estructuradas y señala cuando encuentra una coincidencia.
Según Doximity, la base RxIndex combina prospectos de la FDA, guías y literatura primaria. La empresa informa cobertura de 1.900 monografías y más de 36 mil esquemas de dosificación, separados por indicación, población y vía.
Cuando la dosis coincide con los registros, el profesional ve un sello verde y puede abrir la referencia completa.
La empresa afirma que la verificación retorna en menos de 100 milisegundos. Esa velocidad es información del proveedor, no una auditoría independiente.
La propia publicación recalca que DoseCheck no sustituye el juicio clínico.
El estudio y el producto son cosas distintas. Los resultados describen respuestas de los modelos, mientras que la herramienta aplica una verificación determinista después de la generación.
Qué no prueba el benchmark de Doximity sobre IA clínica
El anuncio es una publicación de la propia Doximity, que también desarrolla DoseCheck.
Ese contexto no invalida los datos. Aun así, importa al interpretar una prueba divulgada por una empresa que presenta una solución relacionada.
La muestra no representa a todos los modelos, versiones, preguntas médicas o flujos con búsqueda y herramientas.
El resultado no predice la tasa de error de un producto específico. Para eso, sería necesario repetir la evaluación en la configuración y los casos de ese sistema.
Esa cautela vale para benchmarks en general. En la prueba SnowPR con tareas reales de código, el equipo delimita lo que se puede generalizar.
Para comparar tipos de prueba, vea el análisis del Artificial Analysis Index v5.
Para quien construye aplicaciones, la lección es separar tareas probabilísticas de verificaciones exactas.
Un modelo puede resumir evidencias. Unidades, límites, conversiones y reglas de dosificación exigen fuentes confiables, validación explícita y revisión de profesionales habilitados.
El benchmark muestra por qué la fluidez no basta para decidir si un sistema es seguro.
En áreas de alto riesgo, las pruebas deben cubrir casos límite, cambios de versión, datos ausentes y fallas de extracción. También deben registrar el origen de cada regla.
Preguntas frecuentes sobre el benchmark de dosificaciones de Doximity
¿Qué evaluó Doximity en el benchmark de dosificaciones?
Doximity probó nueve LLMs con preguntas de dosis para 2.204 medicamentos. La publicación informa 8.530 preguntas respondidas por modelo.
¿Cuántas dosis incorrectas encontró Doximity?
La empresa reporta al menos un 2,3% de dosificaciones incorrectas en el conjunto analizado. Describe esa tasa como un límite inferior conservador.
¿El benchmark prueba que todos los LLMs son inseguros para medicina?
No. Cubre nueve modelos y una configuración específica de preguntas sin herramientas externas, por lo que no representa a todos los modelos ni a todos los flujos clínicos.
¿Qué hace DoseCheck?
DoseCheck compara campos de una dosis, como medicamento, cantidad, vía y frecuencia, con una base estructurada. Doximity dice que no sustituye el juicio clínico.
¿Doximity publicó un ranking universal de los modelos?
No. La publicación presenta resultados de una tarea delimitada y de un método propio, no un ranking que determine qué modelo es mejor para cualquier uso médico.
Validación determinística debe acompañar a la IA clínica
El estudio de Doximity no es un ranking universal de modelos. Es una alerta cuantificada sobre una tarea estrecha e importante, con una configuración de prueba descrita por la propia empresa.
Para equipos técnicos, el camino prudente es medir el sistema que realmente se usará y agregar verificaciones determinísticas donde haya una respuesta comprobable.
La decisión clínica sigue con los profesionales, no con el porcentaje de un benchmark.
Del borrador al producto listo, divida el trabajo entre agentes especialistas y acompañe cada etapa en bridgecode.
Fuente: Doximity
Tags:#Doximity#LLM#benchmark#segurança clínica#DoseCheck#dosagem
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados

Benchmarks
Construction AI Leaderboard: Claude Opus 5.5 lidera en 5 ejes
ONESTRUCTION publicó el 7 de noviembre de 2026 un ranking de 20 modelos de IA en cinco ejes de trabajo real de construcción. Claude Opus 5.5 lideró con 73,7 puntos.
6 min

Benchmarks
RoleRouteBench: lo que el enrutamiento revela en sistemas multiagente
RoleRouteBench es un entorno reproducible para evaluar el enrutamiento dinámico de roles en tareas de múltiples etapas. Consulta los resultados de JEV 1.13 en los cuatro dominios.
6 min

Benchmarks
CloudOpsBench: agentes de IA en operaciones en la nube
CloudOpsBench mide cómo los agentes de IA ejecutan tareas reales de operación en la nube. El mejor agente resuelve el 60,6% de las 45 tareas en AWS. Mira los números.
7 min