
Resumo: O Google lançou a Gemini Decisions API, que usa o modelo gemini-decision-1 para avaliar até 1.000 perguntas fechadas em uma única passada e devolver probabilidades, sem gerar texto.
Newsletter4 min
Google lança Gemini Decisions API: decisões calibradas sem gerar texto
O Google lançou a Gemini Decisions API, que usa o modelo Gemini Decision 1 para avaliar até 1.000 perguntas fechadas e devolver probabilidades, sem gerar texto.

Marcelo Santiago
Criador do bridgecode
A maior newsletter de IA do Mundo
Receba artigos sobre IA no seu e-mail
Curadoria técnica sobre modelos, agentes e ferramentas de código. Sem spam, cancele quando quiser.
Em 11 de novembro de 2026, o Google apresentou a Gemini Decisions API, um endpoint para decisões de conjunto fechado, como escolher uma ferramenta, rotear uma requisição ou checar uma política. Ela usa o novo modelo gemini-decision-1, disponível pela Gemini API no Google AI Studio.
Ao contrário de um modelo generativo, que produz texto e obriga o código a interpretar a resposta, a Decisions API pontua as opções candidatas e devolve probabilidades. O agente decide para onde ir, e um modelo gerador só entra quando há texto a produzir.
O que muda: pontuar opções em vez de gerar texto
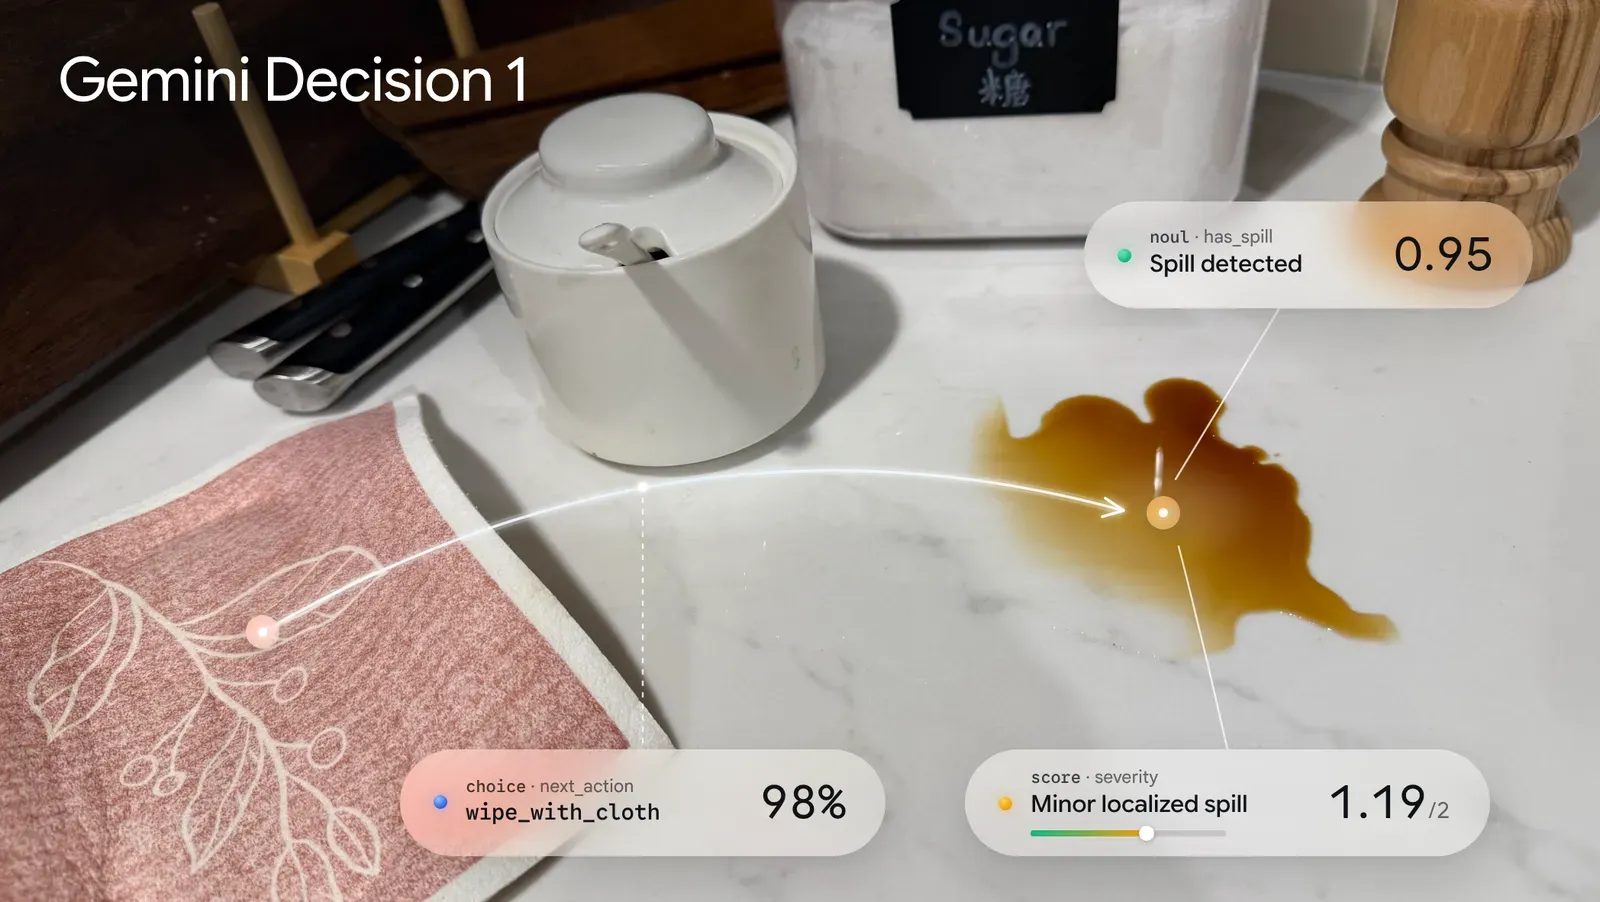
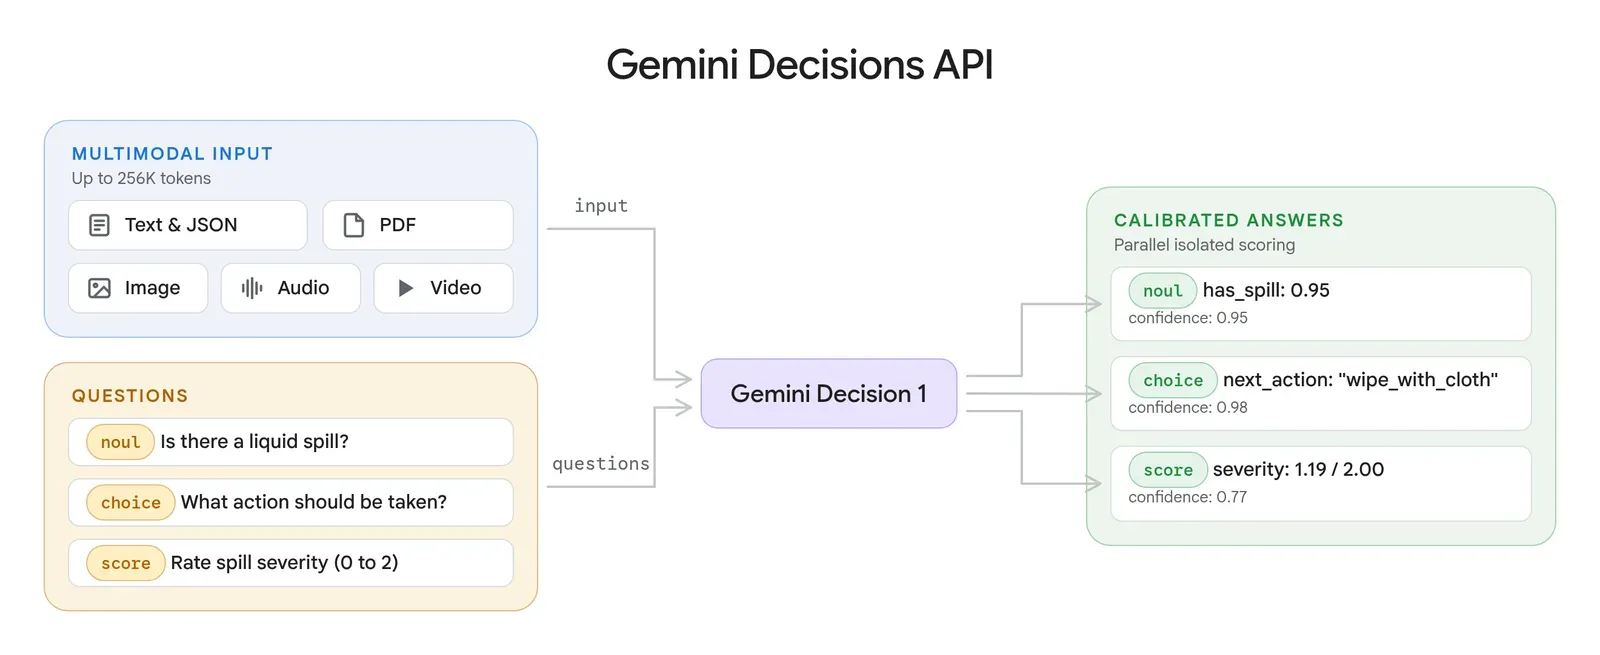
Segundo a documentação, um modelo generativo adiciona latência e lógica de parsing frágil a decisões simples. O Gemini Decision 1 evita esse passo: ele avalia as perguntas em uma única passada de leitura da entrada e devolve probabilidades calibradas e uma pontuação de confiança, com zero tokens de saída.
Existem três tipos de pergunta:
- Sim ou não: probabilidade de 0,01 a 0,99 e confiança.
- Escolha: de 2 a 255 opções, com a opção principal, a probabilidade de cada uma e a confiança.
- Nota por rubrica: de 2 a 255 níveis ordenados, com a nota esperada ponderada pela probabilidade.
Como funciona na prática
Uma requisição aceita uma entrada multimodal (texto, imagem, áudio, vídeo e PDF, até 262.144 tokens) e até 1.000 perguntas independentes sobre ela. A entrada compartilhada é processada uma vez, e cada pergunta acrescenta só as próprias instruções e critérios.
Isso encaixa bem em checagens em lote, como "cita a fonte?", "contém dado pessoal?" ou "qual destas três filas deve atender?". Os limites importam: segundo a página do modelo, não há geração de texto, function calling, saídas estruturadas, cache, Batch API nem Live API, e a API está na versão v1beta.
Preço e latência
O Google informa 150 a 250 ms de latência de ponta a ponta e US$ 0,10 por milhão de tokens de entrada, sem cobrança de saída. Há um nível sem custo no AI Studio para protótipos.
No mesmo segmento de tarefas repetitivas de agentes, o Meta Muse Ember também custa US$ 0,10 por milhão de tokens de entrada. A diferença é que o Muse Ember gera texto, enquanto o gemini-decision-1 só pontua opções.
O que é alegação do Google
O Google compara o modelo com o TypeSafe Jev 1.14, com a Decisions API do GPT-6 Luna (OpenAI) e com o Gemini 3.5 Flash-Lite na Interactions API. Todos os números abaixo são do próprio Google e não foram verificados de forma independente.
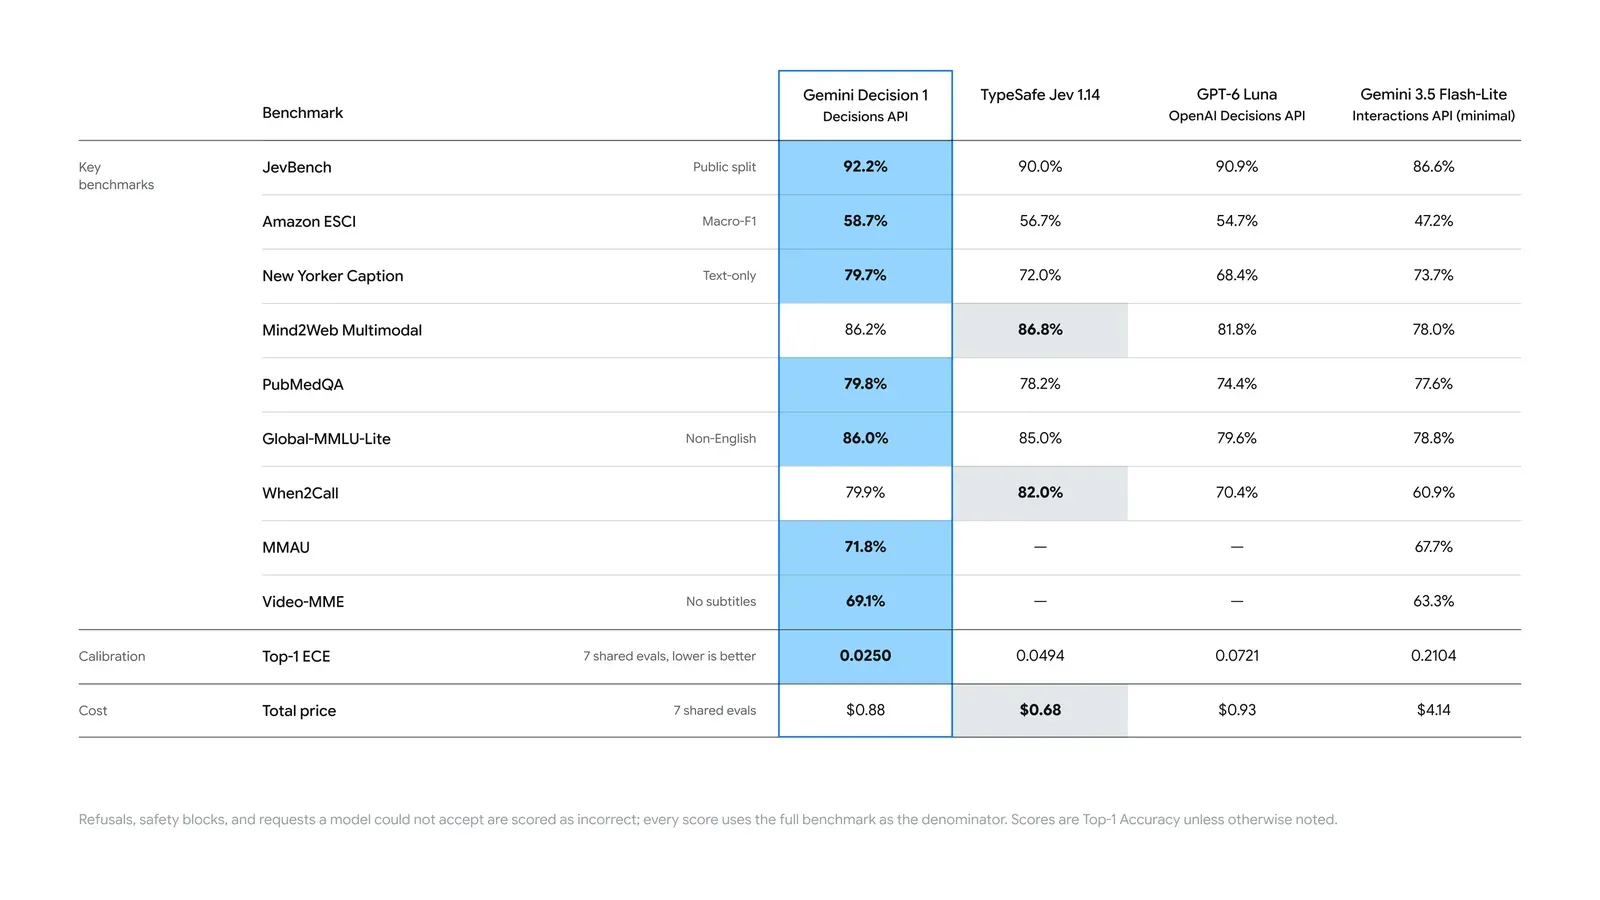
O Gemini Decision 1 lidera 7 dos 9 benchmarks da tabela. No JevBench, marca 92,2%, contra 90,0% do TypeSafe Jev, 90,9% do GPT-6 Luna e 86,6% do Flash-Lite. No erro de calibração Top-1 (menor é melhor), tem 0,0250, contra 0,0494, 0,0721 e 0,2104.
Houve dois testes em que ele não vence: o TypeSafe Jev fica na frente no Mind2Web Multimodal (86,8% contra 86,2%) e no When2Call (82,0% contra 79,9%). No custo total de 7 avaliações compartilhadas, o TypeSafe Jev também é mais barato (US$ 0,68 contra US$ 0,88). O GPT-6 Luna custa US$ 0,93 e o Flash-Lite, US$ 4,14.
O anúncio cita quatro usos internos: roteamento de modelos no Gemini Notebook (até 40% menos latência), edição no Stitch, escolha de emojis no CC e uma camada de segurança para ferramentas MCP na Busca. Eles mostram o perfil da API, mas não garantem o mesmo resultado em outras cargas de trabalho.
Como testar hoje
O caminho documentado é pelo Google AI Studio: crie uma chave de API e use o modelo gemini-decision-1. A documentação da API traz o formato exato da requisição, que não reproduzimos aqui porque ainda não rodamos o endpoint.
Para testar sem escrever código, a página do modelo lista três apps de exemplo no AI Studio: o Decisions Playground, para perguntas de sim ou não, escolha e nota sobre textos e mídias próprios; o Doorstep Parcels, que classifica fotos de entrega; e o Find the Zookeeper, que avalia atributos visuais de cenas.
Um teste sensato é pegar um roteamento que hoje usa um modelo generativo, montar de 20 a 50 casos com a resposta esperada e comparar acerto, latência e custo. Como a API está em v1beta, trate o resultado como preliminar. A integração com OpenRouter, LangChain, Vercel, LiteLLM e OpenCode está em andamento.
Perguntas frequentes sobre a Gemini Decisions API
O que a Gemini Decisions API resolve?
Decisões de conjunto fechado em uma única passada: roteamento de requisições, checagem de política, escolha de ferramenta ou pontuação de candidatos, sem gerar texto.
O modelo explica a decisão?
Não. O gemini-decision-1 não gera texto. A saída é uma probabilidade, uma distribuição entre opções ou uma nota por rubrica, mais uma pontuação de confiança.
Como a cobrança funciona?
O Google informa US$ 0,10 por milhão de tokens de entrada e nenhuma cobrança de saída. A entrada compartilhada é cobrada uma vez por requisição.
Quais entradas são aceitas?
Texto, imagem, áudio, vídeo e PDF, até 262.144 tokens, com até 1.000 perguntas independentes por requisição.
A API já é estável?
Não. Está na versão v1beta, sem function calling, cache nem Batch API. Confirme limites e disponibilidade na documentação antes de usar em produção.
O que isso significa para quem constrói agentes
A API funciona como camada de controle rápida e barata: o agente decide o caminho, e o modelo gerador só entra quando há texto a produzir. O Google também vem reforçando a infraestrutura para essa era de agentes, como mostramos na cobertura dos TPU 8tx e 8i Max. Para orquestrar agentes que planejam, executam e revisam em paralelo, conheça o bridgecode.
Fonte: Anúncio do Google
Tags:#radar#ia
Desenvolvedor e criador do bridgecode, ambiente de desenvolvimento agêntico para orquestrar squads de agentes de IA. Ajuda quem vai do vibe coding ao desenvolvimento profissional a sair da ideia e chegar ao produto entregue.
Artigos relacionados
Newsletter
Automattic une apps de vibe coding em uma plataforma para publicar no mundo web
Automattic une apps de vibe coding em uma plataforma para publicar apps no mundo web. Veja como funciona e o que muda para equipes que criam com IA.
4 min
Newsletter
Medium lança TK, app de notas com IA no editor
O Medium lançou o TK, um app de notas e escrita com assistente de IA embutido no editor. Veja como funciona e o que muda para quem escreve.
6 min
Newsletter
Otter.ai lança maior expansão multilíngue da sua história
O Otter.ai anunciou 27 novos idiomas e transcrição multilíngue que acompanha a troca de idioma dentro de uma mesma reunião. Veja o que muda e como testar.
6 min