
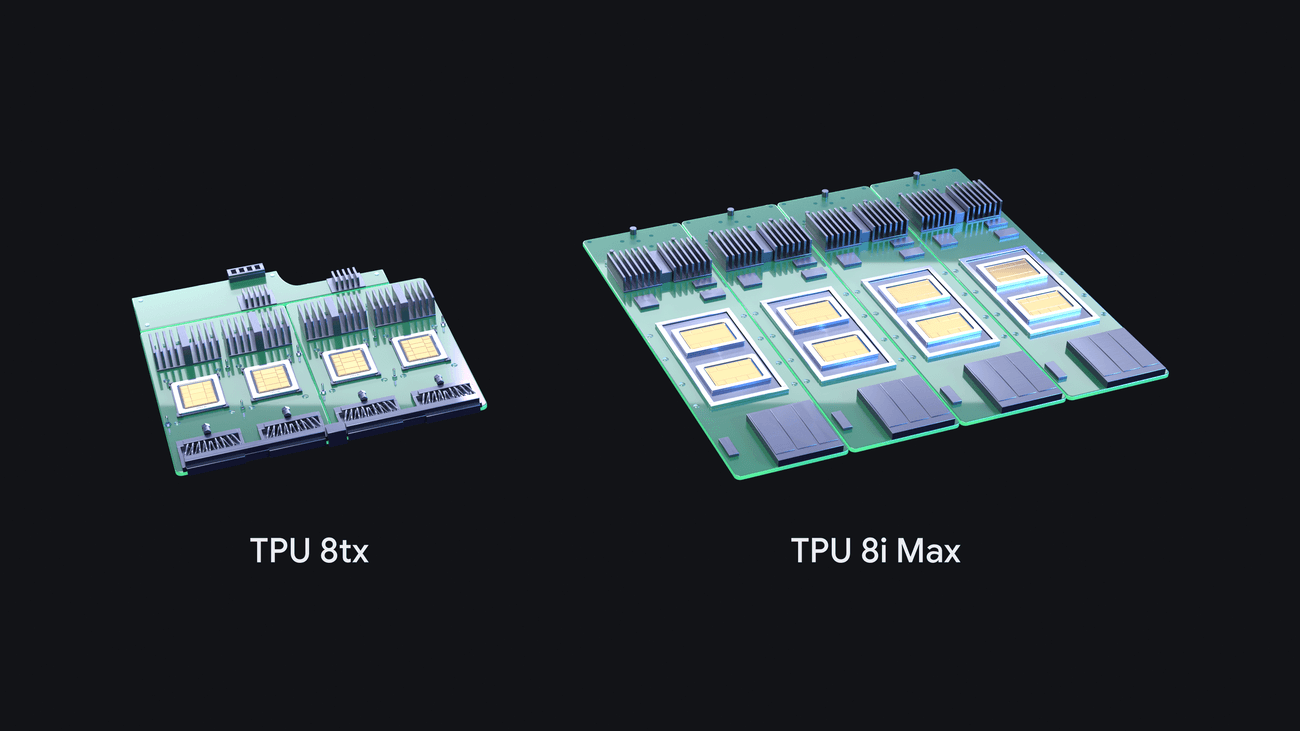
O Google anunciou em 9 de novembro de 2026 dois novos sistemas da oitava geração de TPU: o TPU 8tx, focado em inferência confidencial, e o TPU 8i Max, voltado a janelas de contexto massivas. Com isso, a oitava geração passa a ter quatro sistemas, algo inédito para a empresa em um único ano.
Google lança TPU 8tx e 8i Max para a era dos agentes de IA
O Google anuncia TPU 8tx para inferência confidencial e 8i Max para contextos massivos, completando quatro sistemas na oitava geração em um único ano.

Marcelo Santiago
Criador do bridgecode
A maior newsletter de IA do Mundo
Receba artigos sobre IA no seu e-mail
Curadoria técnica sobre modelos, agentes e ferramentas de código. Sem spam, cancele quando quiser.
A motivação é a mudança no perfil de carga. Agentes de IA não apenas respondem perguntas: eles executam tarefas em múltiplas etapas, acessam dados sensíveis e processam contextos enormes, como bases de código inteiras ou horas de vídeo. Hardware genérico não atende esses dois extremos.
TPU 8tx: inferência confidencial com segurança em hardware
O TPU 8tx é o terceiro sistema da oitava geração. Ele é otimizado para inferência segura e confidencial, e também serve para treinamento em pequena escala. O público-alvo são empresas reguladas e governos que rodam modelos de fronteira ou proprietários junto com dados sensíveis e agentes autônomos.
O diferencial é a segurança em nível de hardware. Normalmente, dados são criptografados em repouso e em trânsito, mas precisam ser desbloqueados na memória durante o processamento. O TPU 8tx mantém dados e pesos do modelo protegidos e isolados mesmo durante o uso ativo, construindo a segurança diretamente na camada de hardware.
O sistema usa a mesma silício do TPU 8t, com hosts de CPU AMD EPYC de quinta geração, e adota a rede Boardfly de baixa latência criada para raciocínio em tempo real. O resultado é até 2 vezes menos latência em comparação com o TPU 8t, com penalidade de desempenho próxima de zero.
Como o sistema combina computação de treinamento com uma rede rápida de inferência, organizações podem simultaneamente rodar e personalizar modelos em um único sistema: fine-tuning com dados privados, destilação de modelos grandes em menores e treinamento de agentes por aprendizado por reforço, sem migrar dados sensíveis entre clusters.
TPU 8i Max: dobrar compute e memória no mesmo espaço
O TPU 8i Max resolve um problema diferente: o muro de memória. Quando dezenas de agentes trabalham juntos sobre uma base de código inteira ou horas de vídeo, a largura de banda de memória vira gargalo rapidamente.
A solução foi combinar dois chips TPU 8i de baixa latência em um único pacote. O 8i Max entrega o dobro de compute, o dobro de SRAM e o dobro de largura de banda de HBM em comparação com o 8i, mantendo processadores abastecidos com os dados essenciais e evitando que cargas grandes travem.
Como o 8i Max cabe o dobro de silício no mesmo espaço de rack, data centers conseguem implantar significativamente mais poder de computação por metro quadrado e por watt.
Como os quatro sistemas se complementam
Juntos, os quatro sistemas da oitava geração cobrem cada etapa do ciclo de vida agêntico. O TPU 8t serve para treinamento em escala, com superpods de até 9.600 chips. O TPU 8i é otimizado para raciocínio em tempo real, com 80% melhor desempenho por dólar em inferência de baixa latência para modelos MoE. O TPU 8tx cobre computação confidencial para empresas reguladas. O TPU 8i Max atende janelas de contexto massivas e máxima densidade de compute por rack.
Essa é a primeira vez que o Google introduz quatro sistemas TPU em um único ano. A empresa também reforça o compromisso com software aberto: suporte a PyTorch, ferramentas open-source e automação para desenvolvedores, com o objetivo de tornar as TPUs acessíveis a todo desenvolvedor e cliente de nuvem.
Como testar o TPU 8tx e o 8i Max hoje
O anúncio não inclui instruções de acesso direto. O Google direciona interessados para a página de TPUs no Google Cloud e para a apresentação ao vivo transmitida no dia do anúncio.
Para quem já usa TPUs na nuvem, vale acompanhar as atualizações de disponibilidade regional e os novos planos de consumo que a empresa mencionou, incluindo o Agent Compute Engine como API para clientes de nuvem. Equipes que rodam agentes com contextos longos devem avaliar se o 8i Max reduz a necessidade de particionar o contexto entre múltiplos chips.
Perguntas frequentes sobre o TPU 8tx e o 8i Max do Google
O que é o TPU 8tx?
É o terceiro sistema da oitava geração de TPU do Google, otimizado para inferência segura e confidencial, com segurança em nível de hardware e até 2 vezes menos latência que o TPU 8t.
O que é o TPU 8i Max?
É o quarto sistema da oitava geração, que combina dois chips TPU 8i em um pacote para entregar o dobro de compute, SRAM e largura de banda de HBM, voltado a janelas de contexto massivas.
Quantos sistemas tem a oitava geração de TPU?
Quatro: TPU 8t para treinamento em escala, TPU 8i para raciocínio em tempo real, TPU 8tx para computação confidencial e TPU 8i Max para contextos massivos.
Por que o Google lançou quatro sistemas em um ano?
A empresa afirma que é a primeira vez que introduz quatro sistemas TPU em um único ano, respondendo à mudança no perfil de carga dos agentes de IA.
Os sistemas já estão disponíveis?
O anúncio não detalha disponibilidade nem preços. O Google transmitiu uma apresentação ao vivo no mesmo dia com mais informações.
O que muda para quem constrói agentes
Para quem desenvolve agentes de IA em produção, a mensagem é que a infraestrutura está se especializando. Segurança de dados, latência de raciocínio e escala de contexto deixam de ser compromissos e passam a ter hardware dedicado.
A disponibilidade dos sistemas e os preços não foram detalhados no anúncio. O Google também transmitiu uma apresentação ao vivo no mesmo dia com mais detalhes. Quem acompanha a infraestrutura de IA pode comparar com o Google Antigravity ganhando modo de voz para orientar agentes e com a Gemini Omni 1.2 Flash gerando vídeos de até 15 segundos.
O anúncio também destaca que as TPUs já têm quase 100 clientes externos e que a oitava geração oferece até 2,7 vezes melhor desempenho de treinamento e 80% melhor desempenho por dólar em inferência em comparação com a geração anterior. Isso coloca a infraestrutura do Google em posição de competir diretamente com as ofertas de aceleradores da NVIDIA e da AMD no segmento de agentes.
Fonte: Google
Tags:#Google#TPU#infraestrutura#agentes#hardware
Desenvolvedor e criador do bridgecode, ambiente de desenvolvimento agêntico para orquestrar squads de agentes de IA. Ajuda quem vai do vibe coding ao desenvolvimento profissional a sair da ideia e chegar ao produto entregue.
Artigos relacionados
Newsletter
Automattic une apps de vibe coding em uma plataforma para publicar no mundo web
Automattic une apps de vibe coding em uma plataforma para publicar apps no mundo web. Veja como funciona e o que muda para equipes que criam com IA.
4 min
Newsletter
Medium lança TK, app de notas com IA no editor
O Medium lançou o TK, um app de notas e escrita com assistente de IA embutido no editor. Veja como funciona e o que muda para quem escreve.
6 min
Newsletter
Otter.ai lança maior expansão multilíngue da sua história
O Otter.ai anunciou 27 novos idiomas e transcrição multilíngue que acompanha a troca de idioma dentro de uma mesma reunião. Veja o que muda e como testar.
6 min