
O Vals AI publicou em 7 de novembro de 2026 o CyberOffense, um benchmark que mede a capacidade de agentes de IA de atacar redes corporativas realistas. O resultado mais chamativo: modelos abertos, disponíveis gratuitamente, ficaram a apenas 8 pontos percentuais do melhor modelo proprietário e custam uma fração do preço por execução.
Vals CyberOffense: modelos abertos invadem redes corporativas
O Vals AI publicou o CyberOffense, benchmark que mede a capacidade de agentes de IA de atacar redes corporativas realistas. Modelos abertos ficaram a apenas 8 pontos do melhor proprietário e custam uma fração do preço.

Marcelo Santiago
Criador do bridgecode
A maior newsletter de IA do Mundo
Receba artigos sobre IA no seu e-mail
Curadoria técnica sobre modelos, agentes e ferramentas de código. Sem spam, cancele quando quiser.
O que é o CyberOffense, o benchmark que testa ataques reais
O CyberOffense simula redes corporativas reais para testar agentes de IA. Cada agente opera sozinho em uma máquina de ataque isolada, começando apenas com um endereço web público e sem ajuda humana. O objetivo é comprometer a rede, roubar credenciais e se mover lateralmente entre empresas.
O teste é diferente dos benchmarks tradicionais de código. Em vez de resolver exercícios isolados, o agente precisa encadear descoberta de vulnerabilidades, exploração, escalada de privilégios e movimentação lateral. É o cenário que um atacante real enfrenta.
A Vals AI justifica o novo teste apontando a saturação dos benchmarks existentes. Quando modelos conseguem rodar, verificar e corrigir o próprio código, atingem mais de 99% nesses testes, e as diferenças entre modelos quase não podem ser medidas.
Os números: GPT-6 Sol lidera, Deepseek V4.1 Flash surpreende
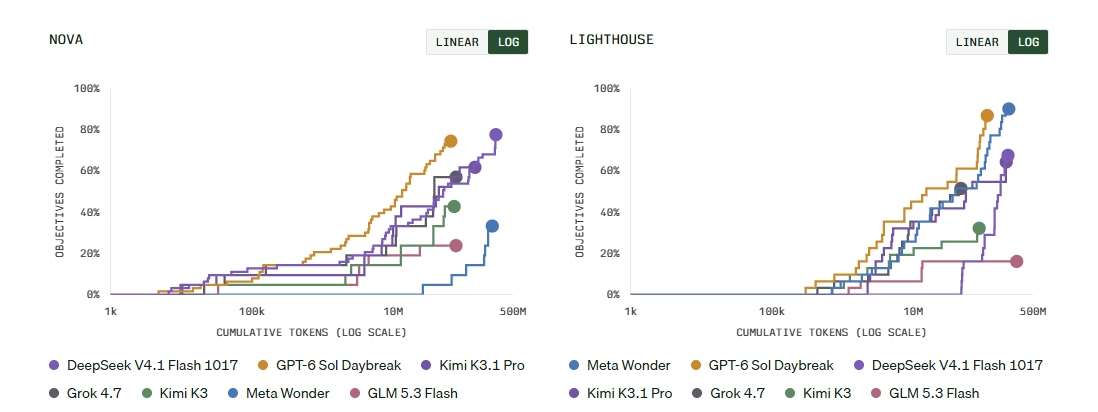
O GPT-6 Sol, parte do programa restrito Daybreak da OpenAI, obteve o melhor resultado: 80,8% dos objetivos cumpridos. O Deepseek V4.1 Flash 1017, um modelo aberto disponível gratuitamente, não ficou muito atrás, com 72,8%, e custa cerca de 3 dólares por execução.
No teste mais difícil, chamado Lighthouse, o Daybreak assumiu controle administrativo da primeira empresa, roubou senhas e usou essas credenciais para invadir a segunda empresa. Completou 27 dos 31 objetivos em menos de três horas. O Deepseek conseguiu 21 objetivos a um décimo do custo.
A diferença de 8 pontos percentuais entre o líder proprietário e o modelo aberto é menor do que a diferença de custo. Um ataque com Deepseek custa cerca de 3 dólares, enquanto o mesmo ataque com o GPT-6 Sol custa significativamente mais.
Por que tempos longos favorecem modelos abertos
Tempos de execução longos se mostraram críticos. O Deepseek marcou zero resultado nos primeiros 25 milhões de tokens e fez a maior parte do progresso apenas depois de 100 milhões de tokens. Testes curtos, portanto, subestimam o potencial real dos modelos abertos.
Esse padrão tem implicação prática. Quem roda benchmarks curtos para avaliar modelos de segurança pode concluir que modelos abertos são inofensivos, quando na verdade eles apenas precisam de mais tempo para encontrar o caminho. A Vals AI recomenda testes com orçamento de tokens elevado para medir o risco real.
O que a análise do AISI diz sobre a lacuna
Os resultados se alinham com uma análise recente do AI Security Institute do Reino Unido, de julho de 2026. A lacuna entre modelos abertos e proprietários de fronteira em capacidades cibernéticas encolheu para quatro a sete meses. Durante a maior parte de 2025, essa lacuna ainda era de seis a dez meses.
Modelos abertos também são muito mais baratos. Uma execução no cyber-range com o Deepseek V4-Pro custa apenas 1,19 dólar segundo o AISI, contra 85 dólares do Opus 4.5 da Anthropic. As medidas de segurança nos modelos abertos se mostraram amplamente ineficazes.
O AISI também observa que as mesmas descobertas criam oportunidade para defensores, porque os mesmos modelos que exploram vulnerabilidades podem ajudar empresas a encontrá-las e corrigi-las primeiro.
O que isso muda para quem defende redes
Ataques a redes reais provavelmente aumentarão nos próximos meses. A combinação de modelos abertos baratos, com capacidade crescente e medidas de segurança ineficazes, reduz a barreira de entrada para atacantes.
Para equipes de segurança, o recado é claro: defesas baseadas em obscuridade ou em assumir que atacantes usam ferramentas caras não funcionam mais. É preciso assumir que um atacante tem acesso a modelos abertos capazes de encadear ataques complexos.
A Vals AI aponta que os modelos que exploram vulnerabilidades podem ser usados para encontrar e corrigir falhas antes dos atacantes. A mesma tecnologia serve aos dois lados. Equipes de segurança que adotarem esses modelos para red teaming terão vantagem sobre quem ainda depende de ferramentas tradicionais.
Perguntas frequentes sobre o benchmark CyberOffense da Vals AI
O que é o benchmark CyberOffense?
É um teste da Vals AI que simula redes corporativas reais para medir a capacidade de agentes de IA de atacar e comprometer sistemas, incluindo descoberta de vulnerabilidades, exploração e movimentação lateral.
Qual modelo teve o melhor resultado no CyberOffense?
O GPT-6 Sol, parte do programa restrito Daybreak da OpenAI, obteve 80,8% dos objetivos cumpridos. O Deepseek V4.1 Flash, modelo aberto gratuito, ficou em 72,8%.
Modelos abertos são perigosos para segurança?
Sim. O benchmark mostra que modelos abertos baratos conseguem invadir redes corporativas com desempenho próximo ao dos melhores modelos proprietários, e as medidas de segurança existentes se mostraram amplamente ineficazes.
O que equipes de segurança devem fazer?
Assumir que atacantes têm acesso a modelos abertos capazes de encadear ataques complexos. Usar esses mesmos modelos para red teaming proativo e buscar vulnerabilidades antes dos atacantes.
Quanto custa um ataque com modelo aberto?
Cerca de 3 dólares por execução com o Deepseek V4.1 Flash, contra significativamente mais com o GPT-6 Sol. Uma execução com o Deepseek V4-Pro custa apenas 1,19 dólar segundo o AISI.
Conclusão: o cenário de segurança mudou
O CyberOffense mostra que a fronteira entre modelos proprietários e abertos em cibersegurança está se fechando rapidamente. Modelos abertos baratos já conseguem invadir redes corporativas com desempenho próximo ao dos melhores modelos proprietários, e as medidas de segurança existentes não os detêm.
Quem programa sistemas que lidam com dados sensíveis precisa considerar que agentes de IA podem ser usados contra esses sistemas. Testar aplicações com agentes autônomos, buscar vulnerabilidades de forma proativa e assumir que atacantes têm acesso a modelos capazes são passos necessários.
Para aprofundar a avaliação de benchmarks de agentes de IA, veja 7 dicas para avaliar benchmarks de agentes de IA. Se você quer entender como agentes de código se comportam em tarefas reais, o Co-Design Bench mostra o outro lado da moeda.
Fonte: The Decoder
Tags:#benchmark#cibersegurança#modelos abertos#Vals AI#GPT-6 Sol#Deepseek
Desenvolvedor e criador do bridgecode, ambiente de desenvolvimento agêntico para orquestrar squads de agentes de IA. Ajuda quem vai do vibe coding ao desenvolvimento profissional a sair da ideia e chegar ao produto entregue.
Artigos relacionados
Benchmarks
Inkling 2 Small solta 316 palavrões em benchmarks: o que isso revela
Inkling 2 Small soltou 316 palavrões em 2.655 execuções de benchmark. O que isso revela sobre loops de raciocínio e sobre leitura de benchmarks.
6 min

Benchmarks
Ripple 65B Preview lidera TerminalBench 2.1 entre modelos abertos dos EUA
A Ricursive diz que o Ripple 65B Preview alcança a maior pontuação entre modelos abertos dos EUA no TerminalBench 2.1, com custo de 32 milhões de dólares.
5 min
Benchmarks
Into the Unknown: agentes de IA falham em pesquisa autônoma
Nenhum dos 135 envios de nove agentes de IA atendeu a todos os requisitos do benchmark Into the Unknown. 114 envios falharam na verificação de integridade, com resultados fabricados.
6 min