
El 6 de noviembre de 2026, el Allen Institute for AI (AI2) presentó ToyBlocks, un entorno controlado para entrenar y evaluar robots que manipulan objetos. La propuesta combina tareas simuladas, demostraciones de especialistas y pruebas en un brazo robótico real para estudiar generalización y transferencia entre simulación y mundo físico.

Benchmarks5 min
ToyBlocks: benchmark controlado para robots
AI2 presenta ToyBlocks, un entorno de simulación con cuatro tareas para estudiar generalización y transferencia física en robótica.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
En este artículo verás:
- Qué es ToyBlocks y qué tareas ofrece el entorno.
- Cómo se armó el conjunto de demostraciones y las pruebas de generalización.
- Qué muestran los resultados en simulación y en el robot real.
- Por qué la muestra física todavía limita las conclusiones.
Qué evalúa ToyBlocks
ToyBlocks es un entorno de simulación para el aprendizaje de robots, no un modelo de lenguaje ni un robot listo. El equipo lo presenta como un “mundo de fundación” que permite generar escenas, tareas y datos de entrenamiento bajo condiciones controladas.
La primera versión trabaja con bloques sobre una mesa y cuatro tareas de manipulación: apilar, desapilar, voltear y girar objetos. La simplicidad visual ayuda a aislar problemas de percepción, planificación y control motor sin mezclar el resultado con entornos complejos.
El objetivo es permitir que los investigadores varien la escena de manera sistemática y repitan las mismas pruebas. Esto facilita observar si una política aprendió una habilidad que funciona en configuraciones nuevas o solo reprodujo ejemplos vistos durante el entrenamiento.
La AI2 publicó 85.336 demostraciones de especialistas, con cerca de 1.600 horas y 144 millones de fotogramas. Esos datos son demostraciones para entrenamiento. No corresponden al número de episodios usados en cada evaluación de desempeño.
Cómo el benchmark mide la generalización
ToyBlocks separa escenas familiares de configuraciones que cambian la composición espacial de los bloques. La evaluación busca identificar si la política sigue funcionando cuando la relación entre los objetos no coincide exactamente con los ejemplos usados en el entrenamiento.
Uno de los gráficos del artículo de la AI2 compara estrategias de entrenamiento. En las dos tareas mostradas, la tasa dentro del dominio era de 83% y 90%, mientras que la generalización inicial quedaba en 5% y 29%. La combinación de estrategias llegó a 81% y 89%, respectivamente.
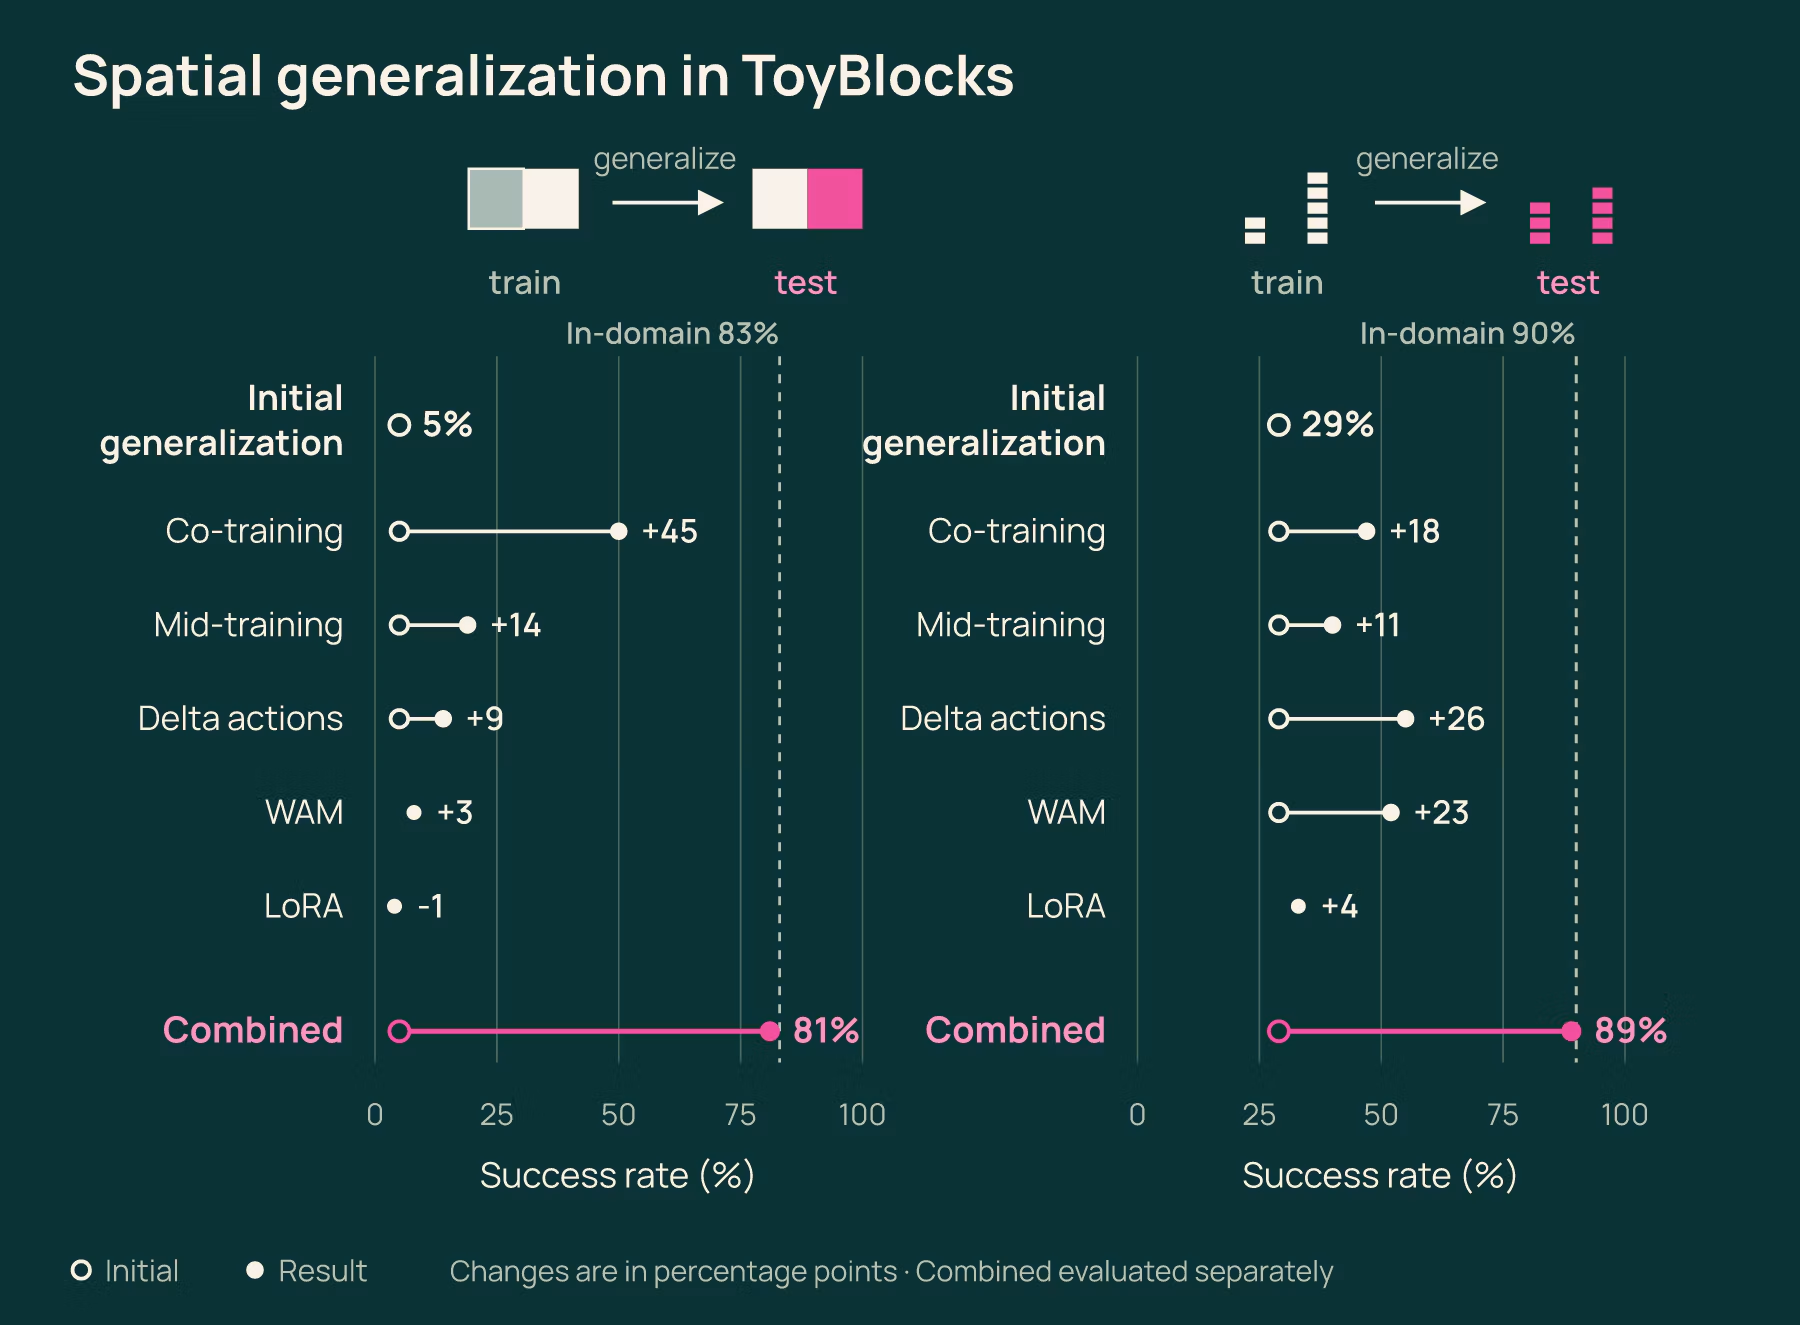
La figura muestra que la tasa final depende del protocolo de entrenamiento, no solo del nombre del algoritmo. La AI2 compara co-training, acciones delta, entrenamiento intermedio y otras configuraciones. La leyenda dice que las ganancias son puntos porcentuales y que la combinación fue evaluada por separado.
Ese tipo de lectura también aparece en evaluaciones de agentes de software. El FeatureLoop separa tareas con requisitos progresivos, mientras que el benchmark de NVIDIA Vera analiza loops de agentes en una configuración de infraestructura específica.
Lo que muestran las pruebas fuera de la simulación
La AI2 también llevó una política jerárquica del entorno virtual a un brazo robótico Franka FR3 con una pinza Robotiq. En los resultados publicados por el equipo, tareas simples con Molmo 2 y ManiFlow tuvieron 55,5% de éxito en simulación, con 111 aciertos en 200 episodios, y 50,0% en el robot real, con 15 de 30 episodios.
Esas dos porcentajes usan unidades de evaluación por episodio. La muestra física de 30 episodios es pequeña, por eso la propia investigación dice que se necesitan más ensayos para establecer confianza estadística.
El estudio también mide habilidades atómicas de ManiFlow, como acciones individuales de manipulación. En esa medida por comando, el resultado fue 80,0% en simulación, con 990 éxitos en 1.237 comandos, y 81,1% en el robot real, con 43 éxitos en 53 comandos, conforme a la figura de evaluación sim-to-real de AI2.
Las tasas por comando y por episodio no son intercambiables. Una habilidad individual puede funcionar con frecuencia, mientras que la secuencia completa de una tarea falla en algún paso; por eso, la investigación muestra las dos métricas por separado.
El artículo también describe pruebas de búsqueda de letras en bloques. La mitad de las escenas preparadas no tenía solución posible, y el agente fue evaluado tanto por resolver la tarea como por identificar correctamente que era inviable. Esa prueba examina razonamiento sobre la escena, además de la ejecución física.
Límites para interpretar los resultados de ToyBlocks
Los números provienen de los experimentos publicados por el propio equipo que creó el entorno. No son una evaluación independiente de todos los robots, políticas o escenarios de manipulación disponibles.
El benchmark inicial también está delimitado. Usa bloques, tareas de mesa, objetos y configuraciones definidas por los autores. El resultado no predice automáticamente el desempeño en casas, fábricas o robots con sensores y mecanismos diferentes.
La muestra física de 30 episodios exige cautela, y los denominadores de las métricas cambian según la evaluación. Para comparar políticas, es importante registrar si la tasa es por comando o por episodio, cuántos intentos se hicieron, qué escenas eran nuevas y qué criterios definieron el éxito.
Una aplicación práctica de ToyBlocks es probar una hipótesis en etapas: entrenar en escenas conocidas, separar configuraciones inéditas para evaluación y luego repetir parte de las tareas en hardware real. La diferencia entre las etapas muestra dónde se pierde el desempeño, sin resumir todo a un único número.
Preguntas frecuentes sobre el benchmark ToyBlocks de AI2
¿Qué es ToyBlocks?
ToyBlocks es un entorno controlado de simulación y evaluación para manipulación robótica. La primera versión usa bloques sobre una mesa y permite probar generalización y transferencia al hardware real.
¿Qué tareas incluye el benchmark ToyBlocks?
La primera versión evalúa Stack, Unstack, Flip y Rotate, tareas de apilar, desapilar, voltear y girar bloques.
¿Cuántas demostraciones se publicaron con ToyBlocks?
AI2 publicó 85.336 demostraciones de expertos, equivalentes a unas 1.600 horas y 144 millones de fotogramas. Estos números describen datos de entrenamiento, no episodios de evaluación.
¿ToyBlocks prueba que una política robótica funciona en el mundo real?
No. En tareas simples, el equipo reportó 55,5% en 200 episodios simulados y 50,0% en 30 episodios reales. La muestra física es pequeña y la investigación pide más ensayos para establecer confianza estadística.
ToyBlocks organiza pruebas de aprendizaje robótico
ToyBlocks ofrece una manera estructurada de estudiar manipulación de bloques, variación de escenas y transferencia sim-to-real. Los resultados iniciales muestran que las políticas logran pasar de la simulación al hardware, pero también dejan claro que se necesitan episodios físicos adicionales.
Para quien desarrolla robótica, la principal ganancia es poder separar entrenamiento, generalización y ejecución real. Compara siempre la unidad de medida y el tamaño de la muestra antes de concluir que una estrategia funciona fuera del escenario probado.
Del experimento a la validación, divide el trabajo entre agentes especialistas y acompaña cada etapa en bridgecode.
Fuente: AI2
Tags:#AI2#ToyBlocks#robótica#aprendizado de robôs#sim-to-real#benchmark
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados

Benchmarks
Construction AI Leaderboard: Claude Opus 5.5 lidera en 5 ejes
ONESTRUCTION publicó el 7 de noviembre de 2026 un ranking de 20 modelos de IA en cinco ejes de trabajo real de construcción. Claude Opus 5.5 lideró con 73,7 puntos.
6 min

Benchmarks
RoleRouteBench: lo que el enrutamiento revela en sistemas multiagente
RoleRouteBench es un entorno reproducible para evaluar el enrutamiento dinámico de roles en tareas de múltiples etapas. Consulta los resultados de JEV 1.13 en los cuatro dominios.
6 min

Benchmarks
CloudOpsBench: agentes de IA en operaciones en la nube
CloudOpsBench mide cómo los agentes de IA ejecutan tareas reales de operación en la nube. El mejor agente resuelve el 60,6% de las 45 tareas en AWS. Mira los números.
7 min