
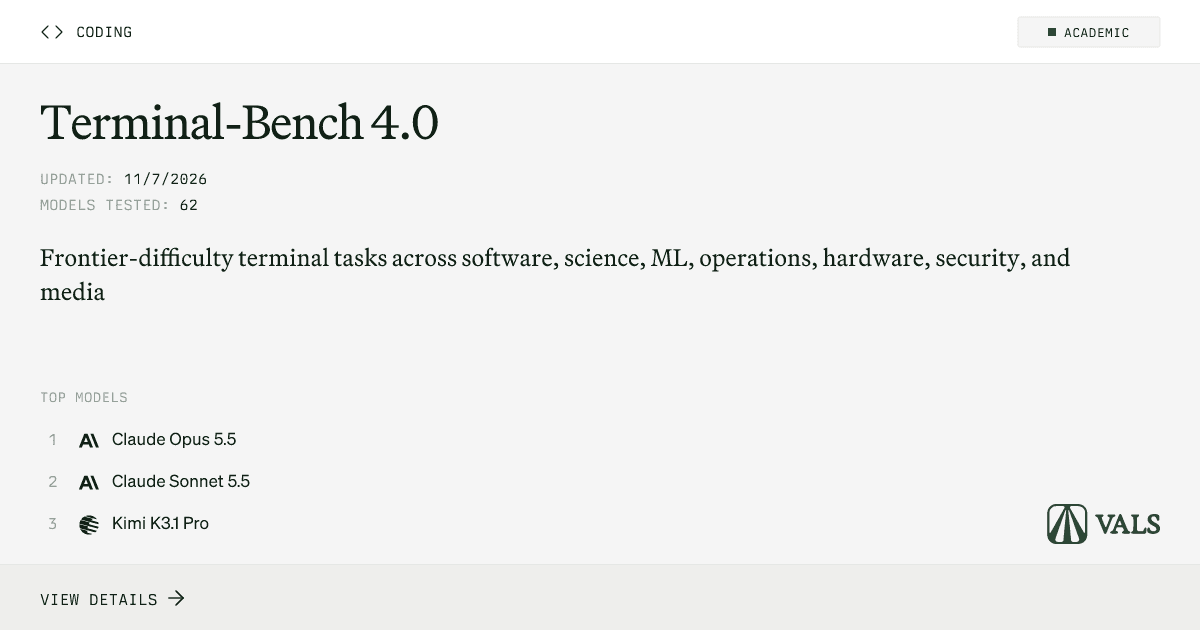
Vals AI publicó los resultados actualizados de Terminal-Bench 4.0, una de las evaluaciones más rigurosas para agentes autónomos que operan directamente en la línea de comandos de sistemas Linux. Los datos revelan que Claude Opus 5.5 y Claude Sonnet 5.5 conquistaron la cima de la tabla, alcanzando respectivamente 65,15% y 64,14% de tasa de resolución de problemas de ingeniería e infraestructura.
InicioBlogBenchmarksTerminal-Bench 4.0: Claude Opus 5.5 y Sonnet 5.5 lideran operaciones en terminal con 65%
Benchmarks5 min
Terminal-Bench 4.0: Claude Opus 5.5 y Sonnet 5.5 lideran operaciones en terminal con 65%
Terminal-Bench 4.0 evalúa agentes de IA resolviendo problemas en terminal Linux real. Claude Opus 5.5 lidera con 65,15%, seguido por Sonnet 5.5 con 64,14%.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
A diferencia de evaluaciones sintéticas que solo validan respuestas de código en cajas aisladas, Terminal-Bench coloca a los modelos frente a ambientes con sistemas de archivos reales, herramientas de línea de comandos (git, bash, compilers, debuggers) y restricciones prácticas de ejecución.
En este artículo vas a ver:
- Lo que Terminal-Bench 4.0 exige de los agentes en ambientes Linux.
- La metodología con el harness Mini-SWE-agent y criterios de aprobación.
- El ranking oficial con Claude, Kimi, Gemini y GPT.
- Métricas de costo por prueba y consumo promedio de tokens.
- Cómo ejecutar y orquestar agentes en terminales en tu flujo local.
Lo que evalúa Terminal-Bench 4.0
El benchmark simula tareas reales enfrentadas por ingenieros de software, administradores de sistemas y especialistas en DevOps en el día a día de servidores y repositorios de código abierto:
- Investigación de fallas: diagnosticar por qué un servicio falló al iniciar usando logs de systemd y utilitarios de red.
- Compilación y build: configurar toolchains, resolver dependencias ausentes y corregir errores de compilación en C, Rust y Python.
- Manipulación de datos y texto: filtrar y transformar grandes volúmenes de registros usando comandos UNIX como grep, sed, awk y jq.
- Automatización de repositorios: operaciones complejas de git, resolución de conflictos de merge y aplicación de patches.
Para comparar con pruebas de seguridad cibernética e ingeniería inversa en el mismo ecosistema, también puedes ver nuestro análisis del SRE Bench de Vals AI.
Cómo funciona la metodología con Mini-SWE-agent
Todos los tests se ejecutan a través del harness Mini-SWE-agent, un ambiente controlado que concede al agente una sesión bash interactiva con permisos limitados dentro de containers Docker efímeros.
En cada turno de conversación, el modelo:
- Emite un comando en el terminal (ej.:
cat /var/log/nginx/error.logopytest -q). - Recibe la salida de stdout y stderr del shell.
- Analiza los resultados y planifica la próxima acción correctiva.
- Concluye con un comando de finalización cuando la tarea se cumple.
La evaluación valida el estado final del sistema operativo ejecutando una suite determinística de tests automatizados y aserciones que el agente no tiene acceso para inspeccionar.
El ranking de líderes de Terminal-Bench 4.0
La tabla de resultados consolidados de Vals AI muestra un panorama competitivo muy ajustado entre las familias de modelos de punta:
| Posición | Modelo | Harness | Tasa de Resolución | Costo Promedio / Prueba | Tokens / Prueba | Duración Promedio |
|---|---|---|---|---|---|---|
| 1 | Claude Opus 5.5 | Mini-SWE-agent | 65,15% | $12,04 | 28,27m | 1h04m |
| 2 | Claude Sonnet 5.5 | Mini-SWE-agent | 64,14% | $10,75 | 58,53m | 1h22m |
| 3 | Kimi K3.1 Pro | Mini-SWE-agent | 63,64% | $4,57 | 16,57m | 49m21s |
| 4 | Gemini 4 Carbon | Mini-SWE-agent | 63,13% | $7,45 | 12,46m | 45m07s |
| 5 | GPT-6 Astra | Mini-SWE-agent | 59,60% | $9,58 | 3,01m | 35m42s |
| 6 | Claude Fable 5.1 | Mini-SWE-agent | 58,08% | $17,18 | 18,82m | 1h00m |
| 7 | Wonder Full | Mini-SWE-agent | 58,08% | $10,53 | 31,82m | 1h12m |
| 8 | Gemini 4 Argon | Mini-SWE-agent | 57,58% | $17,64 | 16,66m | 53m35s |
| 9 | GPT-6.1 Sol | Mini-SWE-agent | 55,05% | $1,72 | 2,86m | 45m12s |
Los datos revelan que Claude Sonnet 5.5 ofrece casi el mismo rendimiento que Opus 5.5 (64,14% contra 65,15%) con menor costo financiero por ejecución. Kimi K3.1 Pro sorprendió al ubicarse en el tercer lugar costando solo $4,57 por prueba, menos de la mitad que Claude Opus. Para un análisis complementario sobre benchmarks que prueban código en repositorios reales, consulta la guía de SWE-bench Pro.
Eficiencia de tokens y tiempo de resolución
Además de la tasa de aciertos bruta, Terminal-Bench 4.0 mide el comportamiento operativo de los modelos:
- GPT-6 Astra es el más veloz y económico en tokens, consumiendo apenas 3,01 millones de tokens y completando el ciclo en 35 minutos.
- Claude Sonnet 5.5 usa un razonamiento iterativo más largo (58,53 millones de tokens), explorando activamente comandos de diagnóstico antes de tomar decisiones definitivas.
- GPT-6.1 Sol registró el menor costo financiero absoluto ($1,72 por prueba), aunque con una tasa de resolución 10% inferior a la de los líderes.
Cómo ejecutar agentes en terminales paralelos en bridgecode
El gran desafío de operar agentes en terminales reales es evitar que una sesión bloquee tu entorno o genere cambios conflictivos en tu rama de trabajo.
Con bridgecode, tienes terminales dedicados para cada CLI (Claude Code, OpenCode, Codex y Antigravity), operando en git worktrees separadas. Esto permite ejecutar un agente que corre comandos pesados en segundo plano mientras sigues programando sin interrupciones. Explora el ecosistema bridgecode para poner squads de agentes a trabajar en tus proyectos.
Preguntas frecuentes sobre el Terminal-Bench 4.0
¿Qué es el Terminal-Bench 4.0 de Vals AI?
Es un benchmark riguroso que evalúa la capacidad de modelos y agentes de IA para operar directamente en terminales Linux reales con el fin de diagnosticar fallas de sistema, compilar código y resolver tareas de DevOps.
¿Qué modelos lideran el Terminal-Bench 4.0?
Claude Opus 5.5 lidera con 65,15% de tasa de resolución, seguido de cerca por Claude Sonnet 5.5 con 64,14% y Kimi K3.1 Pro con 63,64%.
¿Qué modelo presentó la mejor relación costo beneficio?
Kimi K3.1 Pro quedó en la tercera posición general con una tasa de 63,64% y un costo promedio de $4,57 por prueba, menos de la mitad del costo de Claude Opus ($12,04).
¿Cómo se evalúan los agentes en Terminal-Bench?
A través del harness Mini-SWE-agent, donde el agente emite comandos bash en un contenedor efímero y el resultado final se valida con suites de pruebas determinísticas ocultas al modelo.
Conclusión: la evolución del uso de línea de comando por IA
Terminal-Bench 4.0 demuestra que los modelos de IA superaron la barrera de la teoría y ahora dominan entornos de línea de comando Linux con estabilidad por encima del 65%. A medida que modelos como Sonnet 5.5 y Kimi K3.1 Pro equilibran alta asertividad con costos accesibles, la operación automatizada de servidores y repositorios entra en una nueva fase práctica.
Fuente: Vals AI (Terminal-Bench 4.0)
Tags:#benchmark#claude#terminal#agentes-ia#linux
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Benchmarks
SRE Bench: ¿la IA hace ingeniería inversa de binarios?
SRE Bench prueba si los agentes de IA logran hacer ingeniería inversa de binarios sin código fuente. GPT-6 Astra lidera con 56,87%.
5 min
Benchmarks
CyberBench: ¿la IA encuentra bugs de seguridad?
CyberBench prueba si los agentes de IA logran encontrar fallas de seguridad en código y producir parches. Wonder, de Meta, lidera con 80,36%.
5 min
Benchmarks
Vibe Code Bench: ¿la IA construye una app web desde cero?
Vibe Code Bench prueba si los modelos de IA logran construir aplicaciones web completas a partir de una descripción. Claude Sonnet 5.5 en OpenHands lidera con 92,39%.
5 min