
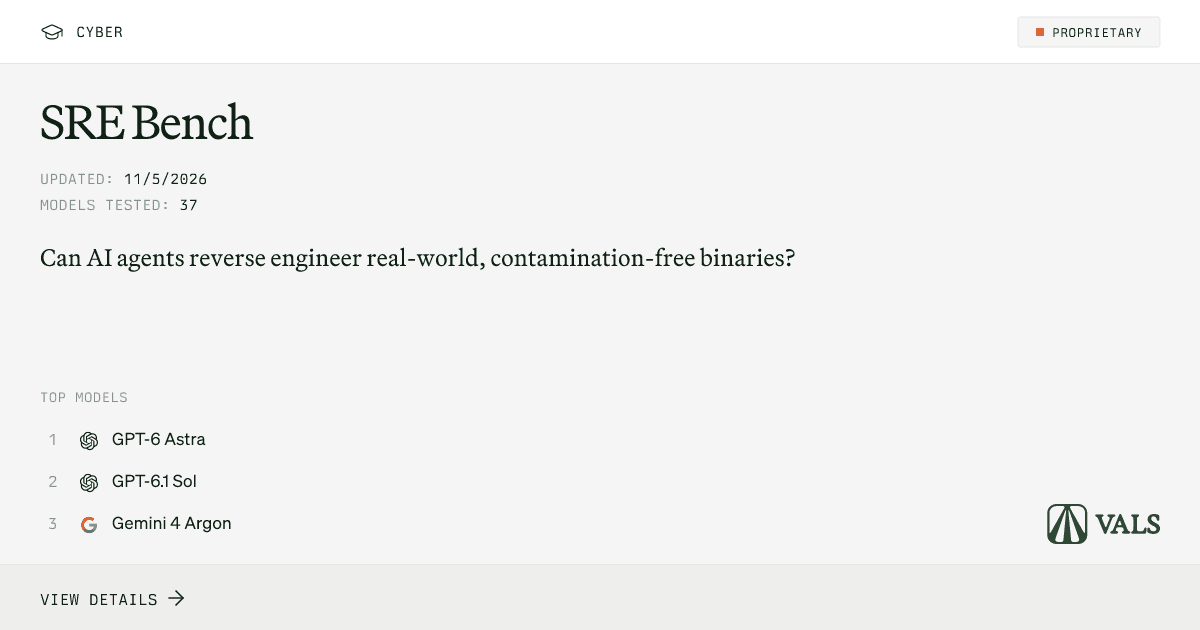
Vals AI publicó el 5 de noviembre de 2026 una nueva ronda del SRE Bench, un benchmark que pregunta si los agentes de IA logran hacer ingeniería inversa de binarios sin acceso al código fuente. La respuesta corta es: GPT-6 Astra lidera con 56,87%, y la mayoría de los agentes queda muy por debajo.
Benchmarks5 min
SRE Bench: ¿la IA hace ingeniería inversa de binarios?
SRE Bench prueba si los agentes de IA logran hacer ingeniería inversa de binarios sin código fuente. GPT-6 Astra lidera con 56,87%.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
El SRE Bench no prueba si el modelo conoce patrones de código. Entrega un binario compilado y pide que el agente descubra qué hace el programa, sin acceso al código fuente, a decompiladores o a herramientas de análisis binario. Es una prueba de comprensión de software, no de memorización.
En este artículo vas a ver:
- Qué le pide el SRE Bench al agente que haga.
- Cómo funciona la evaluación (pasos, límites, criterio de aprobación).
- El ranking oficial del 5 de noviembre de 2026 y qué muestran los números.
- Por qué este benchmark importa para quien usa agentes de código.
Qué es el SRE Bench
SRE Bench es un benchmark que evalúa si un agente de IA logra determinar qué hace un programa binario, sin acceso al código fuente. Cada tarea entrega un binario compilado y pide una descripción del comportamiento del programa. El agente necesita analizar el binario, entender la lógica y responder preguntas sobre qué hace el programa.
La idea es medir capacidad de comprensión de software, no de ejecución. El agente no tiene acceso a internet, al código fuente o a herramientas de análisis binario. Puede ejecutar el binario e inspeccionar la salida, pero no puede usar decompiladores, desensambladores o rastreo. Esto está más cerca del trabajo real de un analista de seguridad que de ejecutar un escáner automatizado.
Esto diferencia al SRE Bench de Vals CyberOffense, que mide si los modelos abiertos logran invadir redes corporativas. Aquí el agente necesita entender qué hace un binario, no explorar vulnerabilidades.
Cómo funciona la evaluación
Vals AI evalúa a los agentes en 19 tareas públicas del SRE Bench. Cada tarea provee un binario compilado de un programa real, con más de 16.000 líneas de código en promedio, que abarca protocolos de red, firmware, juegos, recuperación de formatos de archivo y malware. El agente recibe un terminal bash, un sandbox offline y el prompt estándar del benchmark. Puede ejecutar el binario e inspeccionar la salida, pero no puede usar internet, decompiladores, desensambladores o rastreo.
La submisión contiene la descripción del comportamiento del programa producida por el agente. Vals compara la descripción con el comportamiento real del programa en pruebas ocultas. El agente tiene hasta 1.000 pasos, límite de 6 horas de reloj y 180 segundos de timeout por acción. La salida de las herramientas se trunca en 10.000 caracteres en los extremos.
Un agente pasa si la descripción corresponde al comportamiento real del programa. No hay crédito parcial por explicación: o la comprensión está correcta, o no.
El ranking oficial del 5 de noviembre de 2026
Vals probó varios agentes en el SRE Bench. GPT-6 Astra lidera con 56,87% de aciertos, seguido por Gemini 4 Argon con 52,10% y Claude Opus 5.5 con 48,30%. La mayoría de los agentes queda por debajo del 45%.
| Posición | Modelo | Acierto |
|---|---|---|
| 1 | GPT-6 Astra | 56,87% |
| 2 | Gemini 4 Argon | 52,10% |
| 3 | Claude Opus 5.5 | 48,30% |
La diferencia entre el primero y el segundo es de casi 5 puntos porcentuales. Esto muestra que hacer ingeniería inversa de binarios sigue siendo una tarea difícil, incluso para los modelos más fuertes.
Vals también compara agentes en costo y latencia por tarea. GPT-6 Astra es el más preciso, pero también uno de los más caros por intento.
Cómo probar hoy
Para quien quiere experimentar, Vals pone a disposición la metodología y los resultados en la leaderboard oficial. Puedes ejecutar los mismos agentes en tu propio binario y comparar el resultado con el ranking publicado.
Vals también publica el código de evaluación y los prompts usados, lo que permite reproducir las pruebas en otros modelos y entornos. Esto es útil para equipos que quieren validar si un agente nuevo cumple con sus necesidades de análisis de binarios antes de adoptarlo en producción.
Por qué importa este benchmark
El SRE Bench mide una capacidad que los benchmarks de código no capturan: la habilidad de entender qué hace un programa sin acceso al código fuente. Esto es útil en tres escenarios reales.
Primero, análisis de malware: cuando recibes un binario sospechoso y necesitas entender qué hace. Segundo, auditoría de sistemas legados: cuando heredaste un sistema sin documentación ni código fuente. Tercero, validación de agentes de código que necesitan actuar en entornos donde no hay código fuente disponible.
El resultado de 56,87% también es un recordatorio de límite. Incluso el mejor agente se equivoca en más del 43% de los casos. Para quienes usan agentes de código en el día a día, esto refuerza la necesidad de revisión humana y pruebas, como se discutió en el análisis del CWE-bench v2 en ciberseguridad.
Preguntas frecuentes sobre el SRE Bench
¿Qué es el SRE Bench?
Es un benchmark que evalúa si los agentes de IA logran determinar qué hace un programa binario, sin acceso al código fuente.
¿Qué agente lidera el SRE Bench?
El 5 de noviembre de 2026, GPT-6 Astra lideraba con 56,87%, seguido por Gemini 4 Argon con 52,10% y Claude Opus 5.5 con 48,30%.
¿El SRE Bench parte de un repositorio existente?
No. El agente recibe un binario compilado y debe describir el comportamiento del programa, sin acceso al código fuente ni a descompiladores.
¿Cuáles son los límites de tiempo y pasos?
Cada agente tiene hasta 1.000 pasos, 6 horas de reloj y 180 segundos por acción. La descripción debe corresponder al comportamiento real del programa.
¿Cuántas tareas tiene el SRE Bench?
Vals AI evalúa 19 tareas públicas. Cada tarea pide la descripción del comportamiento de un programa binario.
Conclusión: la ingeniería inversa todavía exige especialista
El SRE Bench es uno de los benchmarks que prueban si el agente entiende software de verdad. Los números del 5 de noviembre de 2026 muestran que hacer ingeniería inversa de binarios es difícil incluso para los modelos más fuertes. Acompaña la leaderboard oficial para ver cómo cambian los números con nuevos modelos.
Un squad de agentes puede dividir análisis, documentación y revisión, y es eso que coordinas en bridgecode.
Fuente: Vals AI
Tags:#benchmark#sre-bench#vals-ai#seguranca#agentes
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Benchmarks
CyberBench: ¿la IA encuentra bugs de seguridad?
CyberBench prueba si los agentes de IA logran encontrar fallas de seguridad en código y producir parches. Wonder, de Meta, lidera con 80,36%.
5 min
Benchmarks
Vibe Code Bench: ¿la IA construye una app web desde cero?
Vibe Code Bench prueba si los modelos de IA logran construir aplicaciones web completas a partir de una descripción. Claude Sonnet 5.5 en OpenHands lidera con 92,39%.
5 min
Benchmarks
ProgramBench: ¿la IA reconstruye programas desde cero?
ProgramBench prueba si los modelos de IA pueden reconstruir programas de línea de comandos a partir de un binario y una especificación. Claude Opus 5.5 lidera con 18,50%.
5 min