
El 6 de noviembre de 2026, a las 15:59 UTC, el leaderboard tau2-Bench Airline de OpenRouter mostraba a GPT-5.1 de OpenAI en primer lugar, con 80,0% de éxito. Es un resultado de uso de herramientas en una simulación de atención aérea, no un sello de que el modelo sea mejor para cualquier tarea.

Benchmarks6 min
GPT-5.1 lidera tau2-Bench Airline con 80%
En el ranking de tau2-Bench Airline del 6 de noviembre, GPT-5.1 marcó 80,0%. Entiende el método, el tamaño mínimo de muestra y los límites antes de elegir un agente.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
En este artículo vas a ver:
- Qué simula tau2-Bench Airline y qué acciones debe completar el agente.
- Cómo arma OpenRouter la nota y cuál es el tamaño mínimo de muestra.
- Qué permite comparar el resultado del 80,0% y qué no demuestra.
- Cómo interpretar el leaderboard antes de elegir un modelo para producción.
Qué mide el tau2-Bench Airline
El tau2-Bench Airline evalúa a un agente que conversa con un cliente simulado y usa herramientas de una aerolínea. El objetivo es completar pedidos dentro de reglas de negocio, en lugar de solo responder con texto convincente.
Las tareas pueden requerir consultar una reserva, cambio o cancelación de vuelo y otras acciones apoyadas por las herramientas disponibles. El agente necesita entender la solicitud, elegir la operación adecuada y respetar la política definida para el escenario.
Este formato importa porque una conversación puede parecer correcta y aun así terminar sin la acción solicitada. En una evaluación de agente, el estado final de la reserva y el cumplimiento de la política pesan más que una respuesta bien escrita.
El benchmark también limita el entorno. Los modelos reciben el mismo contexto de la tarea, las mismas reglas, el mismo cliente simulado y el mismo conjunto de herramientas. Esto ayuda a comparar ejecuciones sin convertir la prueba en una evaluación de conocimiento general.
El artículo del benchmark τ²-Bench explica la evaluación de agentes en escenarios de control compartido. La página del leaderboard Airline de OpenRouter describe la configuración usada para los resultados mostrados en el servicio.
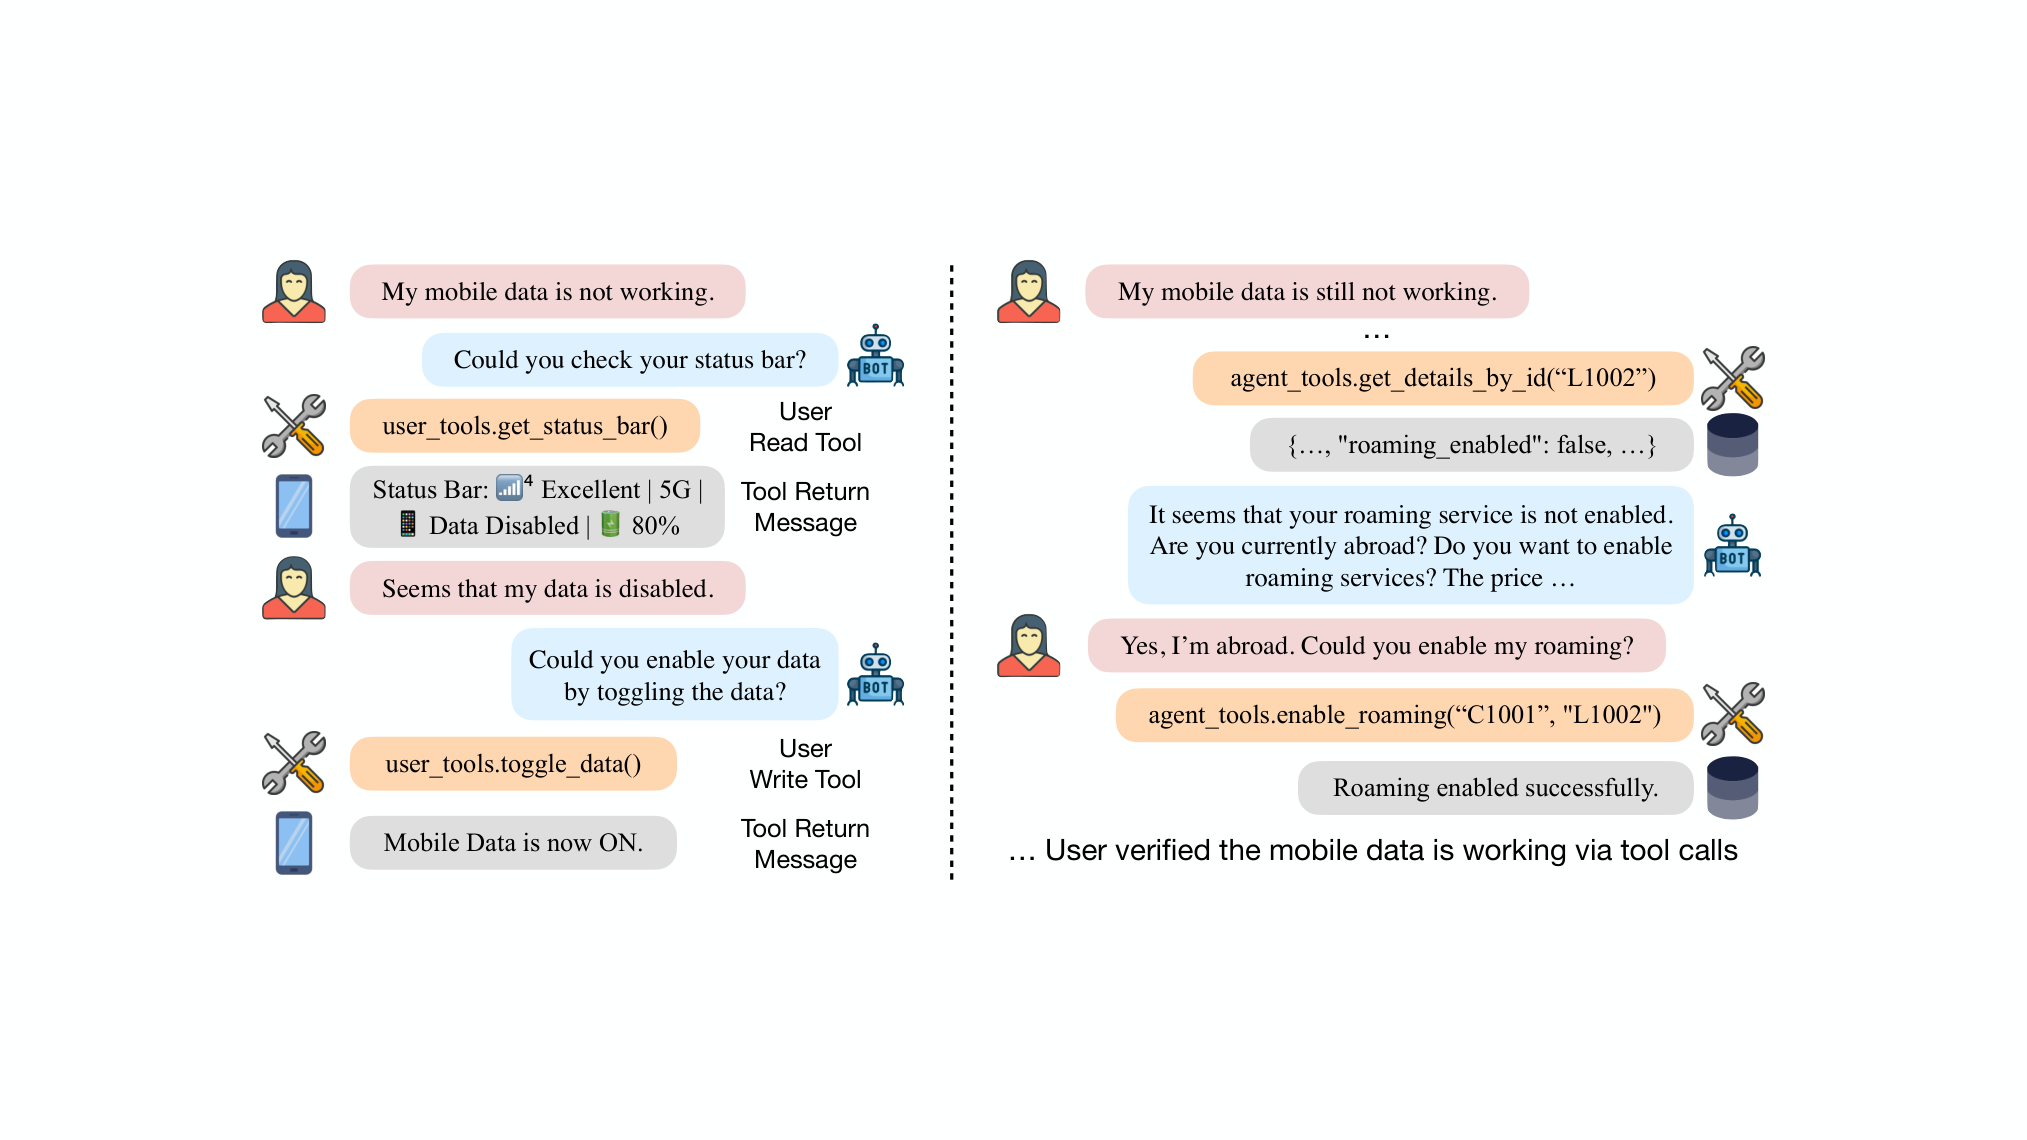
Este ejemplo de Telecom ilustra el formato de interacción, no el marcador Airline de 2026. Ver la investigación original para el contexto.
Cómo OpenRouter calcula el 80,0%
La página consultada registraba el resultado a las 15:59 UTC del 6 de noviembre. En ese recorte, OpenAI GPT-5.1 aparecía en la cima con una tasa de éxito del 80,0% en el dominio Airline.
La nota no proviene de una única conversación elegida para ilustrar el modelo. OpenRouter agrega ejecuciones exitosas de los 90 días anteriores y pondera el cálculo por el número de tareas. La ventana móvil hace que el marcador acompañe la actividad reciente, pero también significa que puede cambiar cuando entran nuevas ejecuciones o las antiguas salen del período.
Hay además una condición mínima: cada par de modelo y proveedor necesita al menos 45 tareas evaluadas para aparecer en el ranking. OpenRouter muestra la desviación estándar junto a las notas, pero ese número no sustituye la lectura del método ni revela, por sí solo, la distribución completa de los casos.
| Item | Lo que informa la página |
|---|---|
| Modelo en la cima | OpenAI GPT-5.1 |
| Éxito mostrado | 80,0% |
| Recorte consultado | 6 de noviembre de 2026, 15:59 UTC |
| Ventana de agregación | 90 días anteriores |
| Muestra mínima | 45 tareas evaluadas por par modelo y proveedor |
La comparación es entre integraciones modelo-proveedor, no solo entre nombres de modelos. El enrutamiento, la disponibilidad y la configuración del proveedor forman parte del sistema observado, por lo que dos servicios que ofrecen el mismo modelo pueden no producir números idénticos.
Lo que el primer lugar no prueba
La tasa del 80,0% no significa que GPT-5.1 acierte ocho de cada diez solicitudes reales de cualquier aerolínea. Describe el conjunto de tareas y las reglas específicas de tau2-Bench Airline.
La muestra mínima de 45 tareas también merece atención. Es suficiente para que OpenRouter incluya una integración en el marcador, pero no equivale a miles de interacciones con clientes ni garantiza que diferencias pequeñas entre modelos sean estables.
El promedio ponderado oculta la variación entre tipos de pedido. Un agente puede ser fuerte consultando itinerarios y tener más dificultad en cambios con varias restricciones. Por eso, la tasa agregada no sustituye la lectura de resultados por escenario, cuando están disponibles.
El benchmark tampoco mide todos los factores de una operación: calidad de los datos, excepciones, seguridad de la cuenta, latencia percibida y volumen de intervenciones humanas. Estos aspectos exigen evaluaciones propias.
Ese cuidado vale para otras pruebas: FeatureLoop evalúa requisitos de código en evolución, mientras que GDPx compara dominios distintos.
Cómo usar el leaderboard en la elección de un agente
Usa tau2-Bench Airline como filtro inicial si tu producto depende de agentes que consultan datos y ejecutan operaciones con reglas. Es más informativo que una prueba de conversación libre para este tipo de flujo, porque incluye acciones y estado final.
Antes de comparar dos proveedores, revisa la fecha de actualización, la ventana de 90 días, el mínimo de tareas y la desviación estándar mostrada. Registra también el modelo exacto y el proveedor, para no atribuir al modelo solo un resultado que puede depender de la integración.
Después, reproduce la idea de la prueba en tu dominio. Monta casos con pedidos frecuentes, excepciones, políticas incompatibles y operaciones que exigen confirmación. Define antes qué cuenta como éxito, cómo evitar cambios indebidos y cómo evaluar una conversación interrumpida.
Separa métricas de tarea y de experiencia. La conclusión de la acción puede medirse en una y la claridad de la conversación, el tiempo de respuesta y la necesidad de intervención humana en otras. Esto evita que un promedio único oculte una falla que sería crítica para el usuario.
Si hay datos internos, haz una evaluación controlada con los mismos casos para cada opción. Preserva los logs necesarios, elimina información personal y compara también los errores por tipo de tarea. El leaderboard ayuda a formular una hipótesis; la validación en el flujo real decide si se sostiene.
Preguntas frecuentes sobre el resultado de GPT-5.1 en tau2-Bench Airline
¿Qué mide tau2-Bench Airline?
Evalúa agentes que conversan con un cliente simulado y ejecutan operaciones de una aerolínea dentro de reglas definidas. La puntuación considera la conclusión de las tareas del escenario, no solo la calidad del texto.
¿Cuál fue el resultado de GPT-5.1 en tau2-Bench Airline?
En el registro del 6 de noviembre de 2026, a las 15:59 UTC, OpenAI GPT-5.1 aparecía en primer lugar con un 80,0% de éxito.
¿Cuál es el tamaño mínimo de muestra en el ranking de OpenRouter?
OpenRouter exige al menos 45 tareas evaluadas por par de modelo y proveedor para mostrar la integración. La nota agrega ejecuciones exitosas de los 90 días anteriores, ponderadas por el número de tareas.
¿El resultado del 80,0% prueba que GPT-5.1 es mejor para cualquier agente?
No. El número describe tau2-Bench Airline y la integración modelo-proveedor observada. No garantiza un desempeño igual en otros sectores, políticas o flujos de producción.
Lo que cambia para quien desarrolla agentes de atención
Que GPT-5.1 lidere este recorte es una señal útil sobre ejecución de herramientas en tareas aéreas, siempre que la fecha y la muestra acompañen la lectura. La nota no debe convertirse en promesa de desempeño en soporte, ventas o automatización fuera de este escenario.
Para un equipo técnico, el valor del ranking está en mostrar una capacidad que puede probarse: seguir políticas y concluir acciones en una simulación compartida. El siguiente paso es repetir la evaluación con los propios flujos y observar dónde el agente necesita validación humana.
El resultado merece atención, pero solo tiene sentido junto con el modelo, proveedor, ventana, muestra y definición de éxito.
Probar agentes en herramientas separadas fragmenta el flujo. Coordine sus agentes en un solo flujo en bridgecode.
Fuente: OpenRouter
Tags:#OpenRouter#GPT-5.1#tau2-Bench Airline#benchmark#agentes de IA
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados

Benchmarks
CloudOpsBench: agentes de IA en operaciones en la nube
CloudOpsBench mide cómo los agentes de IA ejecutan tareas reales de operación en la nube. El mejor agente resuelve el 60,6% de las 45 tareas en AWS. Mira los números.
7 min

Benchmarks
Construction AI Leaderboard: Claude Opus 5.5 lidera en 5 ejes
ONESTRUCTION publicó el 7 de noviembre de 2026 un ranking de 20 modelos de IA en cinco ejes de trabajo real de construcción. Claude Opus 5.5 lideró con 73,7 puntos.
6 min

Benchmarks
RoleRouteBench: lo que el enrutamiento revela en sistemas multiagente
RoleRouteBench es un entorno reproducible para evaluar el enrutamiento dinámico de roles en tareas de múltiples etapas. Consulta los resultados de JEV 1.13 en los cuatro dominios.
6 min