
A Alibaba apresentou o Qwen4-Max, novo modelo principal da família Qwen, em um anúncio no blog oficial da Qwen datado de 16 de novembro de 2026. A Reuters já havia reportado o lançamento no domingo, 15. O modelo traz 2,4 trilhões de parâmetros, visão nativa e contexto de 1 milhão de tokens.
Newsletter5 min
Qwen4-Max chega com 2,4T de parâmetros e 1M de contexto
A Alibaba lançou o Qwen4-Max, modelo fechado com 2,4T de parâmetros, 1M de tokens de contexto e visão nativa, disponível na QwenCloud.
A maior newsletter de IA do Mundo
Receba artigos sobre IA no seu e-mail
Curadoria técnica sobre modelos, agentes e ferramentas de código. Sem spam, cancele quando quiser.
Isso importa para quem programa com agentes porque o Qwen4-Max mira tarefas longas, uso de ferramentas e entrega de resultados revisáveis. Ao mesmo tempo, ele é um modelo fechado, sem pesos para baixar.
O que é o Qwen4-Max, o novo modelo principal da Alibaba
O Qwen4-Max é o primeiro modelo da família Qwen4. A Alibaba o descreve como um "colega de equipe de IA" para trabalho, criação e descoberta científica, capaz de rodar tarefas de longa duração.
Segundo o blog oficial da Qwen, ele tem 2,4T de parâmetros no backbone, 71B ativados por token e mais 328B de parâmetros de N-gram Embedding. Parâmetros ativos são a parte da rede usada em cada token, o que define o custo de rodar o modelo.
O anúncio cita aplicações como modelagem 3D no Blender, desenvolvimento de jogos em Unity, Unreal e Godot, planejamento de linha de produção e trabalho em finanças, direito e saúde. São demonstrações da própria empresa, sem replicação independente até aqui.
O que o lançamento não é: não é um modelo aberto e não traz os pesos dos modelos menores. A Alibaba apenas diz que versões menores da família Qwen4 virão como código aberto, sem data.
Arquitetura do Qwen4-Max: atenção esparsa, resíduos com portas e N-gram
O Qwen4 usa um Mixture of Experts (MoE) esparso, que divide o modelo em especialistas e ativa só alguns por token. A novidade está em três blocos, todos descritos no anúncio.
- GDN + Qwen Sparse Attention (QSA): três camadas Gated DeltaNet comprimem o histórico em estados de tamanho fixo para cada camada QSA, que escolhe o contexto relevante em blocos pequenos.
- Gated Residual: quatro ramos residuais paralelos com portas de leitura e escrita, para melhorar o fluxo de informação e a estabilidade do treino.
- N-gram Embedding: consultas baseadas em contexto que capturam padrões locais de tokens sem muito custo extra.
A Qwen afirma que o treino em escala de 2,4T ocorreu sem picos de perda. Nas avaliações internas, o Qwen4-Max-Base teve de 5% a 13% menos bits por byte (BPB) que o Qwen3.8-Max-Base, com 25% menos parâmetros ativos. BPB mede o quanto o modelo erra ao prever o texto; menor é melhor.
Eficiência e segurança de código: o que a Alibaba mediu
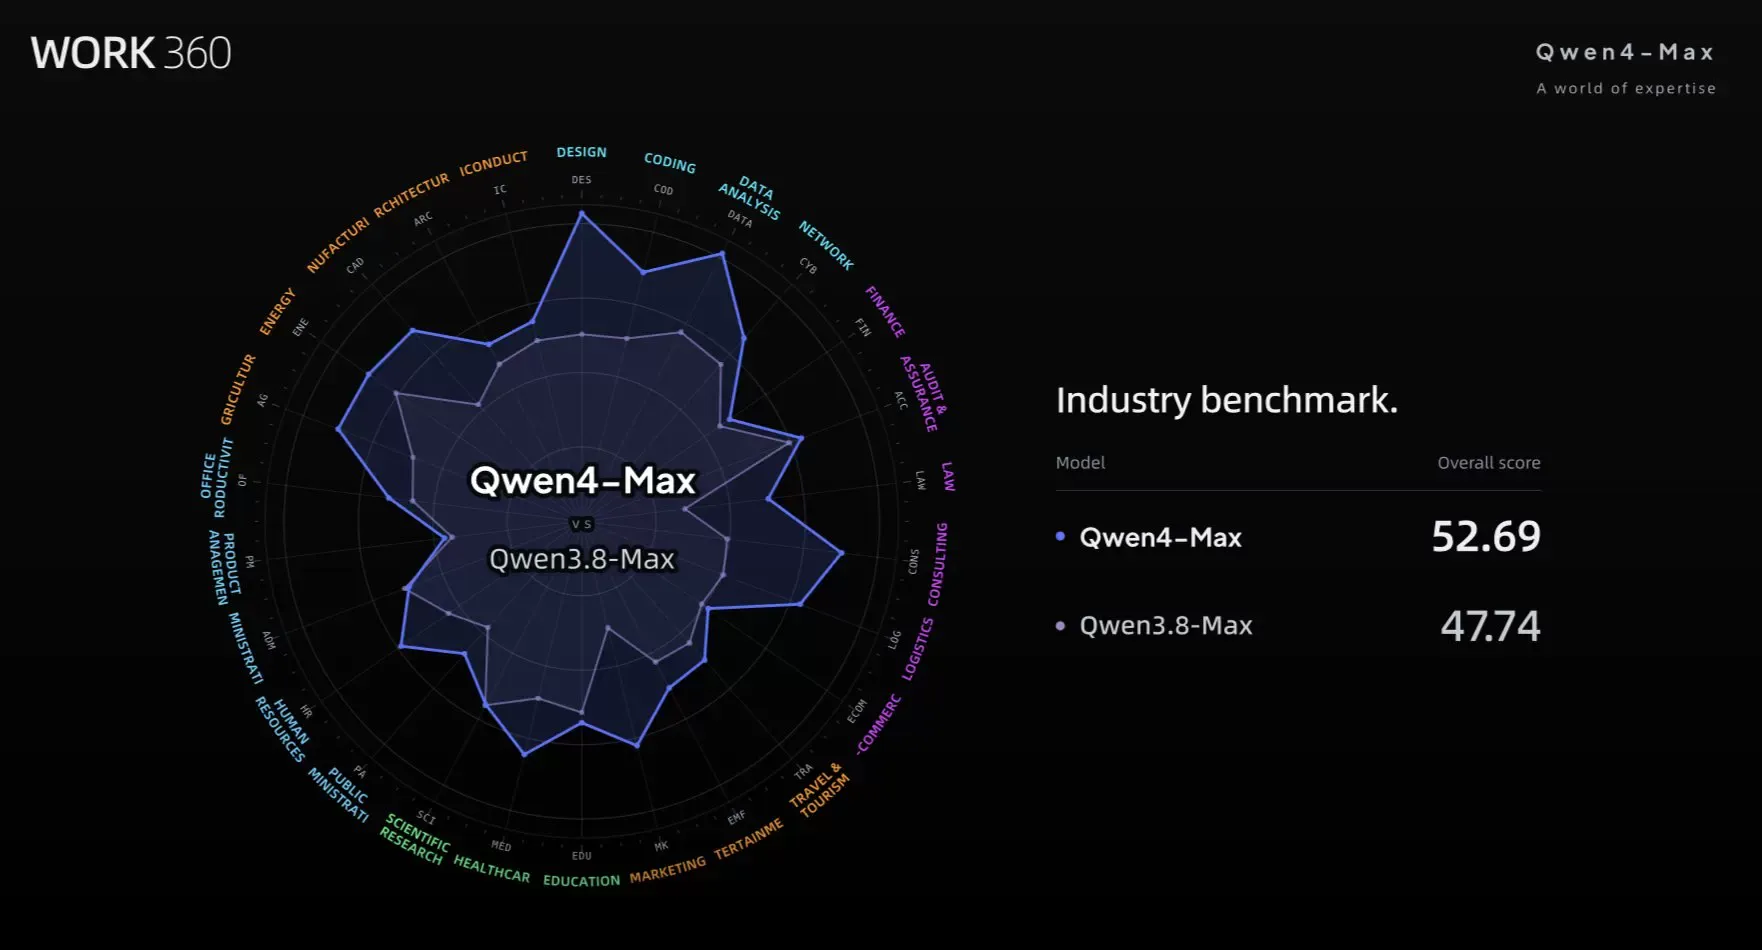
O dado mais útil para quem paga por token é o de eficiência. Na avaliação Work360, o uso de tokens cai cerca de 24% no esforço xhigh e 35% no esforço high, na comparação com o Qwen3.8-Max. No Terminal-Bench 4.0, a queda é de cerca de 48% e 49%.
Na mesma avaliação Work360, o custo médio por tarefa passa de US$ 4,43 para US$ 1,67, uma redução de 62%, segundo a Alibaba. O Work360 é um benchmark criado pela própria empresa, com 26 domínios de primeiro nível e 721 campos especializados.
Há também um dado de segurança. No Last Secure Code Bench, a taxa de acerto simultâneo em função e segurança sobe de 22,0% para 31,8%. O código gerado de forma segura nos três níveis, função, arquivo e repositório, passa de 8% para 14,7%.
A Alibaba diz que revisões internas não encontraram capacidades de risco cibernético em larga escala nem ganho relevante em riscos químicos, biológicos, radiológicos e nucleares. Essa é uma avaliação interna, não auditoria externa.
Benchmarks do Qwen4-Max: à frente no DeepSWE, atrás no Terminal-Bench
O quadro é misto. De acordo com a cobertura do The Next Web, o Qwen4-Max marcou 75,7 no DeepSWE v1.1, à frente do Claude Opus 5.5, com 74,2. No Terminal-Bench 4.0, porém, fez 48,5, atrás do Opus 5.5 (59,6) e do Kimi K3.1 (67,2).
Para agentes de código que passam o dia em shell, build e deploy, o Terminal-Bench pesa mais que um placar isolado. Vale rodar os dois testes no seu próprio repositório antes de trocar de modelo.
Lembre que os gráficos são da Alibaba, e as notas dos concorrentes também foram reunidas por ela. Parte dos resultados vem de placares públicos como Arena e Artificial Analysis, citados nas notas de rodapé do anúncio.
Como testar o Qwen4-Max hoje
O modelo está disponível na QwenCloud, com o ID qwen4-max, por API ou pelo Token Plan. A documentação está no guia de desenvolvedores da QwenCloud.
O anúncio também cita QwenWork, Qoder e QwenStudio como lugares para usar o modelo. Não há pesos para rodar localmente.
Se você já acompanha a linha Qwen, vale ler como a comunidade usa a geração anterior, como no ajuste fino Arete-27B, da Nous Research, sobre o Qwen3.8-27B, e o relato da Cohere sobre o Qwen3.8 em teste de segurança.
Para comparar com a concorrência no mesmo tema de modelos que dividem trabalho em agentes, veja também o Orchestrator do Google Antigravity com Gemini 4 Carbon e Hydrogen.
Perguntas frequentes sobre o Qwen4-Max da Alibaba
O que é o Qwen4-Max?
É o primeiro modelo da família Qwen4, lançado pela Alibaba. Tem 2,4 trilhões de parâmetros, visão nativa e janela de 1 milhão de tokens, segundo o blog oficial da Qwen.
O Qwen4-Max tem pesos abertos?
Não. O Max é fechado. A Alibaba diz que modelos menores da família Qwen4 serão abertos em breve, sem data confirmada no anúncio.
Onde usar o Qwen4-Max hoje?
Pela QwenCloud (ID qwen4-max), por API ou Token Plan, e também no QwenWork, no Qoder e no QwenStudio, conforme o anúncio.
O Qwen4-Max é melhor que o Claude Opus 5.5?
Depende do teste. Nos números divulgados pela própria Alibaba, ele fica à frente no DeepSWE v1.1 (75,7 contra 74,2), mas atrás no Terminal-Bench 4.0 (48,5 contra 59,6).
Os benchmarks são independentes?
Não. Os gráficos são da Alibaba, incluindo as pontuações dos concorrentes. Alguns resultados citam placares públicos como Arena e Artificial Analysis.
O que muda para quem usa agentes de IA com o Qwen4-Max
Para quem monta fluxos com vários modelos, o Qwen4-Max entra como mais uma opção de peso pesado, com contexto longo e pretensão de custo menor por tarefa. A promessa de eficiência é forte, mas vem de teste interno.
O caminho sensato é medir no seu caso: mesma tarefa, mesmo repositório, comparando tokens gastos, testes aprovados e tempo. Só então vale mudar o modelo de algum agente do seu fluxo.
O Qwen4-Max chamou sua atenção? Coloque essa novidade pra trabalhar num squad de agentes de IA no bridgecode, cada um no seu papel.
Fonte: Qwen
Tags:#Qwen#Alibaba#modelos de IA#agentes de código

Desenvolvedor e criador do bridgecode, ambiente de desenvolvimento agêntico para orquestrar squads de agentes de IA. Ajuda quem vai do vibe coding ao desenvolvimento profissional a sair da ideia e chegar ao produto entregue.
Artigos relacionados
Newsletter
AWS Emulator leva a nuvem da AWS para o seu laptop
A AWS lançou o AWS Emulator, que roda as APIs da AWS no seu laptop para testar apps e agentes de código sem conta na nuvem e sem taxa extra.
5 min
Newsletter
Antigravity lança Orchestrator: Carbon e Hydrogen juntos
Google Antigravity ganha Orchestrator: um modo que alterna Gemini 4 Carbon e Hydrogen na mesma sessão para reduzir quota e tempo de execução.
5 min
Newsletter
Edge0-145B: modelo aberto de 145B para rodar no seu PC
A Edge0 abriu os pesos do Edge0-145B e do Edge0-120B. O modelo tem 145 bilhões de parâmetros, ativa só 10 bilhões por passo e mira laptops e GPUs.
5 min