
CONFIRMADO · OFICIAL
LongCat-2.5 chega com foco em agentes e código
Anunciado em 2 de novembro, o LongCat-2.5 combina entrada multimodal, programação agentiva e acesso por API. Veja os números divulgados e como testar.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
A documentação oficial do LongCat registrou a chegada do LongCat-2.5 em 2 de novembro de 2026, com foco em visão, programação e tarefas extensas de agentes. A página de notícias da Meituan, que credita o texto à Economic Observer, acrescenta os números técnicos divulgados sobre o modelo. (notas do LongCat, Meituan)
O que a Meituan anunciou sobre o LongCat-2.5
A página oficial da Meituan apresenta o LongCat-2.5 como seu novo modelo de grande escala, com foco em multimodalidade e tarefas de agente. Multimodalidade significa que o sistema pode trabalhar com mais de um tipo de entrada, como texto e imagem, em vez de receber somente texto.
Na página da Meituan, o LongCat-2.5 é descrito com 1,6 trilhão de parâmetros e treinamento em hardware de computação nacional. O texto não informa quantos parâmetros são ativados por token, então não dá para inferir o custo de inferência apenas pelo total. Esses dados aparecem em uma publicação que a página credita à Economic Observer, não em uma avaliação independente.
A página da Meituan afirma que o treinamento usou sequências de até 1 milhão de tokens, e a documentação de parâmetros da API lista uma janela de contexto de 1.048.576 tokens. São referências diferentes: comprimento de contexto da API não é o mesmo que tamanho de saída permitido em uma chamada.
O modelo já aparece na plataforma LongCat e na documentação para desenvolvedores, com acesso por API. O changelog também lista compatibilidade com Claude Code, Codex e Hermes, entre outros harnesses de agentes. Um harness é a camada que conecta o modelo às ferramentas e ao ambiente de execução; a disponibilidade de cada integração deve ser confirmada na documentação atual.
Como o LongCat-2.5 combina visão e código
O LongCat-2.5 é apresentado como um modelo nativamente multimodal. No contexto de programação, isso permite investigar tarefas em que o agente precisa interpretar uma captura de tela, ler uma interface, comparar o estado visual com o código e então executar uma sequência de ações.
Esse tipo de fluxo não elimina a necessidade de ferramentas. O modelo ainda precisa de um ambiente controlado para abrir arquivos, executar testes e inspecionar resultados. A diferença é que a visão pode acrescentar evidências visuais ao contexto, por exemplo quando uma alteração no CSS precisa ser comparada com uma tela de referência.
A Meituan destaca tarefas agentivas longas, como planejamento de código, navegação por páginas e interação com ambientes visuais. Uma tarefa longa exige que o agente mantenha objetivos e resultados intermediários coerentes ao longo de várias etapas. O anúncio não diz que o modelo conclui qualquer projeto sem supervisão.
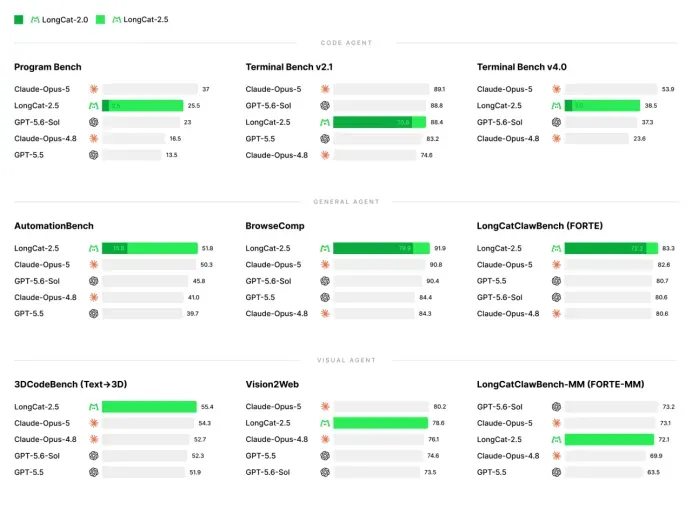
A figura da Meituan reúne avaliações diferentes, entre elas Program Bench, Terminal Bench, AutomationBench, BrowseComp e Vision2Web. Como cada benchmark mede tarefas distintas, uma posição alta em uma linha não deve ser convertida em um ranking universal de qualidade para todo tipo de código.
O que os números divulgados mostram sobre o LongCat-2.5
A Meituan relata que sua arquitetura de treinamento alcançou 86% mais throughput que uma configuração de referência baseada em DDP. Throughput é a quantidade de trabalho processada por unidade de tempo. O ganho é uma medição da empresa sobre treinamento, e não uma promessa de que a API responderá 86% mais rápido.
Para inferência, a companhia informa aumento de 40% no throughput com quantização W4A4, uma técnica que usa representações de menor precisão para reduzir o trabalho computacional. O comunicado também relata redução de 16% no tempo até o primeiro token e de 20% no intervalo entre tokens. Os resultados dependem da configuração e do hardware usados pela própria empresa.
Esses indicadores ajudam a entender a engenharia do lançamento, mas não respondem sozinhos à pergunta que importa para uma equipe: se o agente termina melhor a tarefa. Latência, custo computacional, precisão, taxa de testes aprovados e quantidade de correções precisam ser avaliados juntos, usando o mesmo repositório e as mesmas instruções.
O gráfico incluído pela Meituan também mistura provas de código, navegação e visão. A publicação não fornece, na imagem, todas as condições necessárias para reproduzir cada resultado. Trate o placar como material divulgado pelo fornecedor e confirme o desempenho com tarefas representativas do seu próprio projeto.
Como testar o LongCat-2.5 em um fluxo de agentes
Comece pela documentação de integração da API LongCat, confirme o nome do modelo e os recursos habilitados para sua conta. Não copie limites de contexto ou parâmetros de outro modelo, porque a página pode mudar e as capacidades da API dependem da configuração disponibilizada.
Escolha uma tarefa pequena, mas real, como corrigir um bug com teste reproduzível ou implementar uma tela a partir de uma referência visual. Registre o estado inicial, os arquivos que o agente pode alterar e o critério objetivo de conclusão. Isso permite comparar resultados sem depender de uma impressão vaga.
Execute a mesma tarefa com o LongCat-2.5 e com o modelo que já usa. Mantenha iguais o prompt, o conjunto de ferramentas, os limites de execução e os testes. Compare se o agente concluiu a mudança, se os testes passaram, quantas intervenções foram necessárias e quanto tempo levou até uma resposta útil.
Se a tarefa envolve interface, inclua uma captura de tela de referência e avalie o resultado visual separadamente do código. Se envolve repositório, observe se o agente inspeciona dependências e testes antes de editar. São práticas de avaliação, não resultados já demonstrados pela Meituan.
Para comparar alternativas abertas de código, veja também o que foi divulgado sobre o Mistral Large 4 e o lançamento do Beam para programação e agentes. Os anúncios ajudam a montar uma lista de candidatos, mas não substituem uma avaliação controlada no seu ambiente.
Preguntas frecuentes sobre o LongCat-2.5
O que é o LongCat-2.5?
É o modelo multimodal da Meituan anunciado para tarefas de agentes, visão e programação. A documentação do LongCat o lista como disponível por API.
Qual é o tamanho do contexto do LongCat-2.5?
A documentação de parâmetros da API lista uma janela de contexto de 1.048.576 tokens. O limite de saída é diferente e deve ser consultado separadamente.
O LongCat-2.5 funciona com Claude Code, Codex e Hermes?
O changelog do LongCat lista compatibilidade com Claude Code, Codex e Hermes, entre outros harnesses. Confirme a integração disponível na documentação atual antes de configurar o projeto.
O LongCat-2.5 é melhor que outros modelos de código?
O anúncio da Meituan mostra resultados em várias avaliações, mas não comprova superioridade em todos os tipos de tarefa. Compare os modelos com o mesmo repositório, ferramentas e testes.
Como testar o LongCat-2.5 em um agente de código?
Escolha uma tarefa reproduzível, use os mesmos limites e ferramentas para cada modelo e compare testes aprovados, correções necessárias e tempo até uma resposta útil.
O LongCat-2.5 amplia as opções para agentes multimodais
O LongCat-2.5 combina uma API de modelo, entrada visual e foco em tarefas extensas de agentes. Para times que desenvolvem ferramentas de código, o ponto mais prático é poder testar se a visão melhora tarefas específicas, sem assumir que o anúncio garante desempenho superior em todo repositório.
A decisão de adoção deve considerar qualidade de saída, confiabilidade das ferramentas, segurança do ambiente e facilidade de repetir o teste. Os números publicados pela Meituan trazem contexto técnico, mas o resultado que importa é o comportamento observado com seus dados, instruções e verificações.
Tem uma ideia parada? Coloque o LongCat-2.5 para trabalhar nela e monte seu squad de agentes de IA no bridgecode.
Tags:#LongCat-2.5#Meituan#modelos multimodais#agentes de código
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Newsletter
GitHub reconstrói armazenamento Git para agentes
GitHub anunciou a nova arquitetura de armazenamento Git, Project Rubicon, capaz de receber milhares de gravações por segundo em um único repositório.
6 min

Newsletter
Palette: modelo da IBM aprende a criar slides no seu estilo
IBM e Hugging Face publicaram o Palette, modelo de 20 bilhões de parâmetros que gera apresentações em código treinado para seguir o IBM Design Language.
7 min

Newsletter
OpenAI cria padrão para infraestrutura de IA responsável
OpenAI publicou padrão para infraestrutura de IA responsável com compromissos sobre energia, água, workforce e comunidades.
5 min