
O GitHub anunciou em 5 de novembro de 2026 uma nova arquitetura de armazenamento Git, chamada Project Rubicon, capaz de receber milhares de gravações por segundo em um único repositório. Em testes internos, a equipe demonstrou 5.000 agentes simultâneos trabalhando no mesmo repositório, com 7.200 pushes por segundo, mantendo latência baixa nas leituras.
GitHub reconstrói armazenamento Git para agentes
GitHub anunciou a nova arquitetura de armazenamento Git, Project Rubicon, capaz de receber milhares de gravações por segundo em um único repositório.

Marcelo Santiago
Criador do bridgecode
The biggest AI newsletter in the World
Get AI articles in your inbox
Technical curation on models, agents and coding tools. No spam, unsubscribe anytime.
A mudança não altera a experiência do desenvolvedor: push, fetch e branch continuam iguais. O que muda é a infraestrutura por baixo, preparada para o cenário em que agentes de IA escrevem código em paralelo e em volume constante, não em rajadas curtas. Quem já acompanha lançamentos de agentes, como o Cult.fit padronizando operação em Codex, vê a mesma tendência do outro lado.
O que é o Project Rubicon
O GitHub separa a escala da plataforma em dois eixos. A escala horizontal é quantos desenvolvedores e agentes trabalham em muitos repositórios ao mesmo tempo, algo já consolidado. A escala vertical é quantos trabalham em um único repositório, e é aí que a pressão cresceu: repositórios individuais ficam maiores e mais ocupados conforme agentes escrevem código em paralelo e sem parar.
Hoje, os repositórios mais ocupados do GitHub.com recebem no máximo dezenas de gravações por segundo, em rajadas curtas. Com agentes rodando 24 horas por dia, essas rajadas viram taxa sustentada. Cada push gera mais leituras: CI roda, sistemas de deploy puxam o commit, outros agentes buscam contexto.
A meta do projeto foi de pelo menos duas ordens de magnitude a mais de escala para um único repositório.
Como funciona a nova arquitetura
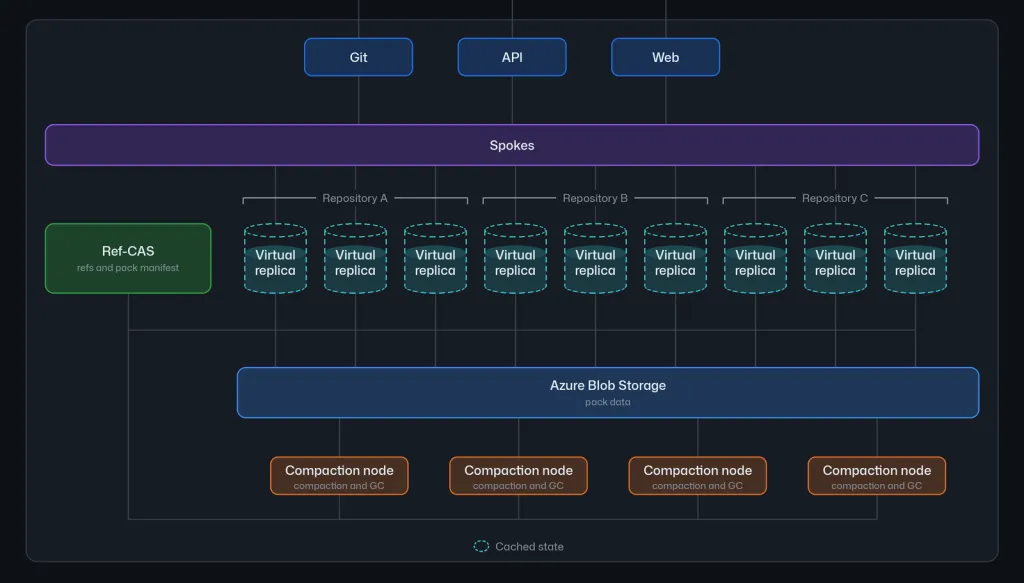
O Project Rubicon mantém o Spokes, que roteia e balanceia requisições e mantém o API interno. A diferença está na camada de dados. O Spokes envia cada requisição a um pequeno grupo de réplicas virtuais atribuídas ao repositório. Essas réplicas são computação descartável que serve leituras, gravações ou ambas. O disco local é cache reconstruível a qualquer momento.
O estado durável vive em dois lugares. Os objetos Git, em packs e dados de aceleração de leitura, ficam no Azure Blob Storage. Referências e o manifesto de packs vivem no Ref-CAS, um serviço de log replicado dedicado a compare-and-swap de referências.
Em uma gravação, a réplica virtual indexa o pack recebido, envia ao Blob Storage e comita uma transação no Ref-CAS que lista o pack no manifesto e atualiza as referências. Depois, um nó de compactação mescla esse pack com outros. Em uma leitura, a réplica verifica a versão da referência no Ref-CAS, puxa os packs necessários do Blob Storage para o cache e serve a partir dele.
Ref-CAS: consenso só onde precisa
A observação central do projeto é que muito pouco de uma gravação precisa ser ordenado. Objetos Git são imutáveis e nomeados pelo conteúdo, então dois escritores podem armazená-los ao mesmo tempo sem concordar em nada. A parte que precisa de acordo é a atualização da referência, e ela é pequena.
O time testou duas abordagens com Blob Storage puro. A primeira usava um log de escrita para todas as referências de um repositório, com escrita condicional em um único blob. Correta e com leituras baratas, mas o teto de gravação ficava em algumas centenas por segundo, porque só uma escrita condicional por blob pode estar em voo por vez. A segunda dividia referências em vários blobs por hash, aumentando o teto de gravação, mas forçando leituras a checar todos os segmentos, trocando latência de escrita por latência de leitura.
A solução foi o Ref-CAS. Cada atualização de referência é um compare-and-swap comitado por quórum. A transação bloqueia apenas as referências que toca, verifica se cada uma ainda tem o valor esperado e fica visível quando a maioria das réplicas do log registrou. Como agentes empurram para branches próprios, a maioria das atualizações não contende e replica em paralelo.
Cada commit recebe um número de sequência do log, e a versão do repositório é o LSN do último commit. Leituras começam com uma verificação de versão. Se a versão que a réplica já tem ainda é atual, a resposta não carrega referências: repositório sem mudança custa uma única comparação. Se estiver atrasada, recebe referências e versão atuais, além de ponteiros para dados de pack.
Compactação em segundo plano
Cada push adiciona um pack ao Blob Storage. Git serve um repositório a partir de vários packs, mas cada pack extra torna consultas um pouco mais caras. Quem gera muitos commits, como em fluxos com Claude Code e MCP tasks em segundo plano, se beneficia de compactação eficiente. Na arquitetura antiga, compactação rodava nas mesmas réplicas que serviam tráfego e em todas elas. Na nova, roda em segundo plano em nós separados, direto no armazenamento durável, usando o Ref-CAS para notificar réplicas virtuais do estado em evolução.
Nós de compactação assumem propriedade de um subconjunto dos dados do repositório via lease, permitindo escala horizontal. Um nó trabalha um shard por vez: toma lease, lê o manifesto para achar packs novos, coleta em um segmento aberto e, ao atingir limite por contagem, tamanho ou idade, sela o segmento e combina os packs em menos e maiores. Enquanto compacta, o próximo segmento do shard já pode capturar packs. Antes de publicar, o nó verifica que os novos packs contêm exatamente os mesmos objetos dos insumos.
O resultado é contagem de packs praticamente plana enquanto pushes sobem, com latência estável.
O que muda para quem usa GitHub
Para desenvolvedores, Git continua Git: push, fetch e branch do mesmo jeito, com as mesmas proteções. A arquitetura nova está em prévia privada limitada, com rollout mais amplo no início do próximo ano.
Se você mantém monorepo ou repositório com alto volume de CI, a promessa é que o mesmo repositório que hoje recebe dezenas de gravações por segundo passe a receber milhares sem migração ou tratamento especial.
Para quem orquestra vários agentes em paralelo, a infraestrutura deixa de ser o gargalo. A limitação passa a ser a ideia, não a plataforma.
Frequently asked questions about a nova arquitetura de armazenamento Git do GitHub
O que é o Project Rubicon do GitHub?
É a nova arquitetura de armazenamento Git do GitHub, chamada Project Rubicon, projetada para aceitar milhares de gravações por segundo em um único repositório.
Por que o GitHub precisou reconstruir o armazenamento Git?
Porque agentes de IA escrevendo código em paralelo transformam rajadas curtas de gravações em taxa sustentada, e cada push gera amplificação de leituras.
O que é o Ref-CAS?
É um serviço de log replicado dedicado a compare-and-swap de referências Git, que ordena apenas as atualizações de referência, não os objetos.
A nova arquitetura muda como uso Git no dia a dia?
Não. Push, fetch e branch continuam iguais, com as mesmas proteções. A mudança é na infraestrutura por baixo.
Quando a nova arquitetura estará disponível para todos?
Está em prévia privada limitada, com rollout mais amplo previsto para o início do próximo ano.
Conclusão
A reconstrução do armazenamento Git do GitHub é uma resposta direta ao cenário em que agentes escrevem código em paralelo e sem parar. A separação entre objetos no Blob Storage, referências no Ref-CAS e compactação em segundo plano permite que cada parte escale de forma independente. O efeito prático é que repositórios de qualquer tamanho rodam na mesma arquitetura, sem tratamento especial para os mais ocupados.
Se você acompanha infraestrutura de agentes, vale ler o post original da equipe de engenharia, que detalha requisitos, trade-offs e os próximos passos.
Em vez de só acompanhar notícias como a reconstrução do armazenamento Git do GitHub, coloque a IA para trabalhar por você no bridgecode.
Fonte: GitHub
Tags:#github#git#infraestrutura#agentes
Developer and creator of bridgecode, an agentic development environment for orchestrating squads of AI agents. Helps people going from vibe coding to professional development move from idea to shipped product.
Related articles
Newsletter
Box usa Nemotron da Nvidia para busca de conteúdo por agentes
Box e Nvidia anunciam o Box Context Retrieval, motor de busca semântica powered by Nemotron que transforma conteúdo empresarial em conhecimento para agentes de IA.
5 min
Newsletter
Karpathy constrói plataforma de vídeos em um fim de semana com Claude
Andrej Karpathy construiu o HackerTube em um fim de semana com Claude. O que isso diz sobre o ritmo de desenvolvimento com agentes de código.
5 min
Newsletter
Rich Sutton reforça que compute sozinho não cria inteligência
Turing Award Rich Sutton reforça que compute bruto não basta para inteligência e pede métodos novos, aprendizado contínuo e world models.
5 min