
Em 4 de novembro de 2026, a Dharma-AI apresentou o Dharma Field Extractor, um modelo de 2 bilhões de parâmetros que recebe a imagem de um documento e devolve os campos solicitados em JSON.
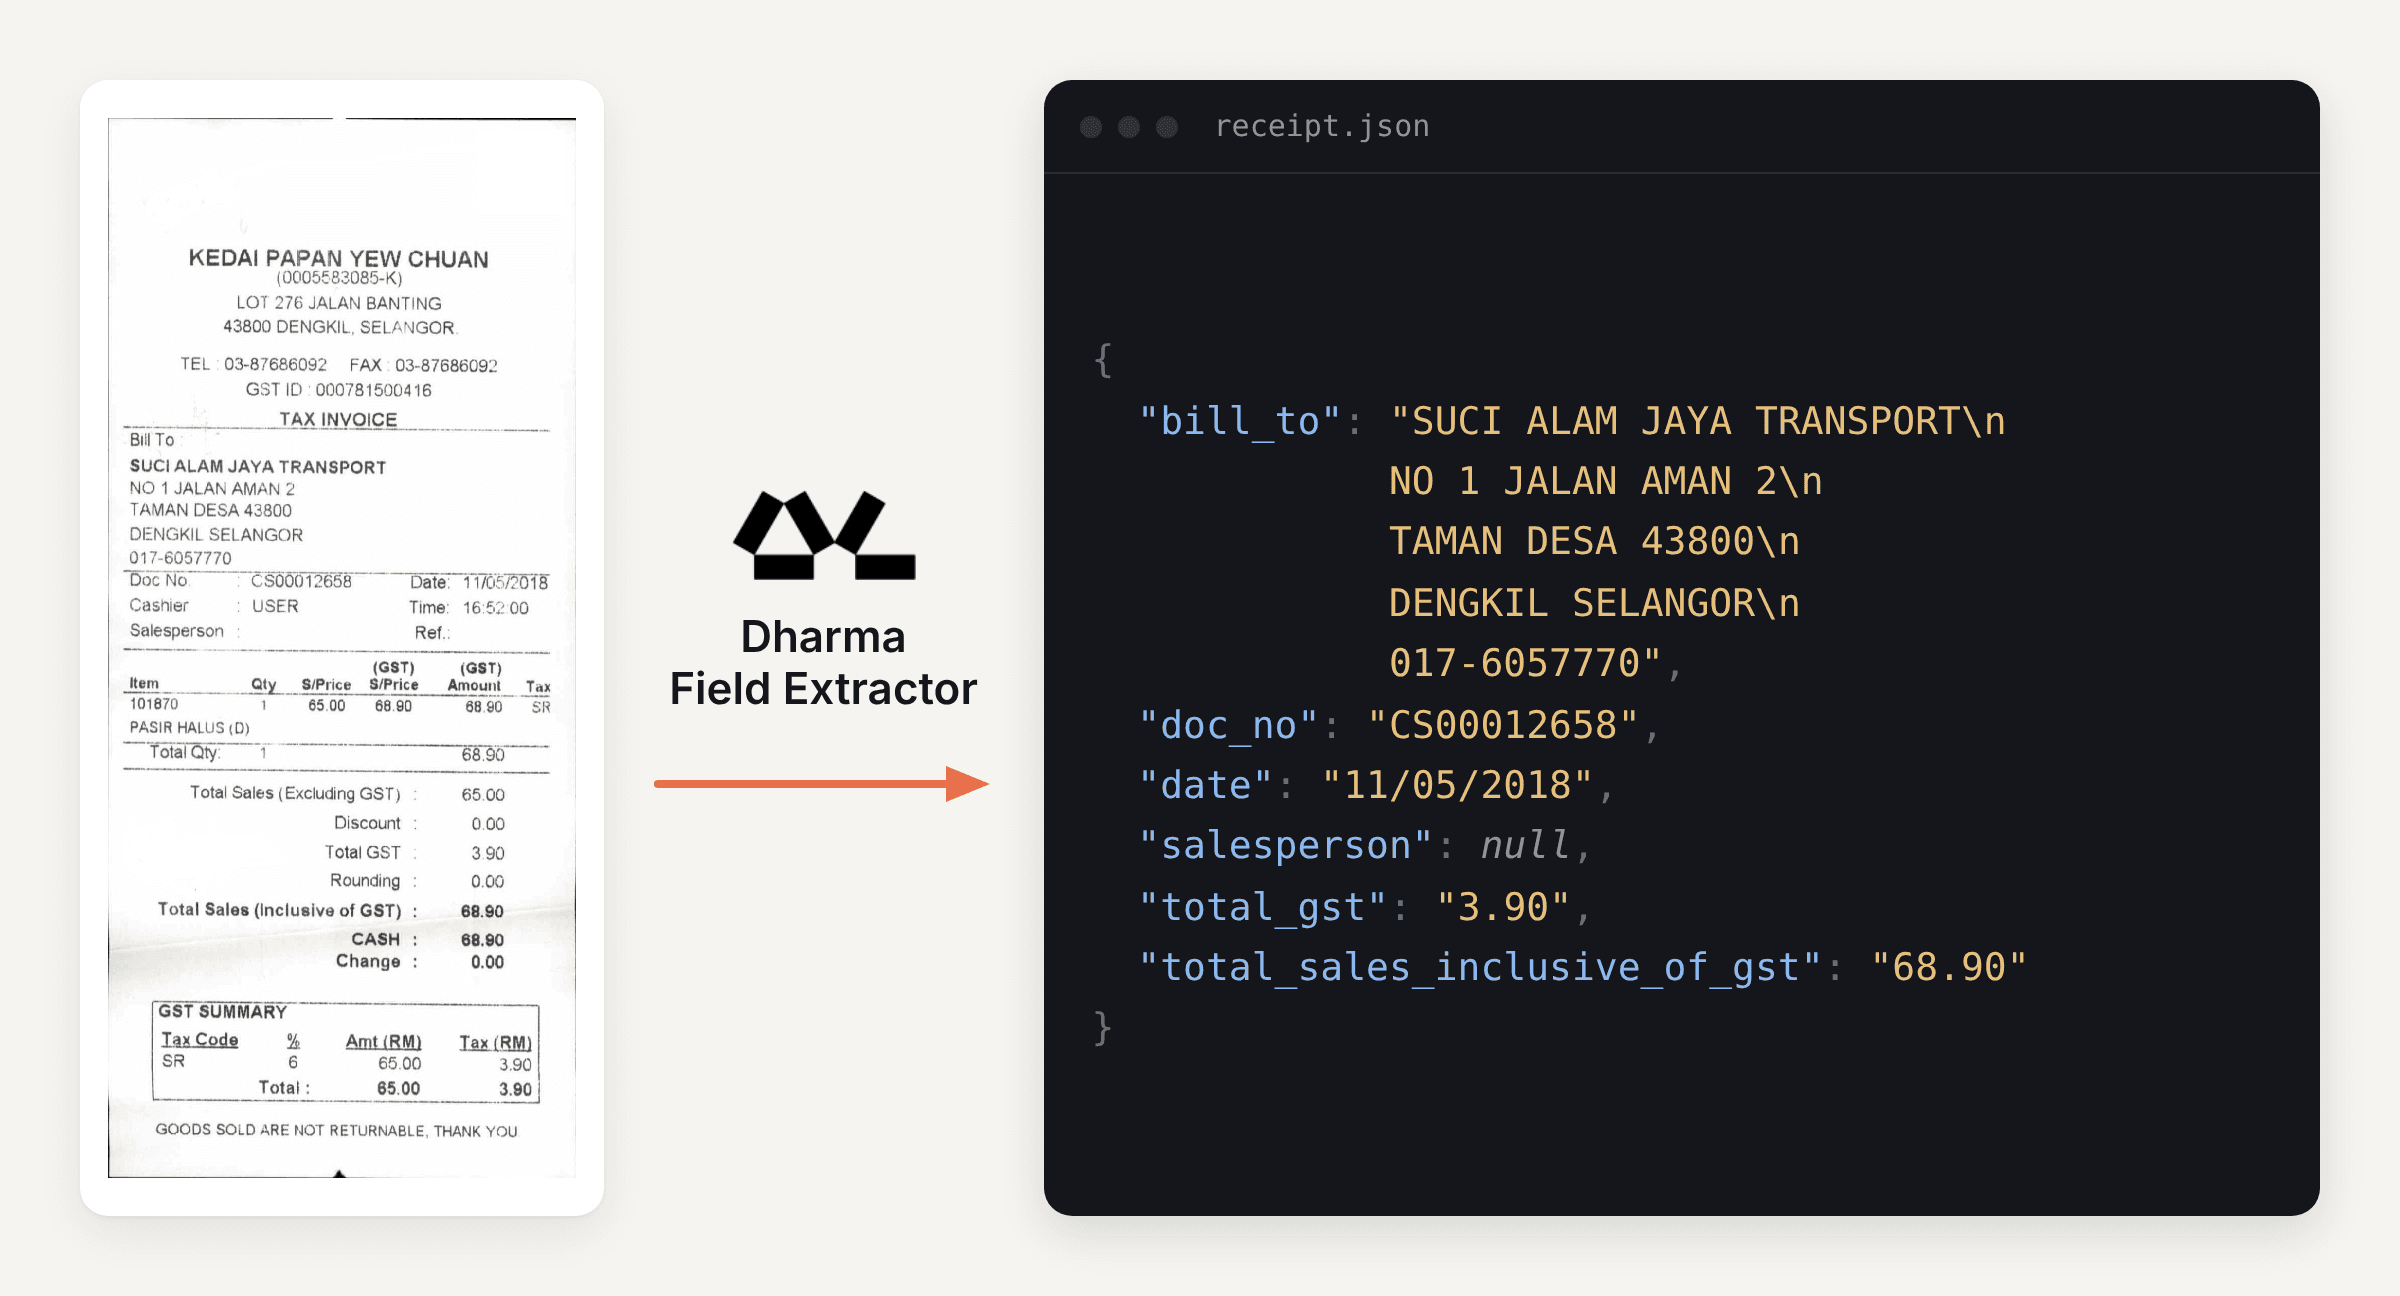
Dharma Field Extractor transforma documentos em JSON
Dharma Field Extractor transforma documentos em campos JSON. Veja o treinamento, a avaliação divulgada e o que ainda falta validar.

Marcelo Santiago
Criador do bridgecode
The biggest AI newsletter in the World
Get AI articles in your inbox
Technical curation on models, agents and coding tools. No spam, unsubscribe anytime.
A proposta é entregar dados prontos para um sistema, não apenas transcrever a página. A publicação da equipe traz a descrição, a avaliação e os limites conhecidos.
O que o Dharma Field Extractor faz com documentos
OCR é o reconhecimento do texto que aparece em uma imagem. Para extrair um documento inteiro, isso pode bastar.
Para inserir uma fatura em um sistema, porém, ainda é preciso descobrir qual trecho corresponde ao fornecedor, à data ou ao total.
O Dharma Field Extractor tenta resolver essa segunda etapa. A pessoa envia a imagem e pode pedir todos os campos que encontrar ou fornecer um esquema com os nomes e tipos que o sistema espera.
No modo aberto, o modelo infere os pares de rótulo e valor a partir do texto e do layout. No modo guiado por esquema, ele procura as chaves indicadas, como service_provider e client_company, e respeita a estrutura pedida.
A resposta é JSON, formato de dados estruturado que pode ser lido por aplicações. O artigo diz que tabelas podem voltar como listas de linhas e que um campo ausente recebe null, em vez de um valor inventado.
Esse contrato de saída é útil quando a próxima etapa já espera nomes e tipos definidos. Ele não elimina a necessidade de revisar documentos mal digitalizados, conferir campos críticos ou decidir o que fazer quando um valor não aparece.
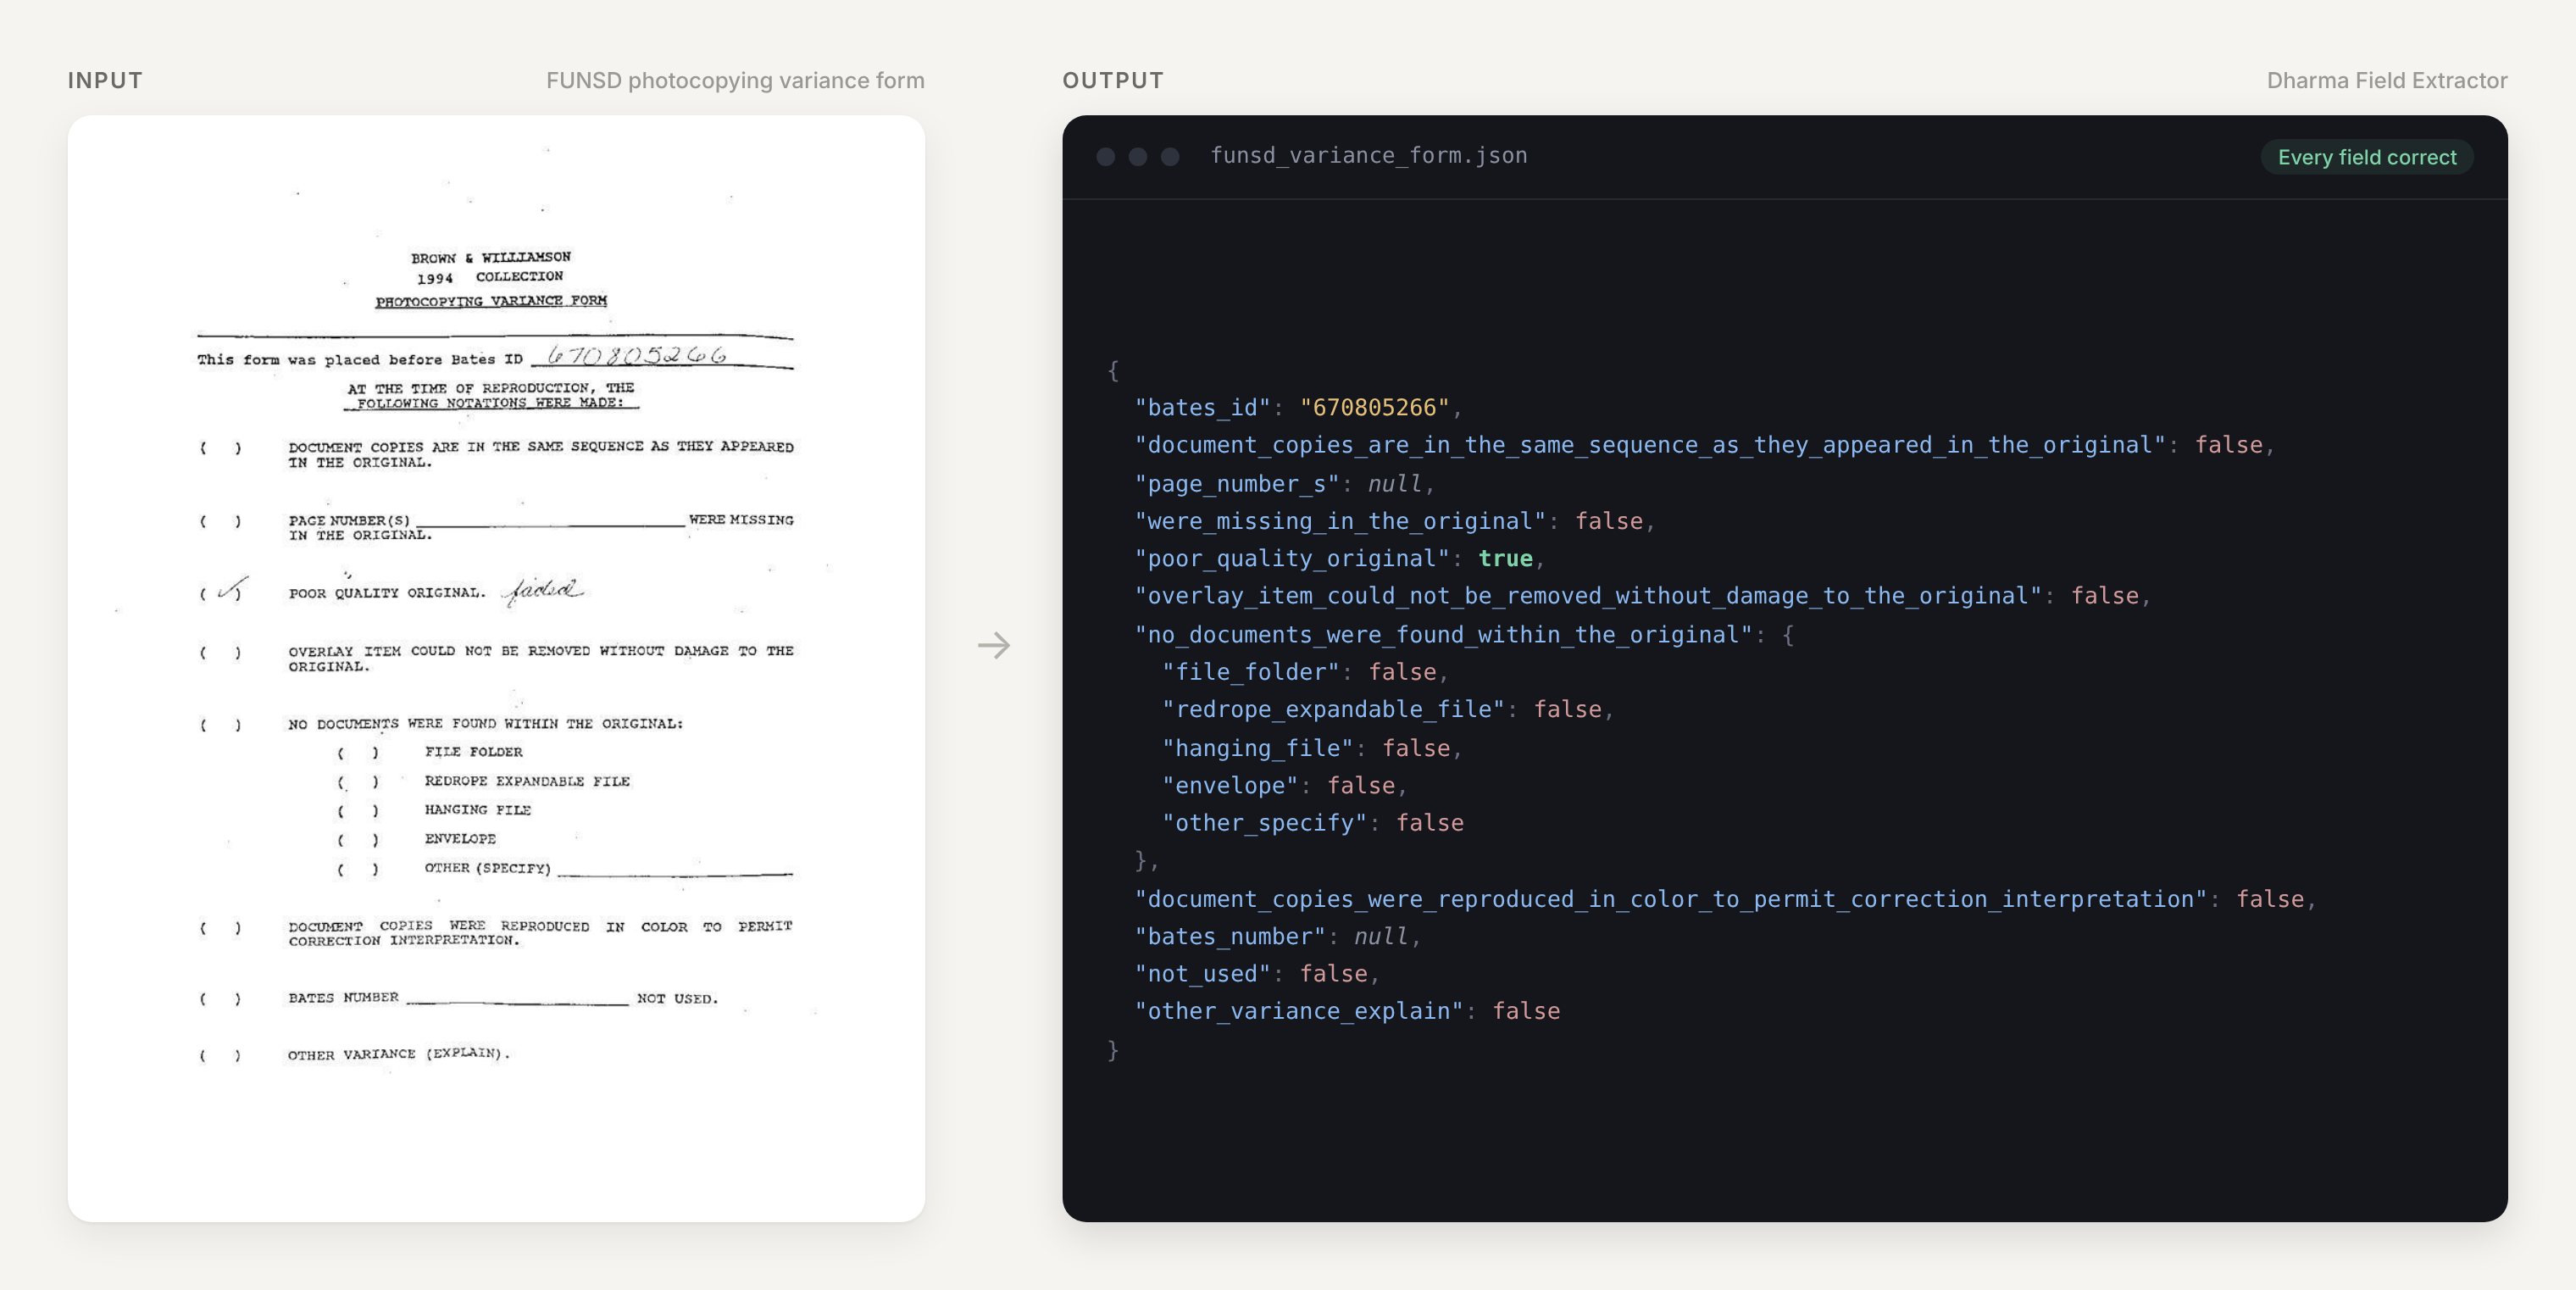
Crédito da imagem: Dharma-AI.
Como a Dharma-AI treinou o modelo
A equipe informa que a base é o DharmaOCR-LITE v1.1, com 2 bilhões de parâmetros, já especializado em reconhecimento de documentos. Sobre esse checkpoint, treinou um adaptador LoRA com 43.384 exemplos para as duas formas de pedir campos.
LoRA é uma técnica que ajusta um conjunto menor de parâmetros adicionais, em vez de atualizar todos os pesos do modelo. O artigo também relata o uso de ajuste supervisionado e DPO, uma técnica de otimização baseada em preferências.
Os exemplos foram divididos em três correntes: documentos em inglês coletados da web, documentos brasileiros reais obtidos internamente e um conjunto menor de idiomas europeus e asiáticos.
A mistura inclui recibos, faturas comerciais, formulários, extratos bancários, documentos de identidade e exemplos sintéticos. A intenção declarada é cobrir layouts variados, não otimizar para um único formulário.
O que a avaliação publicada mede
A avaliação descrita no artigo reúne 546 documentos em três cenários de solicitação, totalizando 1.638 casos. Os cenários pedem todos os campos, um esquema parcial ou um esquema que também contém campos inexistentes.
A métrica combina F1 por campo, similaridade de Levenshtein para comparar valores e a proporção de saídas que formam JSON válido.
Assim, o resultado penaliza tanto campo ausente ou trocado quanto valor textual incorreto e resposta estruturalmente inválida.
A Dharma-AI reporta nota 0,834 para o Field Extractor. Na comparação da própria equipe, Claude Opus 5 ficou em 0,816 e GPT-5.6 Luna em 0,741. Esses números pertencem ao conjunto de documentos e às configurações descritas no artigo.
A Dharma-AI também estima que a execução local custou de 6 a 147 vezes menos que as chamadas comparadas. O cálculo depende das configurações e do hardware usados, portanto não é uma tarifa universal nem uma auditoria independente.
Onde os resultados ainda precisam de validação
SROIE e FUNSD, dois conjuntos públicos usados no artigo, ficaram fora do treinamento. A equipe apresenta um exemplo de recibo com 18 campos e um formulário com caixas de seleção para ilustrar a generalização.
Esses exemplos são demonstrações individuais. Eles não provam, sozinhos, que o sistema terá a mesma precisão em qualquer idioma, tipo de documento, qualidade de digitalização ou distribuição de campos.
A avaliação foi publicada pelos próprios criadores e não é uma comparação independente. O artigo descreve os dados e a métrica, mas não informa uma replicação externa nem um teste com um fluxo de produção escolhido por terceiros.
Também é importante separar o extrator do OCR tradicional. O primeiro busca campos específicos para alimentar sistemas; o segundo entrega o texto completo da página.
Para leitura integral de contratos, a saída estruturada pode não substituir a transcrição.
A publicação liga a proposta a um portal de demonstração. No acesso consultado em 4 de novembro, o portal abriu uma tela que pede e-mail antes de continuar.
Não criamos conta nem enviamos documentos, então este rascunho não afirma que o teste foi executado.
O texto consultado lista o DharmaOCR-LITE como modelo e descreve o adaptador do extrator, mas não apresenta um artefato independente para baixar com o nome Field Extractor.
Vale confirmar a disponibilidade diretamente com a equipe antes de planejar uma integração.
Como comparar o extrator com outras opções
Comece com documentos que sua equipe possa usar com segurança e escreva antes quais campos são obrigatórios, quais podem faltar e como os valores serão validados. Isso evita aceitar uma saída apenas porque o JSON está bem formado.
Depois compare a resposta com uma referência revisada por pessoas. Separe erros de leitura, erros de associação entre rótulo e valor, campos ausentes e valores inventados. Uma única nota agregada esconde diferenças que afetam o fluxo.
Se houver um modelo geral já em uso, aplique o mesmo conjunto de documentos, esquema e critérios. O anúncio do LongCat-2.5, outro modelo multimodal discutido no blog, trata de outro perfil de uso; não é uma comparação direta com o extrator.
Acompanhe outras novidades de IA para desenvolvedores com fonte e contexto.
Se a extração de documentos fizer parte de um produto, o roteiro para criar um sistema com IA usando Codex ajuda a organizar implementação, testes e revisão em etapas.
Frequently asked questions about o Dharma Field Extractor
O que é o Dharma Field Extractor?
É um modelo especializado que transforma imagens de documentos em campos estruturados em JSON, segundo a Dharma-AI. Ele aceita um pedido aberto ou um esquema definido pelo usuário.
Qual é a base do Dharma Field Extractor?
A Dharma-AI informa que usa o DharmaOCR-LITE v1.1, com 2 bilhões de parâmetros, e treinou um adaptador LoRA com 43.384 exemplos.
O extrator consegue devolver campos ausentes?
No modo guiado por esquema, a publicação diz que um campo que não aparece no documento recebe null. O modelo não deve inventar um valor para preencher a chave.
A avaliação do Dharma Field Extractor foi independente?
Não. Os resultados foram divulgados pela própria Dharma-AI em uma avaliação de 546 documentos e 1.638 casos, incluindo SROIE e FUNSD fora do treinamento.
É possível testar o Dharma Field Extractor sem conta?
A publicação liga a um portal de demonstração, mas o acesso consultado em 4 de novembro abriu uma tela que pede e-mail. Não criamos conta nem enviamos documentos.
O Dharma Field Extractor atende a uma tarefa bem delimitada
O anúncio apresenta um caminho para converter imagens de documentos em campos JSON sem pedir que um modelo geral resolva tudo por prompt.
A vantagem alegada é maior aderência a um esquema específico, mas a prova disponível continua sendo a avaliação divulgada pela própria Dharma-AI.
Para uma decisão de produto, o próximo passo é testar com documentos representativos, revisar os campos críticos e medir erros que tenham consequência no processo. Não trate a pontuação publicada como garantia para outro conjunto de dados.
Do rascunho ao produto pronto: divida o trabalho entre agentes especialistas e acompanhe cada etapa no bridgecode.
Fonte: Dharma-AI
Tags:#Dharma Field Extractor#Dharma-AI#OCR#extração de documentos#JSON
Developer and creator of bridgecode, an agentic development environment for orchestrating squads of AI agents. Helps people going from vibe coding to professional development move from idea to shipped product.
Related articles
Newsletter
GitHub reconstrói armazenamento Git para agentes
GitHub anunciou a nova arquitetura de armazenamento Git, Project Rubicon, capaz de receber milhares de gravações por segundo em um único repositório.
6 min

Newsletter
Palette: modelo da IBM aprende a criar slides no seu estilo
IBM e Hugging Face publicaram o Palette, modelo de 20 bilhões de parâmetros que gera apresentações em código treinado para seguir o IBM Design Language.
7 min

Newsletter
OpenAI cria padrão para infraestrutura de IA responsável
OpenAI publicou padrão para infraestrutura de IA responsável com compromissos sobre energia, água, workforce e comunidades.
5 min