
CONFIRMADO | OFICIAL
Memory Tax expone el costo oculto de la memoria de agentes
Preprint en arXiv compara sistemas de memoria y RAG en tres benchmarks y reporta casos en los que la memoria reduce la precisión.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
El 25 de octubre de 2026, investigadores publicaron en arXiv el preprint Memory Tax: Dissecting the Net Value of Agent Memory. El estudio concluye que varios sistemas dedicados de memoria quedan por debajo de una línea de base simple de recuperación de datos en parte de las evaluaciones.
La conclusión no es que la memoria sea inútil. Los autores intentan medir el beneficio y la pérdida causada por organizar, resumir y recuperar el historial antes de responder.
En este artículo vas a ver:
- Lo que el paper llama Memory Tax
- Cómo compara la memoria de agentes con RAG
- Qué límites afectan la lectura de los resultados
- Cómo probar la memoria de un agente en tu propio caso
O que o estudo Memory Tax mediu
Un agente con memoria intenta guardar información de conversaciones o tareas anteriores para usarla después. La promesa es evitar que el modelo empiece de cero y permitir respuestas que dependan de preferencias o hechos ya registrados.
El estudio define RAG como una alternativa de referencia: en lugar de mantener una memoria ya estructurada, el sistema busca fragmentos del historial bruto cuando recibe una pregunta. RAG significa generación aumentada por recuperación, en la que una búsqueda provee contexto al modelo antes de la respuesta.
Los autores comparan esa línea de base con sistemas que organizan, resumen o relacionan la información guardada. La pregunta central es si la organización mejora la respuesta lo suficiente como para compensar lo que puede dejar fuera.
La evaluación cubre tres benchmarks: LongMemEval-s, PersonaMem-v2 y MINT-Eval. Incluyen tareas de recuerdo directo y preguntas más complejas, como unir hechos dispersos o resolver interferencia entre información.
El paper prueba tres modelos base: Qwen3.5-4B, Qwen3.6-27B y GPT-5.6-luna(low). Los autores también miden acuracia, tokens usados, tiempo de ejecución, llamadas al modelo y tamaño del almacenamiento.
La página del estudio en arXiv también apunta al código y a los resultados asociados. Esto permite que los lectores examinen la configuración y traten de reproducir las comparaciones en sus propios sistemas.
Como a memória de agentes pode cobrar um custo oculto
Los autores llaman Memory Tax a la pérdida que aparece cuando la memoria transforma el historial original. Un resumen puede ser más corto y fácil de consultar, pero también puede borrar una excepción, una fecha o la relación entre dos hechos.
El concepto se compara con el beneficio de la memoria. El sistema puede organizar información y reducir el esfuerzo de búsqueda, pero solo hay ganancia neta si la respuesta mejora sin que la recuperación se vuelva cara o incompleta.
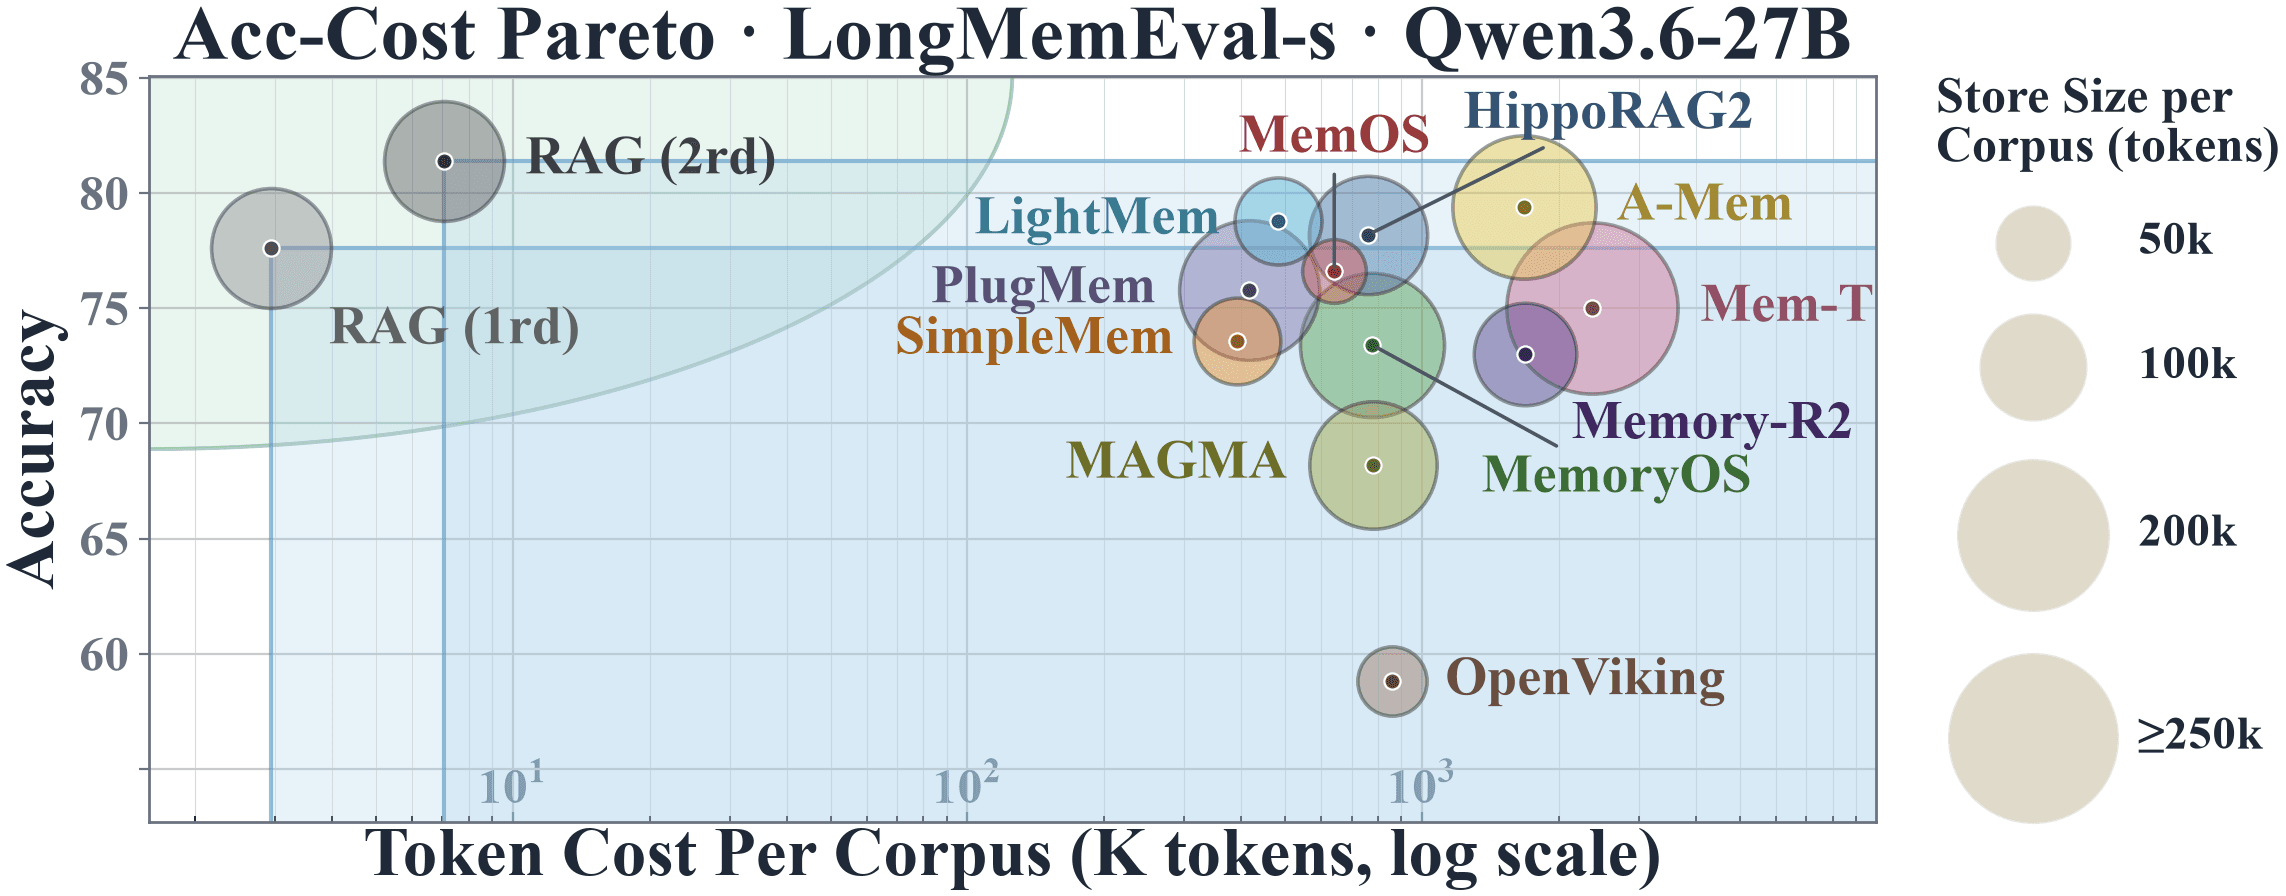
En el gráfico de LongMemEval-s, el eje vertical representa acuracia y el horizontal representa el costo de tokens por corpus. El tamaño de las burbujas representa el volumen almacenado. En la configuración mostrada, RAG de una y dos rondas aparece junto a alternativas de memoria con distintos intercambios entre costo y acuracia.
La lectura correcta está restringida al benchmark y al modelo del gráfico. El resultado no muestra que RAG siempre gane, ni que toda memoria estructurada perjudique a todo agente. Muestra por qué comparar solo la acuracia final puede ocultar costo y pérdida de información.
Los autores reportan que diversos sistemas especializados quedan por debajo del RAG simple en varias situaciones probadas. Como esa conclusión depende del conjunto de tareas, del modelo y de los límites de recuperación, debe tratarse como una alerta para la evaluación, no como regla universal.
Lo que los resultados de memoria no prueban
El paper no compara todos los sistemas de memoria existentes. Selecciona representantes de diferentes enfoques, incluyendo almacenamiento plano, organización jerárquica, grafos y políticas entrenadas.
También hay límites de muestreo. Por restricciones de costo, la evaluación usa el 20% de PersonaMem-v2 y el 10% de MINT-Eval, elegidos por muestreo estratificado entre tipos de pregunta.
Las respuestas son evaluadas por un modelo juez, apoyado en Qwen3.6-27B. Este diseño hace posible medir muchas respuestas, pero la puntuación sigue dependiendo de la calidad del juez y de la rúbrica usada por los investigadores.
El artículo está en arXiv como preprint, por lo que sus resultados merecen revisión crítica y reproducción independiente. Una publicación previa puede ser útil para orientar pruebas, pero no sustituye la evidencia acumulada en distintas aplicaciones y equipos.
La segunda figura muestra otro recorte, MINT-Eval con Qwen3.5-4B. Usa la misma idea de comparar precisión, costo en tokens y tamaño del almacenamiento, pero es otro modelo y otro benchmark, por eso no debe mezclarse directamente con el primer gráfico.
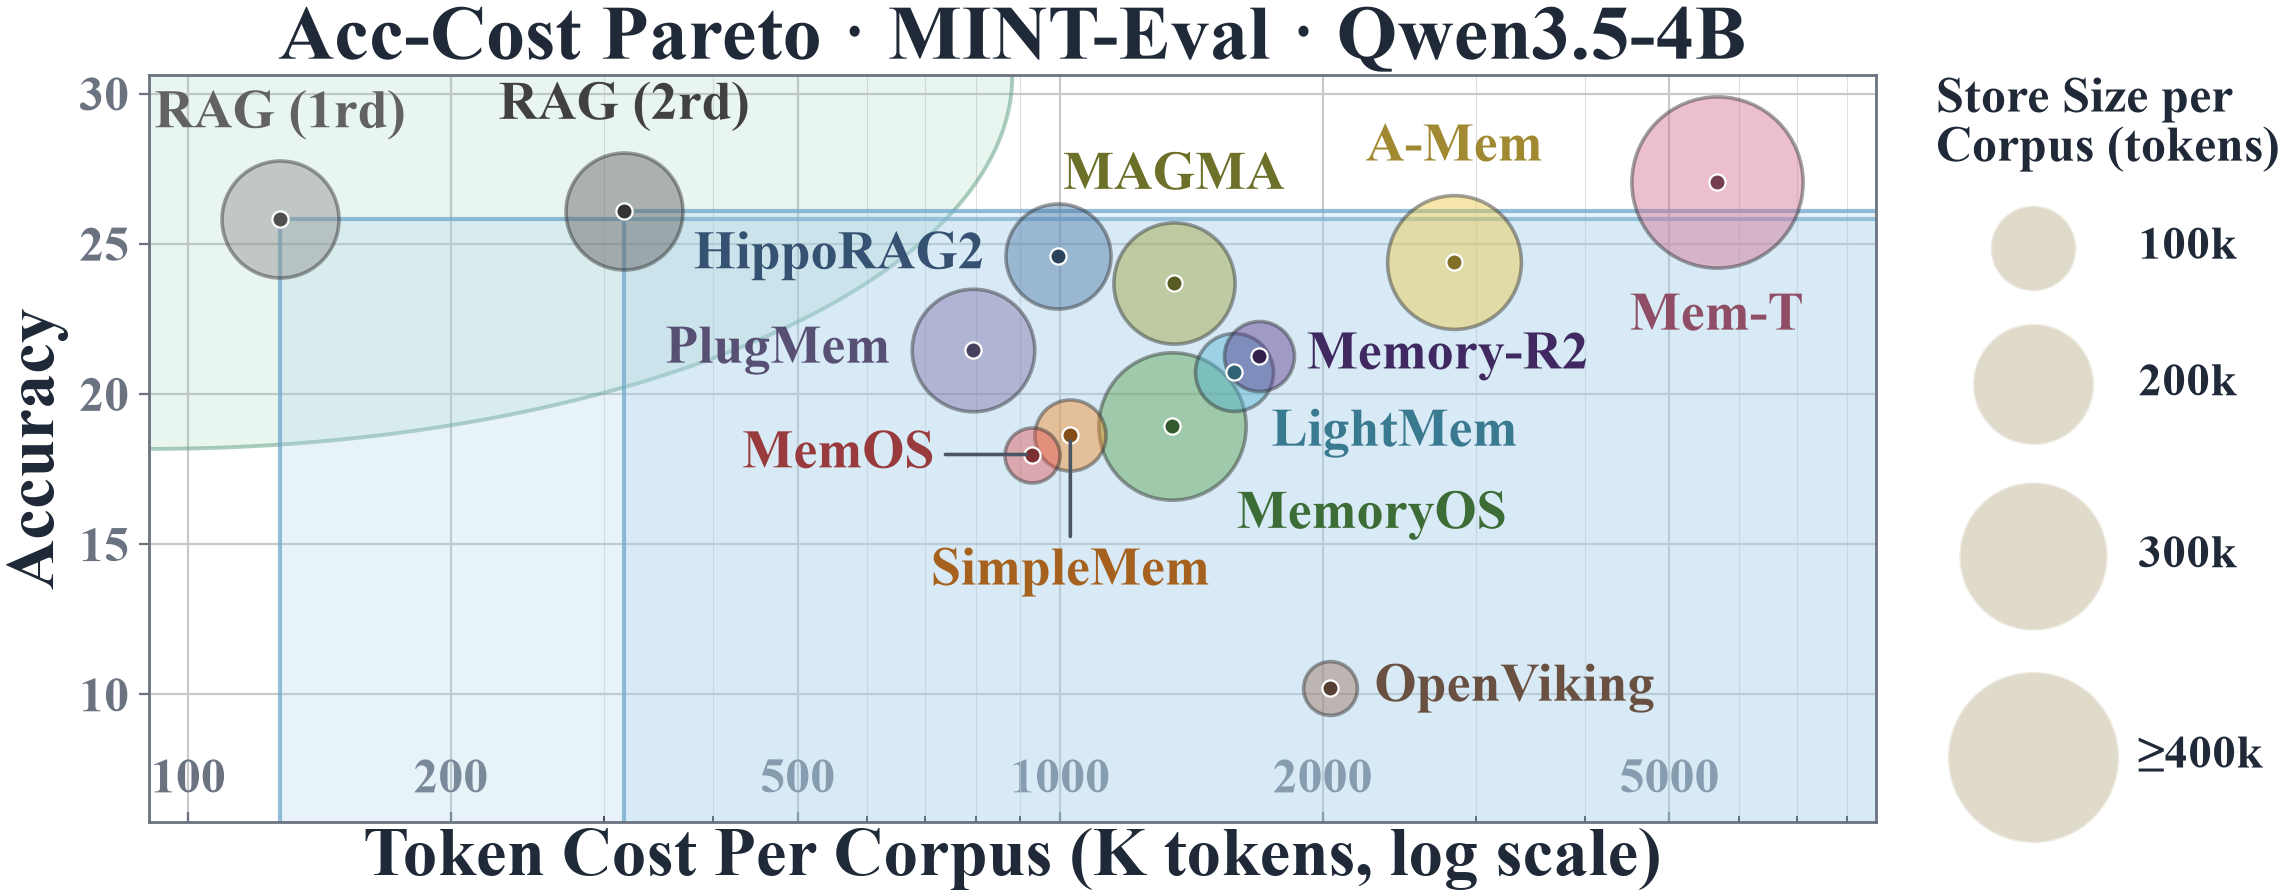
La diferencia entre los recortes es importante para quien construye agentes. Una arquitectura puede funcionar bien en recuerdo directo y peor en preguntas que exigen combinar evidencias; el benchmark y el modelo deben acompañar la hipótesis que quieres probar.
Cómo probar la memoria de un agente en tu producto
Comienza con una línea base sin memoria especializada. Guarda el historial de prueba, recupera fragmentos relevantes por búsqueda simple y registra si la respuesta encuentra la información correcta.
Luego implementa la memoria que quieres evaluar sin cambiar el modelo, el prompt, el conjunto de preguntas o el presupuesto de recuperación. Si varias condiciones cambian al mismo tiempo, es difícil atribuir la diferencia a la memoria.
Arma casos con preferencias, hechos, excepciones y contradicciones. Incluye ejemplos en los que la respuesta correcta depende de un detalle antiguo, pero también casos en los que una información antigua fue reemplazada por otra más reciente.
Mide la precisión junto con el costo de tokens, latencia, llamadas y tamaño de los datos guardados. Una memoria que acierta más, pero aumenta mucho el tiempo o envía contexto irrelevante, puede no compensar en tu producto.
Revisa además privacidad, retención y aislamiento entre usuarios. La memoria no debe mezclar historiales de cuentas distintas ni guardar más datos de los que el flujo necesita.
Para estructurar las herramientas e instrucciones de un agente, ve el artículo sobre Cursor Agent SDK para crear agentes en TypeScript y la guía práctica de creación de agentes con ese SDK. Tratan de la construcción y evaluación del agente, mientras que el estudio actual se concentra en el valor neto de la memoria.
Preguntas frecuentes sobre el estudio Memory Tax sobre memoria de agentes
¿Qué significa Memory Tax en agentes de IA?
Memory Tax es el nombre que los autores dan a la pérdida de evidencias que puede ocurrir cuando un sistema organiza, resume o recupera el historial para formar la memoria de un agente.
¿El estudio concluyó que RAG siempre vence a los sistemas de memoria?
No. El estudio reporta que varios sistemas dedicados quedan por debajo del RAG simple en parte de las evaluaciones, pero eso depende del benchmark, del modelo y de la configuración.
¿Qué benchmarks y modelos se evaluaron en Memory Tax?
LongMemEval-s, PersonaMem-v2 y MINT-Eval. Los autores probaron Qwen3.5-4B, Qwen3.6-27B y GPT-5.6-luna(low).
¿El paper Memory Tax ya es un consenso sobre memoria de agentes?
No. El artículo está disponible en arXiv como preprint. Sus resultados deben interpretarse considerando el muestreo, el modelo juez y la necesidad de reproducción independiente.
¿Cómo probar si la memoria mejora mi agente?
Compara una línea base RAG con la memoria propuesta usando el mismo modelo, prompt, preguntas y presupuesto de recuperación. Registra precisión, tokens, latencia, llamadas e aislamiento entre usuarios.
Lo que Memory Tax cambia en la evaluación de agentes
La pregunta útil deja de ser solo “¿el agente recuerda?” y pasa a incluir “¿qué preserva, cuánto cuesta recuperar y qué evidencia puede perderse?”. Esto ayuda a evitar memoria compleja sin ganancia medida.
El estudio ofrece una estructura para comparar beneficio y costo, no una respuesta final para todas las aplicaciones. Probar con tareas reales, controles equivalentes y criterios de seguridad sigue siendo la forma más responsable de decidir.
Una estrategia de memoria resuelve una parte del agente. Un squad puede planear, implementar y revisar el sistema completo, y eso es lo que montas en bridgecode](https://bridgecode.app/).
Fuente: arXiv
Tags:#Memory Tax#memória de agentes#RAG#avaliação de agentes
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Newsletter
Karpathy construye una plataforma de videos en un fin de semana con Claude
Andrej Karpathy construyó HackerTube en un fin de semana con Claude. Lo que esto dice sobre el ritmo de desarrollo con agentes de código.
5 min
Newsletter
Rich Sutton refuerza que el compute por sí solo no crea inteligencia
Rich Sutton, premio Turing, refuerza que el compute bruto no basta para la inteligencia y pide métodos nuevos, aprendizaje continuo y world models.
5 min
Newsletter
Auditores de IA detectan mal comportamiento pero generan falsas alarmas
Los modelos de IA detectan buena parte del mal comportamiento de otros agentes, pero generan muchas falsas alarmas. Mira los números del estudio de Andy Hall.
6 min