
Rich Sutton, ganador del Premio Turing y autor del influyente ensayo "The Bitter Lesson" de 2019, publicó en X el 8 de noviembre de 2026 un nuevo texto que reabre el debate sobre qué es lo que realmente genera inteligencia artificial. La tesis central es directa: el cómputo bruto por sí solo no basta. La ciencia de la IA necesita métodos nuevos y está "lejos de terminada".
Rich Sutton refuerza que el compute por sí solo no crea inteligencia
Rich Sutton, premio Turing, refuerza que el compute bruto no basta para la inteligencia y pide métodos nuevos, aprendizaje continuo y world models.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
La publicación tuvo fuerte repercusión en la comunidad de IA en X, señal de que Sutton tocó un punto sensible. Ya había criticado los límites de escalar únicamente modelos de lenguaje grandes, llamó a los datos sintéticos "gran error" y defendió agentes con world models que aprenden continuamente a partir de su propia experiencia. El nuevo texto refuerza y organiza esas ideas.
En este artículo verás:
- Lo que Sutton quiere decir con "el cómputo por sí solo no basta"
- Por qué los datos sintéticos son, en su visión, un callejón sin salida
- Qué son los world models y el aprendizaje continuo
- Cómo Jerry Tworek y Jayden Teoh reaccionaron al ensayo
- Qué cambia para quienes construyen con IA
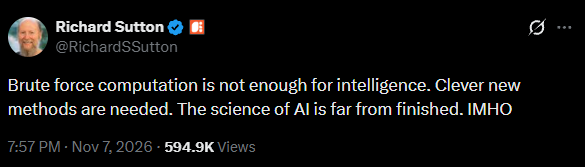
Qué quiere decir Sutton con que el cómputo por sí solo no basta
En "The Bitter Lesson", Sutton argumentó que métodos generales que escalan con cómputo terminan venciendo a enfoques sofisticados hechos a mano. La lección era sobre la fuerza del scaling. En el nuevo texto, no niega eso, pero corrige una lectura común: escalar no significa lanzar más cómputo y esperar que emerja inteligencia.
La tesis ahora es que el mundo real es infinitamente complejo. La experiencia humana se vuelve cuello de botella e impide el verdadero scaling. Hay que descubrir ideas que crezcan con el cómputo, en lugar de depender de suposiciones humanas. Sin métodos nuevos, más cómputo solo repite lo que ya se sabe.
Por qué los datos sintéticos son un callejón sin salida
Sutton ya había llamado a los datos sintéticos "gran error". El argumento es simple: el mundo real es infinitamente complejo, y cualquier simulación de él es solo "microscópica". Los modelos entrenados con datos sintéticos aprenden un mundo simplificado, no el mundo de hecho.
Esto tiene consecuencia práctica. Si la base de entrenamiento es una copia imperfecta de la realidad, el modelo hereda las limitaciones de la copia. Sutton defiende que la IA necesita aprender del mundo real, de forma continua, y no de una fotografía estática de él.
World models y aprendizaje continuo
La propuesta de Sutton es construir agentes con world models que aprendan de forma continua a partir de su propia experiencia. El mundo es mucho más complejo de lo que captura el texto de internet, y los modelos de lenguaje actuales no siguen aprendiendo después del entrenamiento.
Lo que falta es aprendizaje continuo sin destruir el conocimiento antiguo. Hoy, cuando un modelo aprende algo nuevo, tiende a olvidar lo que sabía. Resolver esto es, para Sutton, el próximo paso real de la investigación.
Mira también cómo la METR evaluó la aceleración del desarrollo de IA en Anthropic y cómo la OpenAI crea estándar para infraestructura de IA responsable.
Cómo reaccionó la comunidad
Jerry Tworek, investigador que dejó OpenAI para explorar nuevos enfoques de IA, contextualiza el ensayo. La bitter lesson sigue vigente, pero cuanto más cómputo se destina al entrenamiento, más importa el algoritmo. Algunos algoritmos escalan, otros chocan contra callejones sin salida, y muchas dimensiones de scaling siguen inexploradas. El éxito temporal del scaling de transformers, combinado con una lectura equivocada de la bitter lesson, "hackeó el cerebro de toda una generación de científicos".
Jayden Teoh apunta otro ángulo. Vio repetidamente cómo la bitter lesson bloquea investigaciones académicas, con ideas prometedoras descartadas por alejarse demasiado del espíritu del ensayo. En su visión, esto no es culpa de Sutton, sino una lectura equivocada del mensaje original.
Qué cambia para quien construye con IA
Para quien usa IA en el día a día, el mensaje es de cautela y de método. Los modelos cada vez más grandes siguen siendo útiles, pero no son el fin de la historia. La próxima generación de sistemas dependerá de métodos de aprendizaje continuo, world models y agentes que interactúen con el mundo real.
Mientras tanto, lo mejor es tratar al modelo como una herramienta poderosa, pero limitada. Dividir el trabajo en tareas más pequeñas, validar resultados y no asumir que el modelo "sabe" lo que está haciendo. Quien construye productos sobre IA debe planear para la transición, no para la estagnación.
La lección práctica para los equipos de ingeniería es clara: sigue usando modelos grandes donde brillan, pero invierte en evaluación, en datos de dominio y en flujos que permitan cambiar de modelo sin reescribir el producto. La próxima ventaja competitiva puede no ser el modelo más grande, sino el sistema que aprende más rápido con el feedback del mundo real.
Preguntas frecuentes sobre el ensayo de Rich Sutton sobre compute e inteligencia
¿Qué es The Bitter Lesson?
Es el ensayo de 2019 de Rich Sutton que argumenta que los métodos generales que escalan con compute terminan superando los enfoques sofisticados hechos a mano.
¿Sutton cambió de idea sobre el scaling?
No. Refuerza la bitter lesson, pero corrige la lectura de que basta con lanzar más compute. Los métodos nuevos siguen siendo necesarios.
¿Por qué los datos sintéticos son un problema?
Sutton los llama un gran error porque el mundo real es infinitamente complejo y cualquier simulación es solo microscópica, heredando limitaciones.
¿Qué son los world models?
Modelos que representan el mundo y permiten que los agentes aprendan de forma continua a partir de su propia experiencia, sin olvidar el conocimiento antiguo.
¿Esto afecta a quien usa IA en el día a día?
Sí. Los modelos más grandes siguen siendo útiles, pero la próxima generación dependerá del aprendizaje continuo y de agentes que interactúen con el mundo real.
Conclusión
El ensayo de Sutton no es un obituario del scaling. Es un recordatorio de que el compute es necesario, pero no suficiente. La inteligencia real exige métodos que aprendan con el mundo, no solo más parámetros.
Quien acompaña la IA de cerca sabe que los mayores cambios llegan cuando alguien cuestiona la ortodoxia. Sutton lo hizo antes, en 2019, y lo vuelve a hacer ahora.
CTA
Fuente: Richard Sutton
Tags:#radar#ia
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Newsletter
Auditores de IA detectan mal comportamiento pero generan falsas alarmas
Los modelos de IA detectan buena parte del mal comportamiento de otros agentes, pero generan muchas falsas alarmas. Mira los números del estudio de Andy Hall.
6 min

Newsletter
Palo Alto negocia la compra de una startup de seguridad para agentes
Palo Alto Networks negocia la compra de Clutch Security, startup de seguridad para credenciales de agentes de IA, por US$ 500 millones.
5 min

Newsletter
Underdog lanza modelo de voz de 32 MB en el navegador
La startup Underdog lanzó Woof, un modelo de voz de 32 MB que funciona en el navegador sin internet y está abierto para descarga.
5 min