
Google anunció el 9 de noviembre de 2026 dos nuevos sistemas de la octava generación de TPU: el TPU 8tx, enfocado en inferencia confidencial, y el TPU 8i Max, orientado a ventanas de contexto masivas. Con esto, la octava generación pasa a tener cuatro sistemas, algo inédito para la empresa en un solo año.
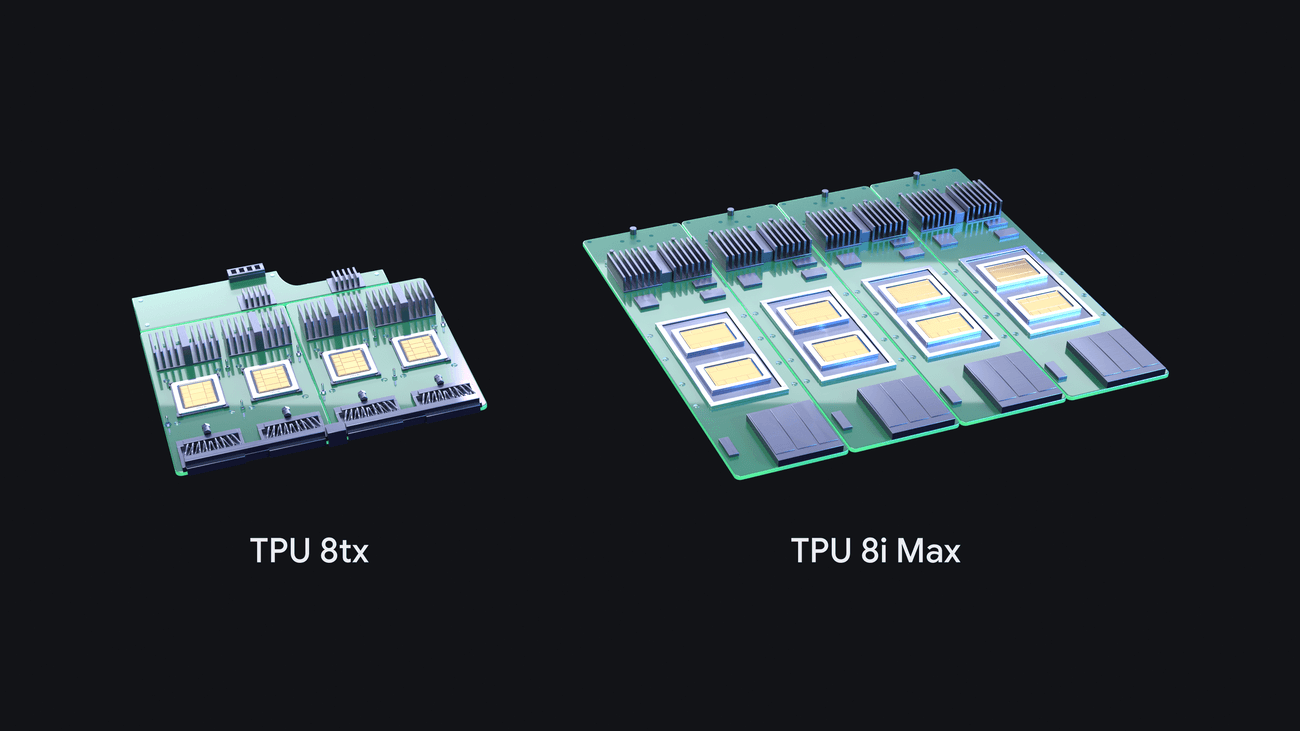
Google lanza TPU 8tx y 8i Max para la era de los agentes de IA
Google anuncia TPU 8tx para inferencia confidencial y 8i Max para contextos masivos, completando cuatro sistemas en la octava generación en un solo año.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
La motivación es el cambio en el perfil de carga. Los agentes de IA no solo responden preguntas: ejecutan tareas en múltiples etapas, acceden a datos sensibles y procesan contextos enormes, como bases de código completas o horas de video. El hardware genérico no atiende estos dos extremos.
En este artículo vas a ver:
- Qué es el TPU 8tx y para quién sirve
- Qué es el TPU 8i Max y cómo resuelve el cuello de botella de memoria
- Cómo se complementan los cuatro sistemas
- Qué cambia para quienes construyen agentes
TPU 8tx: inferencia confidencial con seguridad en hardware
El TPU 8tx es el tercer sistema de la octava generación. Está optimizado para inferencia segura y confidencial, y también sirve para entrenamiento a pequeña escala. El público objetivo son empresas reguladas y gobiernos que ejecutan modelos de frontera o propietarios junto con datos sensibles y agentes autónomos.
El diferencial es la seguridad a nivel de hardware. Normalmente, los datos se cifran en reposo y en tránsito, pero deben desbloquearse en memoria durante el procesamiento. El TPU 8tx mantiene los datos y los pesos del modelo protegidos y aislados incluso durante el uso activo, construyendo la seguridad directamente en la capa de hardware.
El sistema usa el mismo silicio del TPU 8t, con hosts de CPU AMD EPYC de quinta generación, y adopta la red Boardfly de baja latencia creada para razonamiento en tiempo real. El resultado es hasta 2 veces menos latencia en comparación con el TPU 8t, con una penalidad de rendimiento cercana a cero.
Como el sistema combina cómputo de entrenamiento con una red rápida de inferencia, las organizaciones pueden ejecutar y personalizar modelos en un mismo sistema: fine-tuning con datos privados, destilación de modelos grandes a más pequeños y entrenamiento de agentes por aprendizaje por refuerzo, sin migrar datos sensibles entre clústeres.
TPU 8i Max: duplicar cómputo y memoria en el mismo espacio
El TPU 8i Max resuelve un problema distinto: el muro de memoria. Cuando decenas de agentes trabajan juntos sobre una base de código completa o horas de video, el ancho de banda de memoria se vuelve cuello de botella rápidamente.
La solución fue combinar dos chips TPU 8i de baja latencia en un solo paquete. El 8i Max entrega el doble de cómputo, el doble de SRAM y el doble de ancho de banda de HBM en comparación con el 8i, manteniendo a los procesadores abastecidos con los datos esenciales y evitando que cargas grandes se traben.
Como el 8i Max cabe el doble de silicio en el mismo espacio de rack, los centros de datos pueden desplegar significativamente más poder de cómputo por metro cuadrado y por vatio.
Cómo se complementan los cuatro sistemas
Juntos, los cuatro sistemas de la octava generación cubren cada etapa del ciclo de vida agéntico. El TPU 8t sirve para entrenamiento a escala, con superpods de hasta 9.600 chips. El TPU 8i está optimizado para razonamiento en tiempo real, con 80% mejor rendimiento por dólar en inferencia de baja latencia para modelos MoE. El TPU 8tx cubre cómputo confidencial para empresas reguladas. El TPU 8i Max atiende ventanas de contexto masivas y máxima densidad de cómputo por rack.
Esta es la primera vez que Google introduce cuatro sistemas TPU en un solo año. La empresa también refuerza el compromiso con software abierto: soporte a PyTorch, herramientas open-source y automatización para desarrolladores, con el objetivo de hacer las TPU accesibles a todo desarrollador y cliente de nube.
Cómo probar el TPU 8tx y el 8i Max hoy
El anuncio no incluye instrucciones de acceso directo. Google dirige a los interesados a la página de TPUs en Google Cloud y a la presentación en vivo transmitida el día del anuncio.
Para quienes ya usan TPUs en la nube, vale la pena seguir las actualizaciones de disponibilidad regional y los nuevos planes de consumo que la empresa mencionó, incluyendo Agent Compute Engine como API para clientes de nube. Los equipos que ejecutan agentes con contextos largos deben evaluar si el 8i Max reduce la necesidad de particionar el contexto entre múltiples chips.
Preguntas frecuentes sobre el TPU 8tx y el 8i Max de Google
¿Qué es el TPU 8tx?
Es el tercer sistema de la octava generación de TPU de Google, optimizado para inferencia segura y confidencial, con seguridad a nivel de hardware y hasta 2 veces menos latencia que el TPU 8t.
¿Qué es el TPU 8i Max?
Es el cuarto sistema de la octava generación, que combina dos chips TPU 8i en un paquete para entregar el doble de cómputo, SRAM y ancho de banda de HBM, orientado a ventanas de contexto masivas.
¿Cuántos sistemas tiene la octava generación de TPU?
Cuatro: TPU 8t para entrenamiento a escala, TPU 8i para razonamiento en tiempo real, TPU 8tx para computación confidencial y TPU 8i Max para contextos masivos.
¿Por qué Google lanzó cuatro sistemas en un año?
La empresa afirma que es la primera vez que introduce cuatro sistemas TPU en un solo año, respondiendo al cambio en el perfil de carga de los agentes de IA.
¿Los sistemas ya están disponibles?
El anuncio no detalla disponibilidad ni precios. Google transmitió una presentación en vivo el mismo día con más información.
Qué cambia para quienes construyen agentes
Para quienes desarrollan agentes de IA en producción, el mensaje es que la infraestructura se está especializando. La seguridad de datos, la latencia de razonamiento y la escala de contexto dejan de ser compromisos y pasan a tener hardware dedicado.
La disponibilidad de los sistemas y los precios no se detallaron en el anuncio. Google también transmitió una presentación en vivo el mismo día con más detalles. Quienes siguen la infraestructura de IA pueden compararlo con el Google Antigravity ganando modo de voz para guiar agentes y con la Gemini Omni 1.2 Flash generando videos de hasta 15 segundos.
El anuncio también destaca que las TPUs ya tienen casi 100 clientes externos y que la octava generación ofrece hasta 2,7 veces mejor rendimiento de entrenamiento y un 80% mejor rendimiento por dólar en inferencia en comparación con la generación anterior. Esto coloca a la infraestructura de Google en posición de competir directamente con las ofertas de aceleradores de NVIDIA y AMD en el segmento de agentes.
Fuente: Google
Tags:#Google#TPU#infraestrutura#agentes#hardware
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Newsletter
Automattic une apps de vibe coding en una plataforma para publicar en la web
Automattic une apps de vibe coding en una plataforma para publicar apps en la web. Mira cómo funciona y qué cambia para los equipos que crean con IA.
4 min
Newsletter
Medium lanza TK, app de notas con IA en el editor
Medium lanzó TK, una app de notas y escritura con asistente de IA integrado en el editor. Mira cómo funciona y qué cambia para quienes escriben.
6 min
Newsletter
Otter.ai lanza la mayor expansión multilingüe de su historia
Otter.ai anunció 27 nuevos idiomas y transcripción multilingüe que sigue el cambio de idioma dentro de una misma reunión. Mira qué cambia y cómo probarlo.
6 min