
El 4 de noviembre de 2026, Dharma-AI presentó el Dharma Field Extractor, un modelo de 2 mil millones de parámetros que recibe la imagen de un documento y devuelve los campos solicitados en JSON.
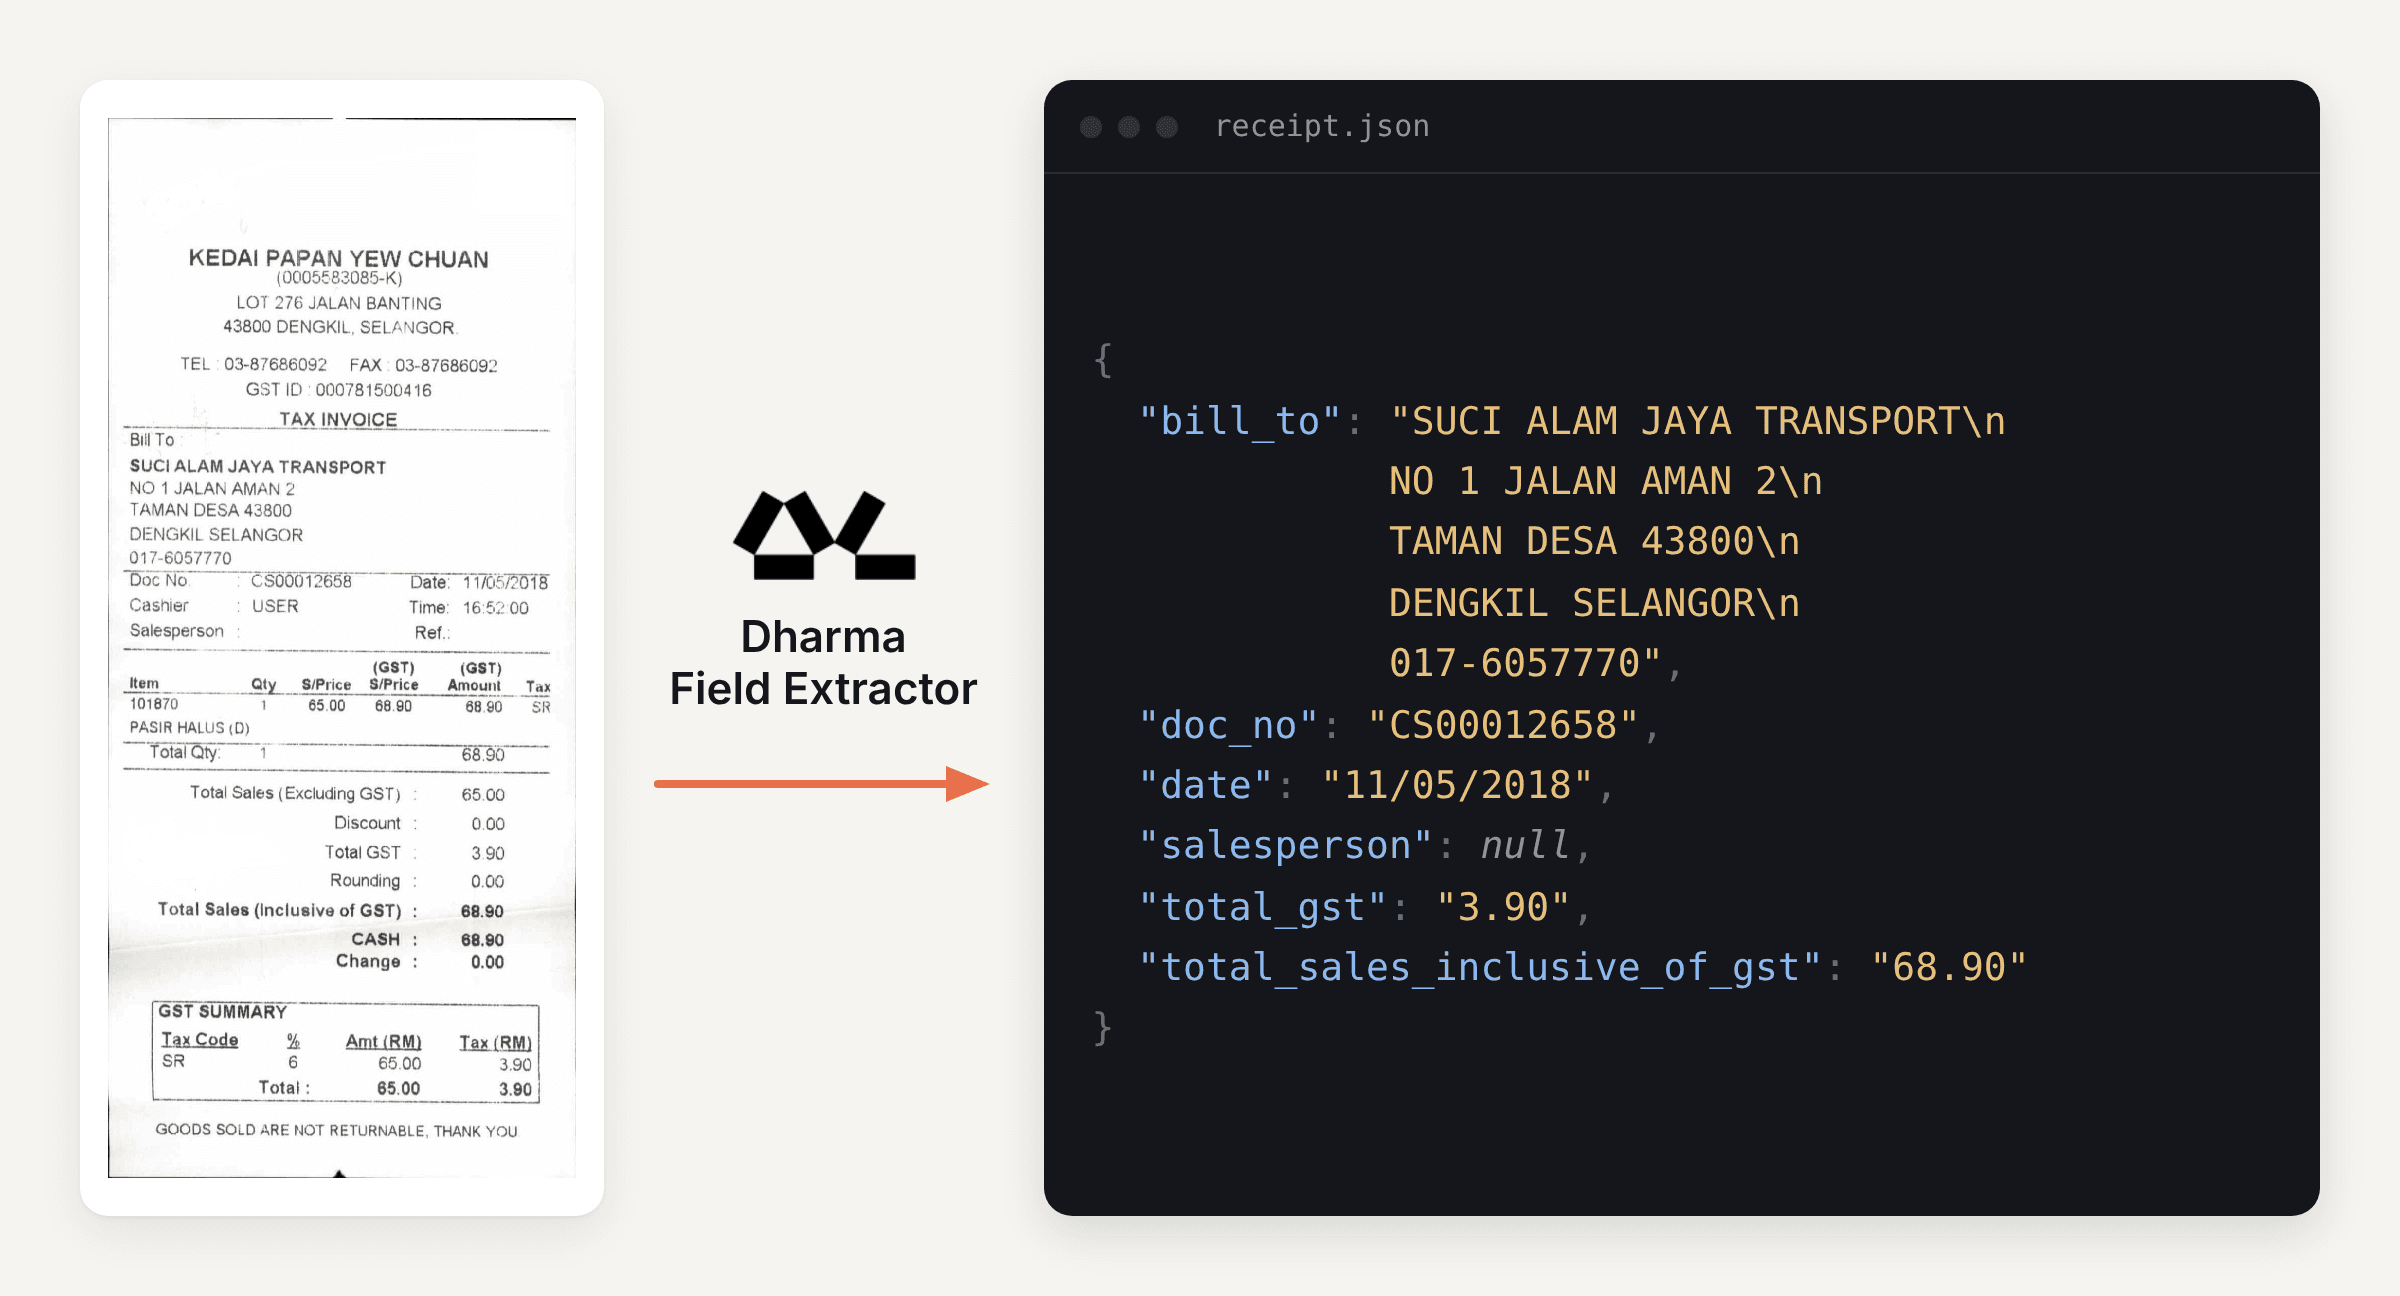
Dharma Field Extractor transforma documentos en JSON
Dharma Field Extractor transforma documentos en campos JSON. Mira el entrenamiento, la evaluación publicada y lo que todavía falta validar.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
La propuesta es entregar datos listos para un sistema, no solo transcribir la página. La publicación del equipo trae la descripción, la evaluación y los límites conocidos.
En este artículo vas a ver:
- Cómo el extractor transforma un documento en campos tipados.
- Qué hay detrás del entrenamiento y de la evaluación divulgada.
- Dónde los números ayudan y dónde no permiten generalizar.
- Qué está disponible para experimentar hoy.
Qué hace el Dharma Field Extractor con documentos
OCR es el reconocimiento del texto que aparece en una imagen. Para extraer un documento entero, eso puede bastar.
Para insertar una factura en un sistema, sin embargo, todavía es necesario descubrir qué fragmento corresponde al proveedor, a la fecha o al total.
El Dharma Field Extractor intenta resolver esa segunda etapa. La persona envía la imagen y puede pedir todos los campos que encuentre o proporcionar un esquema con los nombres y tipos que el sistema espera.
En el modo abierto, el modelo infiere los pares de etiqueta y valor a partir del texto y del layout. En el modo guiado por esquema, busca las claves indicadas, como service_provider y client_company, y respeta la estructura pedida.
La respuesta es JSON, formato de datos estructurado que puede ser leído por aplicaciones. El artículo dice que las tablas pueden volver como listas de filas y que un campo ausente recibe null, en vez de un valor inventado.
Ese contrato de salida es útil cuando la siguiente etapa ya espera nombres y tipos definidos. No elimina la necesidad de revisar documentos mal digitalizados, verificar campos críticos o decidir qué hacer cuando un valor no aparece.
Crédito de la imagen: Dharma-AI.
Cómo entrenó Dharma-AI el modelo
El equipo informa que la base es DharmaOCR-LITE v1.1, con 2 mil millones de parámetros, ya especializado en reconocimiento de documentos. Sobre ese checkpoint, entrenó un adaptador LoRA con 43.384 ejemplos para las dos formas de pedir campos.
LoRA es una técnica que ajusta un conjunto menor de parámetros adicionales, en vez de actualizar todos los pesos del modelo. El artículo también reporta el uso de ajuste supervisado y DPO, una técnica de optimización basada en preferencias.
Los ejemplos se dividieron en tres corrientes: documentos en inglés recolectados de la web, documentos brasileños reales obtenidos internamente y un conjunto menor de idiomas europeos y asiáticos.
La mezcla incluye recibos, facturas comerciales, formularios, extractos bancarios, documentos de identidad y ejemplos sintéticos. La intención declarada es cubrir layouts variados, no optimizar para un único formulario.
Qué mide la evaluación publicada
La evaluación descrita en el artículo reúne 546 documentos en tres escenarios de solicitud, totalizando 1.638 casos. Los escenarios piden todos los campos, un esquema parcial o un esquema que también contiene campos inexistentes.
La métrica combina F1 por campo, similitud de Levenshtein para comparar valores y la proporción de salidas que forman JSON válido.
Así, el resultado penaliza tanto campo ausente o cambiado como valor textual incorrecto y respuesta estructuralmente inválida.
La Dharma-AI reporta una nota de 0,834 para el Field Extractor. En la comparación del propio equipo, Claude Opus 5 quedó en 0,816 y GPT-5.6 Luna en 0,741. Esos números pertenecen al conjunto de documentos y a las configuraciones descritas en el artículo.
La Dharma-AI también estima que la ejecución local costó de 6 a 147 veces menos que las llamadas comparadas. El cálculo depende de las configuraciones y del hardware usados, por lo tanto no es una tarifa universal ni una auditoría independiente.
Dónde los resultados aún necesitan validación
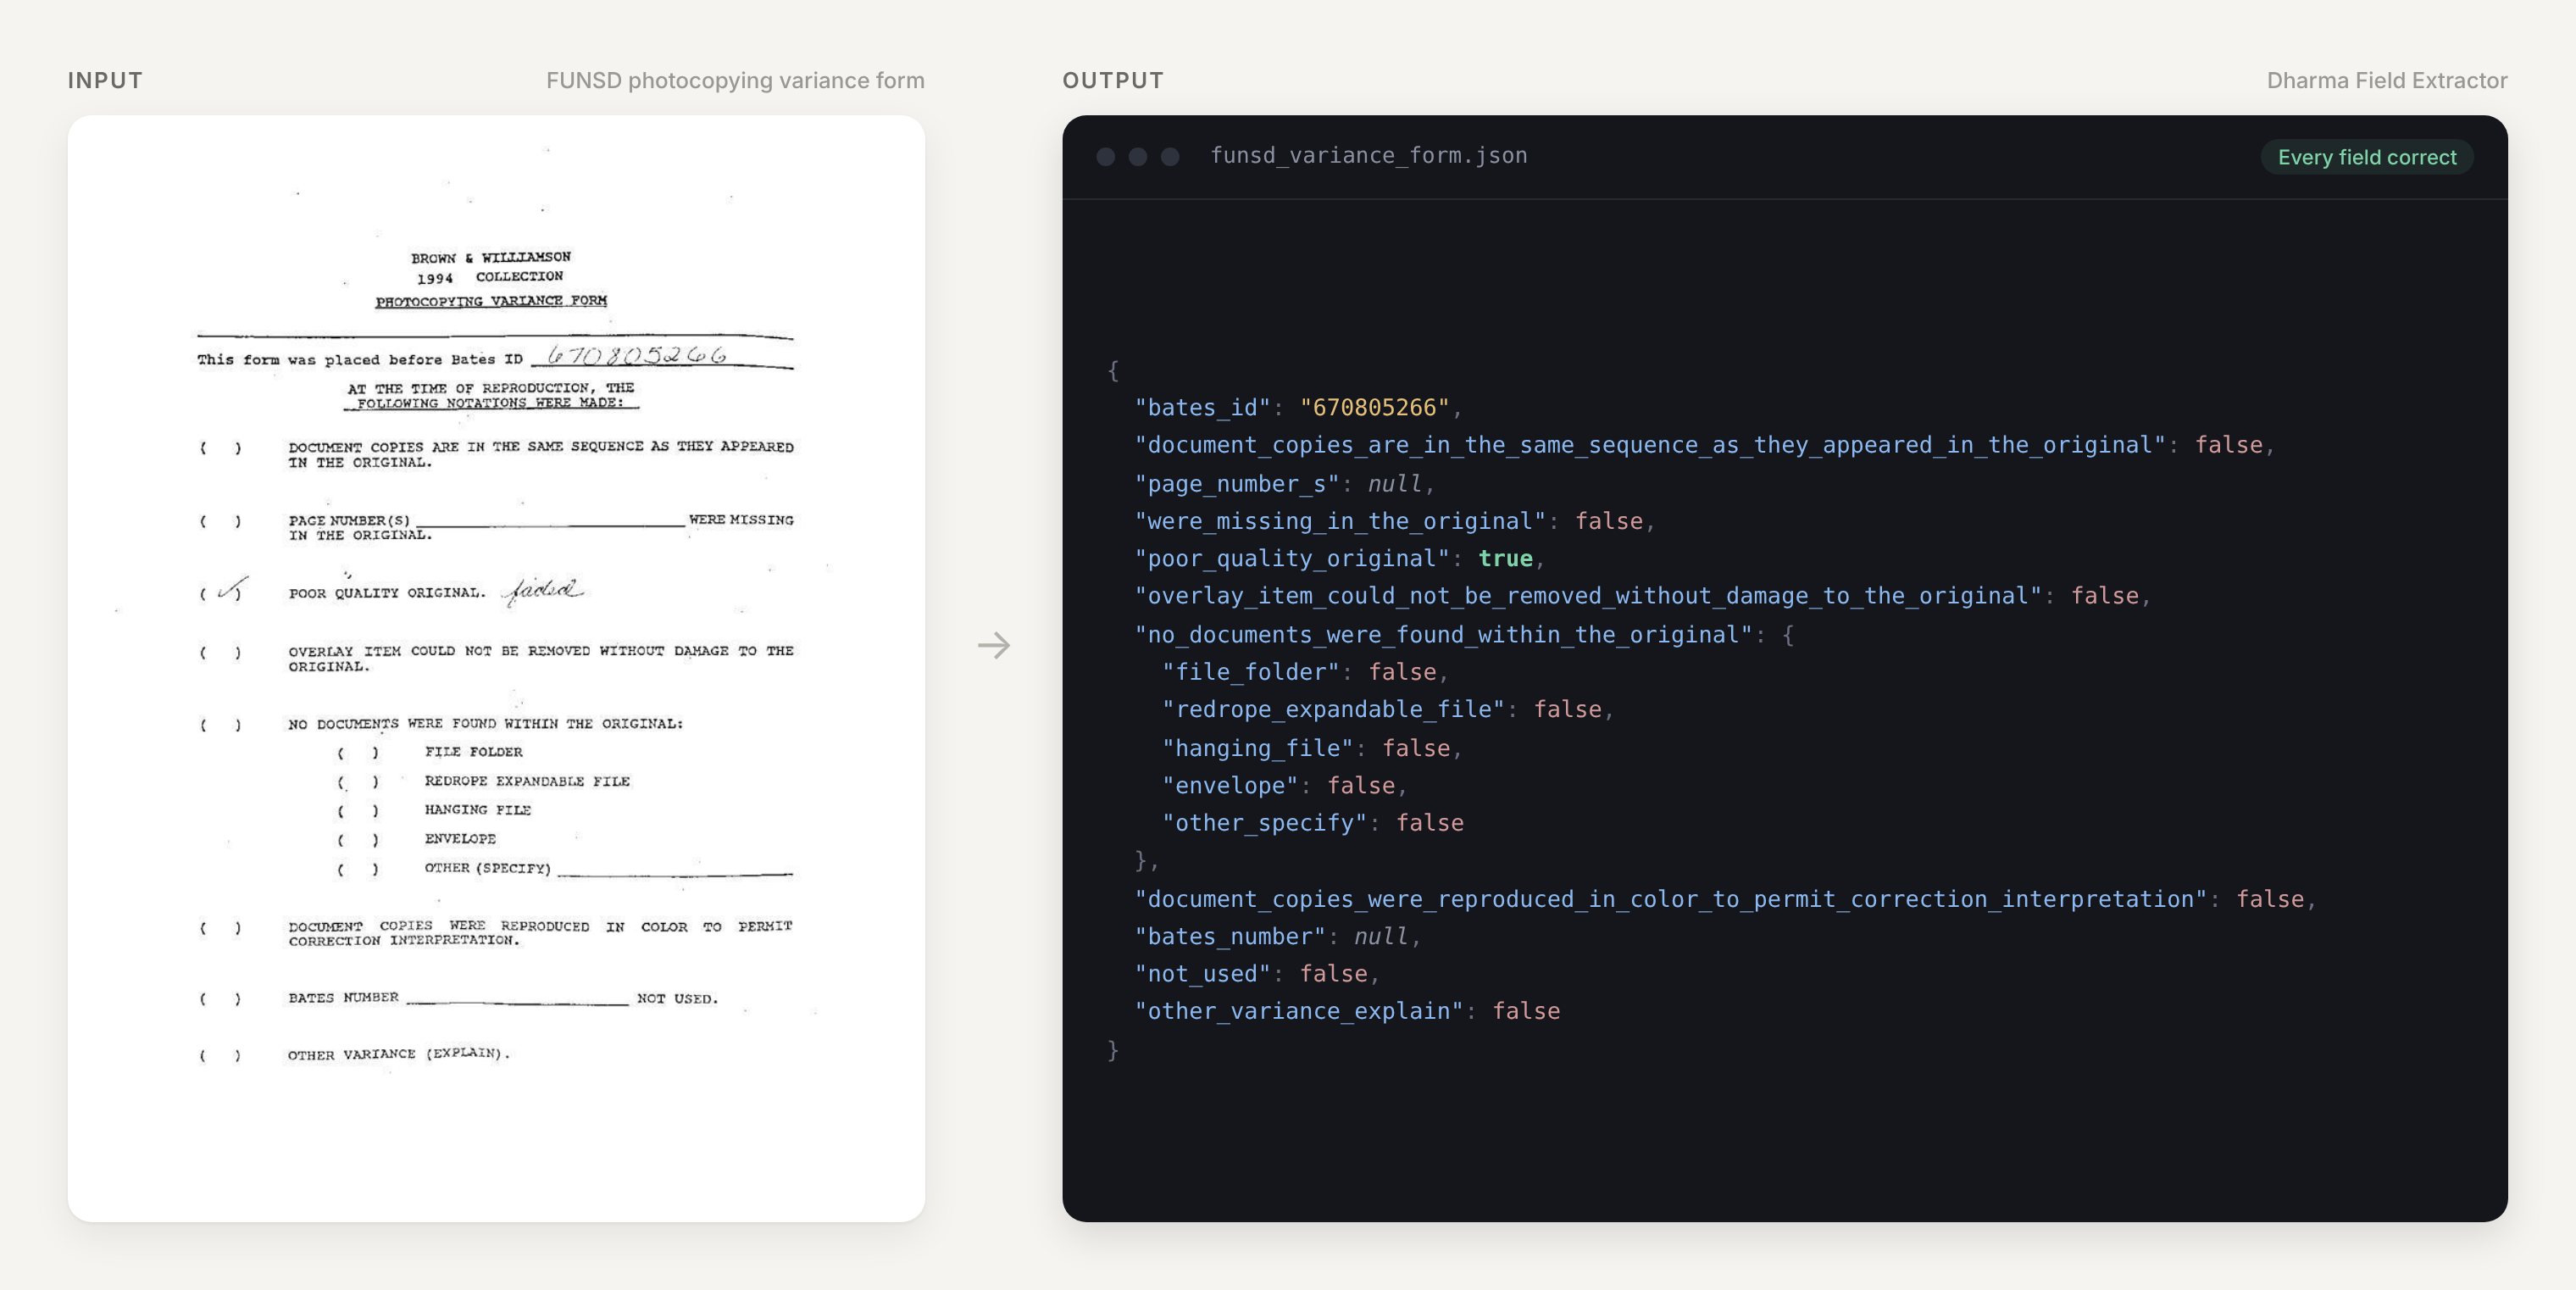
SROIE y FUNSD, dos conjuntos públicos usados en el artículo, quedaron fuera del entrenamiento. El equipo presenta un ejemplo de recibo con 18 campos y un formulario con casillas de selección para ilustrar la generalización.
Estos ejemplos son demostraciones individuales. No prueban, por sí solos, que el sistema tendrá la misma precisión en cualquier idioma, tipo de documento, calidad de digitalización o distribución de campos.
La evaluación fue publicada por los propios creadores y no es una comparación independiente. El artículo describe los datos y la métrica, pero no informa una replicación externa ni una prueba con un flujo de producción elegido por terceros.
También es importante separar el extractor del OCR tradicional. El primero busca campos específicos para alimentar sistemas; el segundo entrega el texto completo de la página.
Para la lectura integral de contratos, la salida estructurada puede no sustituir la transcripción.
La publicación vincula la propuesta a un portal de demostración. En el acceso consultado el 4 de noviembre, el portal abrió una pantalla que pide correo electrónico antes de continuar.
No creamos cuenta ni enviamos documentos, por lo que este borrador no afirma que la prueba fue ejecutada.
El texto consultado lista DharmaOCR-LITE como modelo y describe el adaptador del extractor, pero no presenta un artefacto independiente para descargar con el nombre Field Extractor.
Vale la pena confirmar la disponibilidad directamente con el equipo antes de planear una integración.
Cómo comparar el extractor con otras opciones
Comienza con documentos que tu equipo pueda usar con seguridad y escribe antes qué campos son obligatorios, cuáles pueden faltar y cómo se validarán los valores. Esto evita aceptar una salida solo porque el JSON está bien formado.
Luego compara la respuesta con una referencia revisada por personas. Separa errores de lectura, errores de asociación entre etiqueta y valor, campos ausentes y valores inventados. Una única nota agregada esconde diferencias que afectan el flujo.
Si hay un modelo general ya en uso, aplica el mismo conjunto de documentos, esquema y criterios. El anuncio de LongCat-2.5, otro modelo multimodal discutido en el blog, trata de otro perfil de uso; no es una comparación directa con el extractor.
Sigue otras novedades de IA para desarrolladores con fuente y contexto.
Si la extracción de documentos forma parte de un producto, el roteiro para criar um sistema com IA usando Codex ayuda a organizar implementación, pruebas y revisión en etapas.
Preguntas frecuentes sobre el Dharma Field Extractor
¿Qué es el Dharma Field Extractor?
Es un modelo especializado que transforma imágenes de documentos en campos estructurados en JSON, según Dharma-AI. Acepta una petición abierta o un esquema definido por el usuario.
¿Cuál es la base del Dharma Field Extractor?
Dharma-AI informa que usa DharmaOCR-LITE v1.1, con 2 mil millones de parámetros, y entrenó un adaptador LoRA con 43.384 ejemplos.
¿El extractor puede devolver campos ausentes?
En el modo guiado por esquema, la publicación dice que un campo que no aparece en el documento recibe null. El modelo no debe inventar un valor para completar la clave.
¿La evaluación del Dharma Field Extractor fue independiente?
No. Los resultados fueron divulgados por la propia Dharma-AI en una evaluación de 546 documentos y 1.638 casos, incluyendo SROIE y FUNSD fuera del entrenamiento.
¿Es posible probar el Dharma Field Extractor sin cuenta?
La publicación enlaza a un portal de demostración, pero el acceso consultado el 4 de noviembre abrió una pantalla que pide correo electrónico. No creamos cuenta ni enviamos documentos.
El Dharma Field Extractor atiende a una tarea bien delimitada
El anuncio presenta un camino para convertir imágenes de documentos en campos JSON sin pedir que un modelo general resuelva todo por prompt.
La ventaja alegada es mayor adherencia a un esquema específico, pero la prueba disponible sigue siendo la evaluación divulgada por la propia Dharma-AI.
Para una decisión de producto, el próximo paso es probar con documentos representativos, revisar los campos críticos y medir errores que tengan consecuencia en el proceso. No trates la puntuación publicada como garantía para otro conjunto de datos.
Del borrador al producto listo: divide el trabajo entre agentes especialistas y acompaña cada etapa en bridgecode.
Fuente: Dharma-AI
Tags:#Dharma Field Extractor#Dharma-AI#OCR#extração de documentos#JSON
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Newsletter
GitHub reconstruye el almacenamiento Git para agentes
GitHub anunció la nueva arquitectura de almacenamiento Git, Project Rubicon, capaz de recibir miles de escrituras por segundo en un solo repositorio.
6 min

Newsletter
Palette: el modelo de IBM aprende a crear slides con tu estilo
IBM y Hugging Face publicaron Palette, un modelo de 20 mil millones de parámetros que genera presentaciones en código entrenado para seguir el IBM Design Language.
7 min

Newsletter
OpenAI crea un estándar para infraestructura de IA responsable
OpenAI publicó un estándar para infraestructura de IA responsable con compromisos sobre energía, agua, fuerza laboral y comunidades.
5 min