
NVIDIA Auto Ontology es un repositorio abierto que ayuda a los agentes a interpretar datos empresariales antes de responder preguntas sobre métricas, clientes u operaciones. La propuesta es construir una capa semántica, es decir, una descripción estructurada de lo que significan los datos y de cómo se relacionan sus entidades.

Dicas6 min
5 consejos para dar contexto a agentes con NVIDIA Auto Ontology
Conoce NVIDIA Auto Ontology, un repositorio Apache 2.0 para dar contexto semántico a agentes y los cuidados de seguridad antes de adoptarlo.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
La versión consultada del repositorio está bajo Apache 2.0. La actividad más reciente en la rama principal fue un commit del 5 de noviembre de 2026 que registra una actualización a 1.2.0. Esto es un cambio en el código, no una etiqueta de release publicada.
En este artículo verás:
- El problema que intenta resolver Auto Ontology
- Cinco puntos para evaluar el repositorio
- Los límites de seguridad y mantenimiento
- Cuándo tiene sentido la capa semántica
Qué hace NVIDIA Auto Ontology
Los agentes conectados a bases pueden generar una consulta SQL correcta en sintaxis y aun así elegir la métrica equivocada. El problema aparece cuando dos sistemas usan nombres distintos para la misma idea o cuando una columna técnica no explica el significado de negocio.
Auto Ontology intenta reducir esa ambigüedad. Según el README oficial del repositorio, genera ontologías empresariales a partir de metadatos, conecta modelos semánticos existentes y organiza conceptos, entidades, métricas y relaciones para uso de los agentes.
La documentación presenta cinco capacidades: descubrir la estructura, fundamentar respuestas en definiciones de negocio, validar consultas y linaje, exponer el contexto por MCP, CLI o API e incorporar correcciones certificadas al catálogo.
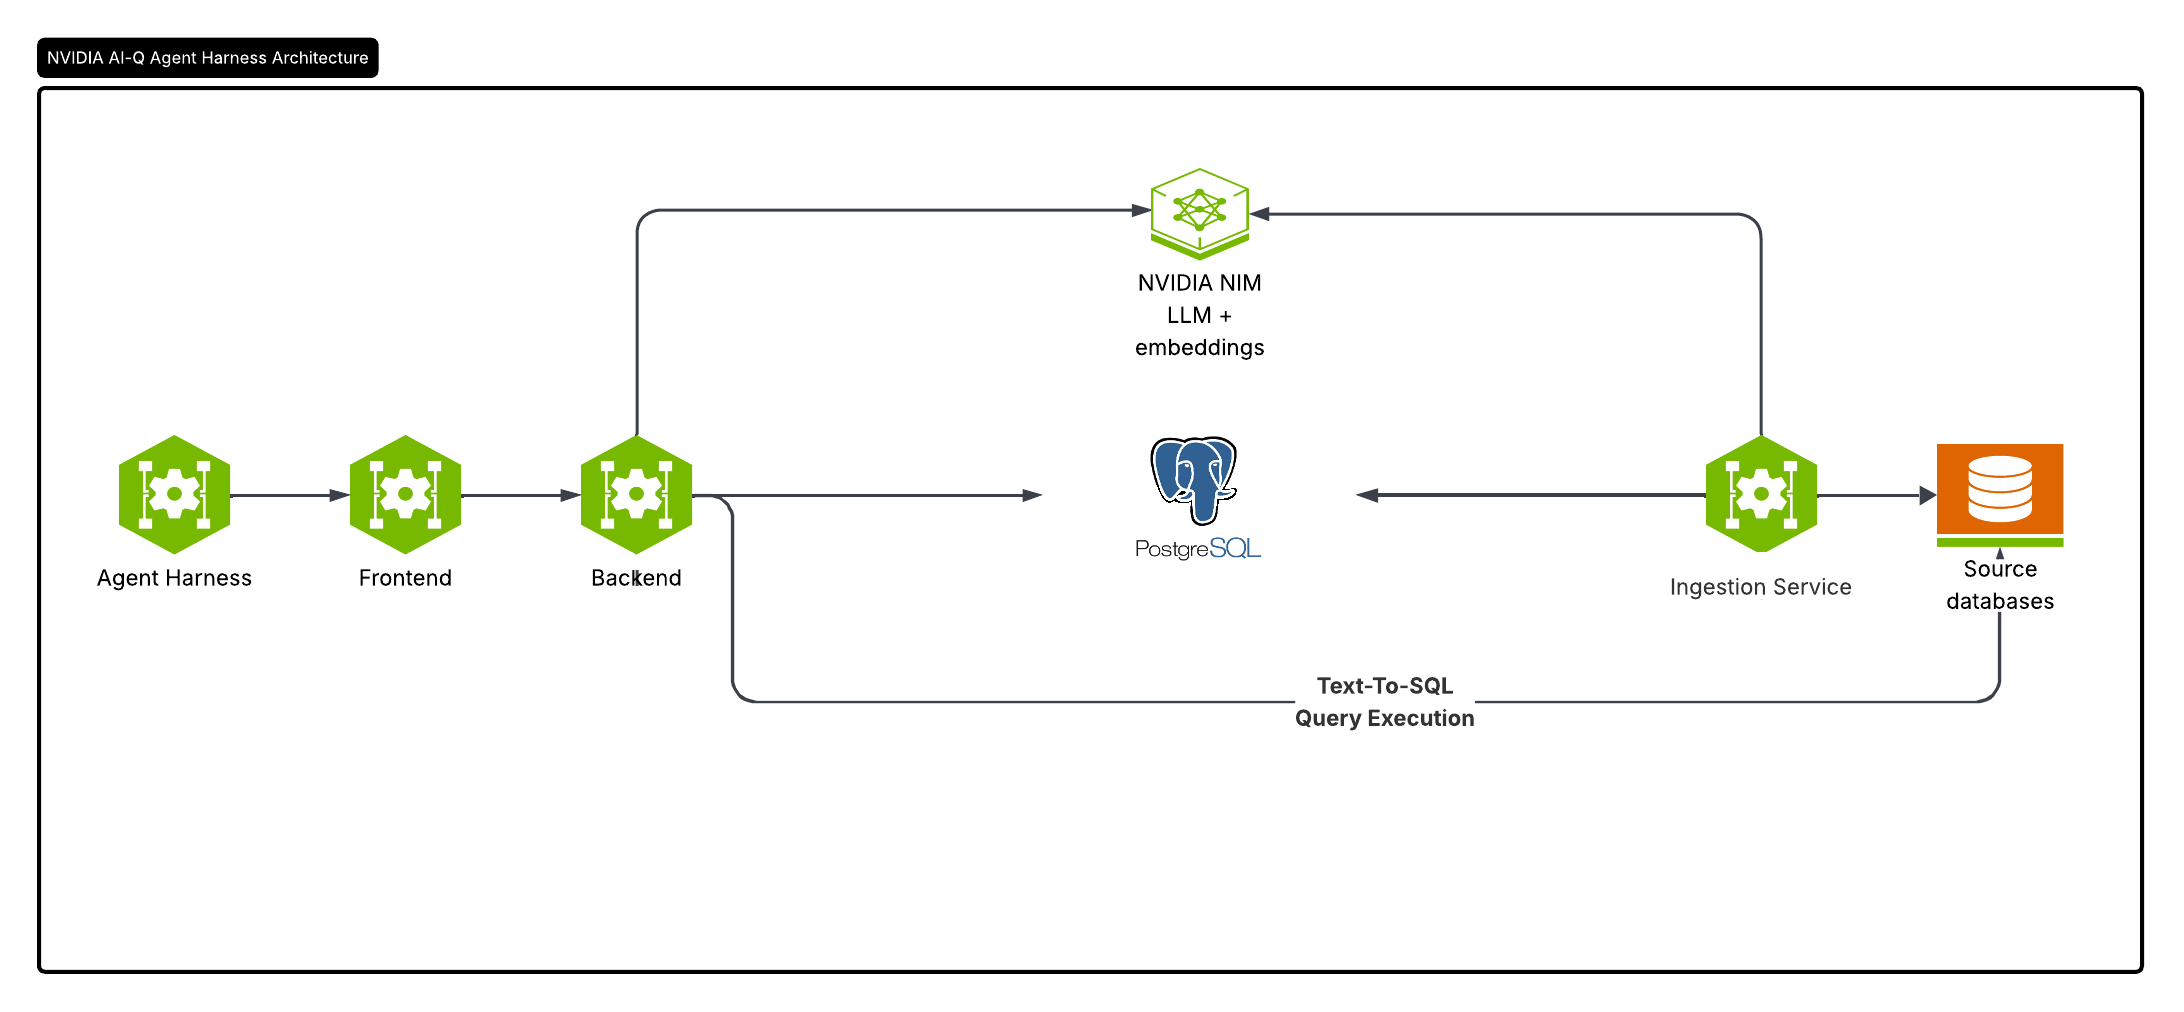
El diagrama oficial muestra la interfaz, el backend, el servicio de ingestión, Postgres, NVIDIA NIM y las bases de origen. Ayuda a entender que el proyecto no es solo un prompt para conversar con datos, sino un conjunto de servicios con responsabilidades distintas.
Cinco consejos para evaluar el repositorio
Consejo 1: elige una pregunta de negocio concreta
Comienza con una pregunta que hoy exige conocer tablas y definiciones internas, por ejemplo, qué producto tuvo más ingresos en un período. El objetivo inicial es verificar si la capa encuentra las entidades y métricas correctas, no probar todas las bases de datos de la empresa.
El README muestra una demostración con la base de ejemplo Wide World Importers. Trata ese escenario como una muestra documentada, no como prueba de que el proyecto ya entiende tu catálogo o las reglas de tu equipo.
Consejo 2: separa semántica de contexto de código
Auto Ontology trabaja con metadatos empresariales, definiciones de métricas y relaciones entre datos. Esto es diferente de resumir archivos de un repositorio o reducir la salida de un agente de programación.
Para comparar los problemas, consulta la guía de Context Mode para filtrar salidas largas de agentes. Las dos herramientas tratan el contexto, pero en capas diferentes.
Consejo 3: revisa cómo consultas e ingestión usan las conexiones
La documentación indica que la interfaz y la variable CONNECTION_STRINGS pueden usarse para registrar fuentes. Las rutas de consulta e ingestión priorizan estas opciones de forma diferente, por lo que una configuración que funciona para responder preguntas puede no ser la misma que alimenta el catálogo.
La conexión por la interfaz permite listas de esquemas y reglas de inclusión o exclusión de tablas. La variable CONNECTION_STRINGS no aplica esos filtros. Haz el inventario de las fuentes y restringe el acceso antes de conectar datos reales.
Consejo 4: entiende qué puede y qué no puede hacer el servidor MCP
El servidor MCP expone herramientas para preguntar sobre datos, verificar si una pregunta puede responderse y consultar términos del glosario. La documentación afirma que no ofrece una herramienta para navegar libremente por bases de datos, esquemas o columnas crudas.
Esto acerca la consulta a los conceptos certificados por el catálogo. Para entender otra integración de herramientas con agentes, lee también la guía de mcp-server-git para CLIs de IA.
Consejo 5: valida las respuestas contra definiciones y linaje
Antes de considerar una respuesta útil, revisa el SQL generado, las filas retornadas y el origen de la métrica. El proyecto describe validación contra definiciones certificadas y linaje, pero el equipo aún necesita revisar si el catálogo representa correctamente sus reglas.
Usa preguntas con respuesta conocida e incluye casos ambiguos. Si la definición de ingresos, cliente activo o período fiscal varía entre áreas, registra esa divergencia antes de pedirle al agente una respuesta única.
Límites de seguridad y mantenimiento de NVIDIA Auto Ontology
La licencia principal es Apache 2.0, pero eso no sustituye la revisión de los avisos de terceros listados por el proyecto. La página pública de advisories consultada no mostraba avisos publicados el 6 de noviembre de 2026. Esto no es una auditoría de seguridad.
Hay una salvedad operacional concreta: la documentación dice que, sin configurar HashiCorp Vault, el objeto de conexión completo, incluida la contraseña, se guarda sin cifrado en la fila del catálogo de Postgres. Vault viene desactivado por defecto y solo entra en uso cuando los cuatro parámetros obligatorios están configurados.
La documentación también lista servicios separados para interfaz, backend e ingestión. Restringe los servicios a la red necesaria, no expongas puertos de administración a internet y usa credenciales de prueba mientras validas el flujo.
El mantenedor informa que el proyecto no está aceptando contribuciones externas. NVIDIA mantiene un procedimiento privado para reportar vulnerabilidades. Considera este modelo de mantenimiento al evaluar dependencias, correcciones y el proceso interno de adopción.
Preguntas frecuentes sobre el NVIDIA Auto Ontology
¿Qué es NVIDIA Auto Ontology?
Es un repositorio abierto de NVIDIA que construye una capa semántica sobre datos empresariales para ayudar a agentes a interpretar métricas, entidades y relaciones.
¿Cómo proporciona contexto Auto Ontology a los agentes?
El proyecto organiza definiciones y relaciones de datos y las expone a agentes por MCP, CLI y API. La respuesta puede incluir la consulta SQL y la procedencia.
¿Cuál es la licencia de NVIDIA Auto Ontology?
El repositorio indica Apache License 2.0. El README también lista avisos para componentes de terceros.
¿Almacena Auto Ontology credenciales en Postgres?
Sin Vault, la documentación dice que el objeto de conexión completo, incluida la contraseña, se almacena sin cifrado en la fila del catálogo de Postgres. Con Vault totalmente configurado, las credenciales quedan en Vault.
¿Está activo el repositorio NVIDIA Auto Ontology?
La rama principal recibió un commit el 5 de noviembre de 2026 que registra una actualización a 1.2.0. El commit no es una etiqueta de release.
Cuándo ayuda Auto Ontology
El repositorio puede ser interesante para equipos que necesitan dar a varios agentes una definición consistente de métricas, tablas y relaciones empresariales. Complementa los modelos semánticos que la empresa ya mantiene, en lugar de exigir que cada agente descubra por sí mismo el significado de los datos.
No es una solución de orquestación de squads ni sustituye la revisión de consultas, los permisos de base de datos o la gobernanza. La adopción depende de la calidad del catálogo y de una configuración cuidadosa de las conexiones y credenciales.
¿Tienes un proyecto que necesita explicar sus propios indicadores? Divide descubrimiento, consulta, validación e implementación entre agentes y arma tu squad de IA en bridgecode.
Fuente: NVIDIA
Tags:#NVIDIA Auto Ontology#ontologia semântica#agentes de IA#MCP#segurança de dados
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados

Dicas
Cómo probar agentes de IA en operaciones de nube con CloudOpsBench
CloudOpsBench publica 45 tareas de operación en la nube para probar tu agente de IA. Mira cómo clonar, validar y ejecutar contra un emulador o AWS real.
6 min
Dicas
Kilo Code: agente de código de código abierto para VS Code y CLI
Kilo Code es un agente de código de código abierto para VS Code, JetBrains y CLI, con más de 500 modelos y precio directo del proveedor.
6 min
Dicas
Hy4 de Tencent: 1M de contexto, visión y tool calling
Hy4 de Tencent trae 1 millón de tokens de contexto, visión y tool calling nativo para agentes de código y tareas de larga duración.
5 min