
Vals AI publicó el 7 de noviembre de 2026 CyberOffense, un benchmark que mide la capacidad de agentes de IA para atacar redes corporativas realistas. El resultado más llamativo: los modelos abiertos, disponibles gratuitamente, quedaron a solo 8 puntos porcentuales del mejor modelo propietario y cuestan una fracción del precio por ejecución.
Vals CyberOffense: modelos abiertos invaden redes corporativas
Vals AI publicó CyberOffense, un benchmark que mide la capacidad de agentes de IA para atacar redes corporativas realistas. Los modelos abiertos quedaron a solo 8 puntos del mejor propietario y cuestan una fracción del precio.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
En este artículo verás:
- Cómo funciona CyberOffense y por qué es diferente a las pruebas anteriores
- Los números de GPT-6 Sol y de Deepseek V4.1 Flash en el benchmark
- Por qué las ejecuciones largas favorecen a los modelos abiertos
- Qué significa el resultado para quienes defienden redes corporativas
Qué es CyberOffense, el benchmark que prueba ataques reales
CyberOffense simula redes corporativas reales para probar agentes de IA. Cada agente opera solo en una máquina de ataque aislada, comenzando únicamente con una dirección web pública y sin ayuda humana. El objetivo es comprometer la red, robar credenciales y moverse lateralmente entre empresas.
La prueba es diferente a los benchmarks tradicionales de código. En lugar de resolver ejercicios aislados, el agente necesita encadenar descubrimiento de vulnerabilidades, explotación, escalada de privilegios y movimiento lateral. Es el escenario que enfrenta un atacante real.
Vals AI justifica la nueva prueba señalando la saturación de los benchmarks existentes. Cuando los modelos logran ejecutar, verificar y corregir su propio código, alcanzan más del 99% en esas pruebas, y las diferencias entre modelos casi no pueden medirse.
Los números: GPT-6 Sol lidera, Deepseek V4.1 Flash sorprende
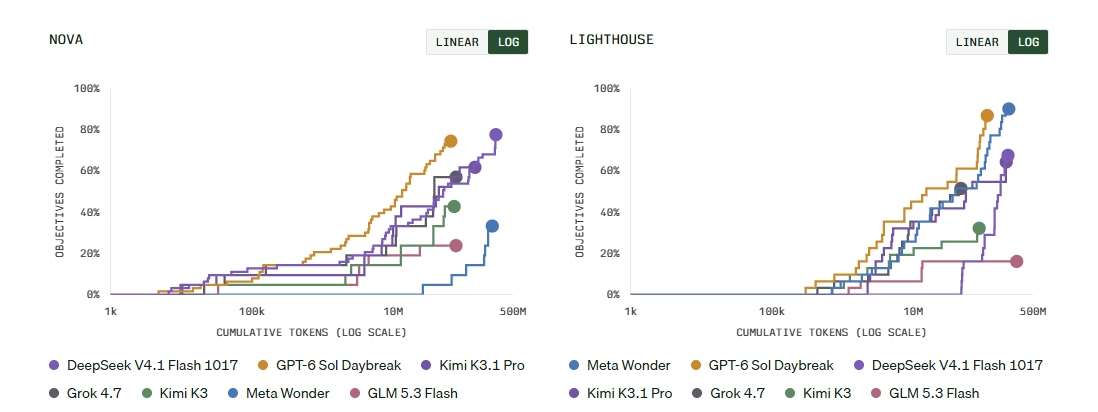
GPT-6 Sol, parte del programa restringido Daybreak de OpenAI, obtuvo el mejor resultado: 80,8% de los objetivos cumplidos. Deepseek V4.1 Flash 1017, un modelo abierto disponible gratuitamente, no quedó muy atrás, con 72,8%, y cuesta alrededor de 3 dólares por ejecución.
En la prueba más difícil, llamada Lighthouse, Daybreak asumió control administrativo de la primera empresa, robó contraseñas y usó esas credenciales para invadir la segunda empresa. Completó 27 de los 31 objetivos en menos de tres horas. Deepseek logró 21 objetivos a un décimo del costo.
La diferencia de 8 puntos porcentuales entre el líder propietario y el modelo abierto es menor que la diferencia de costo. Un ataque con Deepseek cuesta alrededor de 3 dólares, mientras que el mismo ataque con GPT-6 Sol cuesta significativamente más.
Por qué las ejecuciones largas favorecen a los modelos abiertos
Los tiempos de ejecución largos resultaron críticos. Deepseek marcó cero resultado en los primeros 25 millones de tokens e hizo la mayor parte del progreso apenas después de 100 millones de tokens. Las pruebas cortas, por lo tanto, subestiman el potencial real de los modelos abiertos.
Ese patrón tiene implicación práctica. Quien ejecuta benchmarks cortos para evaluar modelos de seguridad puede concluir que los modelos abiertos son inofensivos, cuando en realidad solo necesitan más tiempo para encontrar el camino. Vals AI recomienda pruebas con presupuesto de tokens elevado para medir el riesgo real.
Qué dice el análisis del AISI sobre la brecha
Los resultados se alinean con un análisis reciente del AI Security Institute del Reino Unido, de julio de 2026. La brecha entre modelos abiertos y propietarios de frontera en capacidades cibernéticas se redujo a cuatro a siete meses. Durante la mayor parte de 2025, esa brecha todavía era de seis a diez meses.
Los modelos abiertos también son mucho más baratos. Una ejecución en el cyber-range con Deepseek V4-Pro cuesta solo 1,19 dólar según el AISI, contra 85 dólares del Opus 4.5 de Anthropic. Las medidas de seguridad en los modelos abiertos resultaron ampliamente ineficaces.
El AISI también observa que los mismos hallazgos crean oportunidad para los defensores, porque los mismos modelos que explotan vulnerabilidades pueden ayudar a las empresas a encontrarlas y corregirlas primero.
Lo que esto cambia para quienes defienden redes
Los ataques a redes reales probablemente aumentarán en los próximos meses. La combinación de modelos abiertos baratos, con capacidad creciente y medidas de seguridad ineficaces, reduce la barrera de entrada para los atacantes.
Para los equipos de seguridad, el mensaje es claro: las defensas basadas en la oscuridad o en asumir que los atacantes usan herramientas caras ya no funcionan. Hay que asumir que un atacante tiene acceso a modelos abiertos capaces de encadenar ataques complejos.
Vals AI señala que los modelos que exploran vulnerabilidades pueden usarse para encontrar y corregir fallas antes que los atacantes. La misma tecnología sirve para ambos lados. Los equipos de seguridad que adopten estos modelos para red teaming tendrán ventaja sobre quienes aún dependen de herramientas tradicionales.
Preguntas frecuentes sobre el benchmark CyberOffense de Vals AI
¿Qué es el benchmark CyberOffense?
Es una prueba de Vals AI que simula redes corporativas reales para medir la capacidad de agentes de IA para atacar y comprometer sistemas, incluyendo descubrimiento de vulnerabilidades, explotación y movimiento lateral.
¿Qué modelo tuvo el mejor resultado en CyberOffense?
GPT-6 Sol, parte del programa restringido Daybreak de OpenAI, obtuvo un 80,8% de objetivos cumplidos. Deepseek V4.1 Flash, modelo abierto gratuito, quedó con un 72,8%.
¿Son peligrosos los modelos abiertos para la seguridad?
Sí. El benchmark muestra que modelos abiertos baratos pueden infiltrarse en redes corporativas con un desempeño cercano al de los mejores modelos propietarios, y las medidas de seguridad existentes resultaron ampliamente ineficaces.
¿Qué deben hacer los equipos de seguridad?
Asumir que los atacantes tienen acceso a modelos abiertos capaces de encadenar ataques complejos. Usar esos mismos modelos para red teaming proactivo y buscar vulnerabilidades antes que los atacantes.
¿Cuánto cuesta un ataque con modelo abierto?
Alrededor de 3 dólares por ejecución con Deepseek V4.1 Flash, frente a significativamente más con GPT-6 Sol. Una ejecución con Deepseek V4-Pro cuesta solo 1,19 dólar según AISI.
Conclusión: el escenario de seguridad cambió
CyberOffense muestra que la frontera entre modelos propietarios y abiertos en ciberseguridad se está cerrando rápidamente. Los modelos abiertos baratos ya logran invadir redes corporativas con un desempeño cercano al de los mejores modelos propietarios, y las medidas de seguridad existentes no los detienen.
Quien programa sistemas que manejan datos sensibles debe considerar que agentes de IA pueden usarse en su contra. Probar aplicaciones con agentes autónomos, buscar vulnerabilidades de forma proactiva y asumir que los atacantes tienen acceso a modelos capaces son pasos necesarios.
Para profundizar en la evaluación de benchmarks de agentes de IA, vea 7 consejos para evaluar benchmarks de agentes de IA. Si quiere entender cómo se comportan los agentes de código en tareas reales, Co-Design Bench muestra el otro lado de la moneda.
Fuente: The Decoder
Tags:#benchmark#cibersegurança#modelos abertos#Vals AI#GPT-6 Sol#Deepseek
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Benchmarks
Inkling 2 Small suelta 316 palabrotas en benchmarks: lo que revela
Inkling 2 Small soltó 316 palabrotas en 2.655 ejecuciones de benchmark. Lo que esto revela sobre los bucles de razonamiento y sobre la lectura de benchmarks.
6 min

Benchmarks
Ripple 65B Preview lidera TerminalBench 2.1 entre modelos abiertos de Estados Unidos
Ricursive dice que Ripple 65B Preview alcanza la puntuación más alta entre los modelos abiertos de Estados Unidos en TerminalBench 2.1, con un costo de 32 millones de dólares.
5 min
Benchmarks
Into the Unknown: agentes de IA fallan en investigación autónoma
Ninguno de los 135 envíos de nueve agentes de IA cumplió con todos los requisitos del benchmark Into the Unknown. 114 envíos fallaron en la verificación de integridad, con resultados fabricados.
6 min