
El 5 de noviembre de 2026, Hugging Face publicó un nuevo informe de Gradium sobre Phonon, modelo de texto a voz que corre en dispositivo.

Phonon TTS lidera prueba de latencia de voz local
Hugging Face publicó el 5 de noviembre los resultados de Phonon en el Open TTS Leaderboard, con 28 ms hasta el primer audio en la prueba de streaming en CPU.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
El artículo muestra resultados en Open TTS Leaderboard, un marcador público para comparar sistemas de voz.
El destaque fue el tiempo hasta el primer audio, llamado TTFA.
En la prueba de streaming en CPU, Phonon 31m apareció con 28 ms en el percentil 95. Phonon 40m marcó 38 ms y Pocket TTS, 165 ms.
El resultado describe una métrica y una configuración específicas, no toda la calidad de voz.
En este artículo vas a ver:
- Cómo el Open TTS Leaderboard compara modelos de voz.
- Qué significa el resultado de 28 ms de Phonon.
- Cuáles son los límites del marcador y del informe de Gradium.
- Cómo probar Phonon y qué revisar antes de adoptarlo.
Qué mide el Open TTS Leaderboard
Texto a voz, o TTS, transforma texto escrito en audio hablado. Esto puede alimentar asistentes, lectores de pantalla, juegos e interfaces que necesitan hablar sin depender de una llamada a un servidor remoto.
El Open TTS Leaderboard mide dimensiones diferentes. WER estima cuántas palabras fueron reconocidas de forma incorrecta en la transcripción del audio generado.
RTFx indica la relación entre la duración producida y el tiempo de procesamiento. TTFA mide cuánto demora hasta llegar el primer fragmento de audio.
El marcador también puede presentar UTMOS para naturalidad en inglés, KOMOS en coreano y SIM para semejanza de voz cuando hay clonación.
Esos números no significan lo mismo: calidad de pronunciación, velocidad, naturalidad y semejanza son preguntas distintas.
La versión más reciente del espacio público que consulté está marcada como 3 de noviembre de 2026.
Permite seleccionar conjuntos como Seed TTS, CV3 Eval y MiniMax, idiomas y modo de clonación. Solo entran en el ranking agregado los modelos con resultados para todos los idiomas y conjuntos seleccionados.
La página de metodología del Open TTS Leaderboard de Hugging Face informa que las evaluaciones de streaming usan lote de una muestra.
Para la medición en inglés con CV3 Eval, el flujo hace tres calentamientos y mide las 497 muestras restantes.
Phonon llegó a 28 ms en la prueba de streaming
TTFA p95 es el tiempo de espera observado en el punto en que el 95% de las muestras quedan por debajo de ese valor. La métrica ayuda a observar la cola más lenta, y no solo una respuesta típica. En el ranking de streaming, cuanto menor el TTFA, mejor.
En el gráfico publicado por Gradium, Phonon 31m en inglés marcó 28 ms en el p95 de la medición en CPU. Phonon 40m en inglés quedó en 38 ms. Pocket TTS aparece en 165 ms en el mismo gráfico.
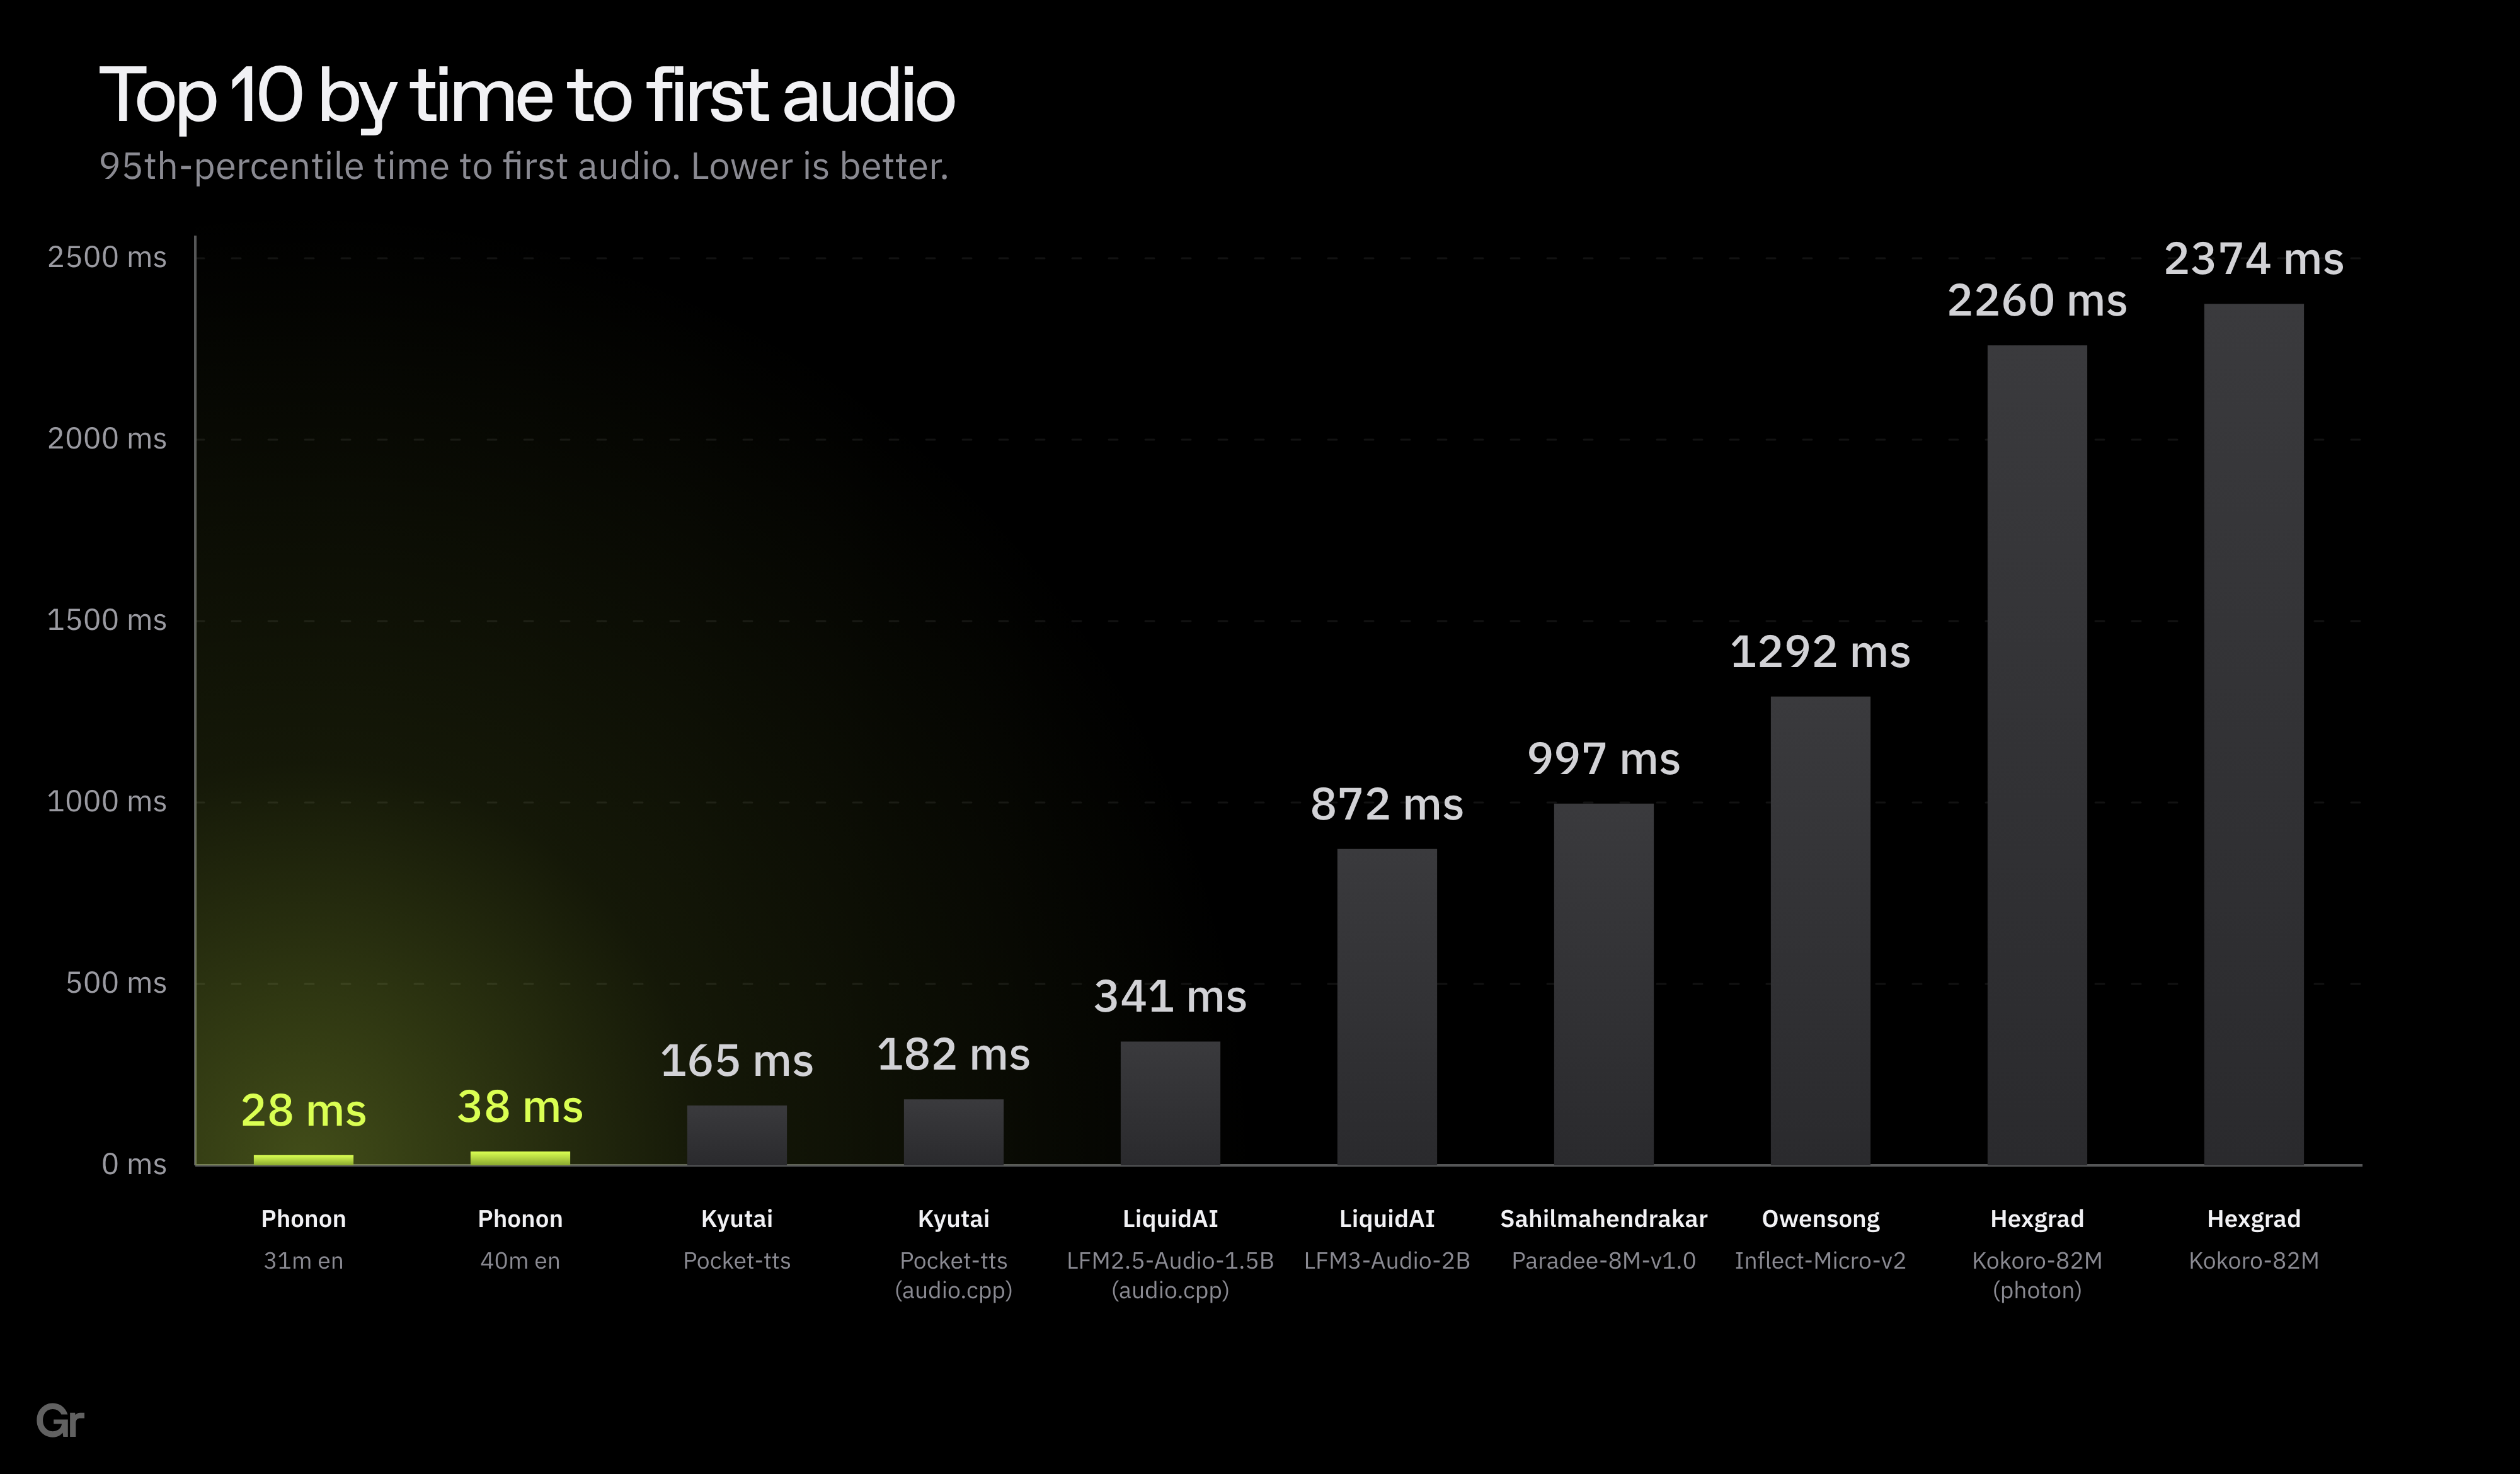
La diferencia sugiere que el audio de Phonon comienza a llegar más temprano en esta configuración. No prueba que una conversación completa tenga siempre menor latencia, porque red, hardware, tamaño del texto e integración también afectan la experiencia.
El informe de Gradium también afirma que Phonon quedó en primer lugar en inteligibilidad en alemán y español y en el grupo de los tres mejores en cada idioma que evaluó.
Como el artículo está escrito por la propia fabricante, trata estos resultados como datos divulgados por Gradium, no como una evaluación independiente.
El equipo dijo que el modelo superó 200 mil descargas en las primeras dos semanas. Las descargas miden adopción de la comunidad, no calidad de audio ni precisión del marcador. Esta distinción evita transformar popularidad en resultado técnico.
¿Qué es Phonon y qué modelos están disponibles
Phonon es una familia de modelos de TTS desarrollada por Gradium. La propuesta es generar voz localmente, sin enviar cada frase a un servidor.
El proyecto describe pesos de aproximadamente 65 MB y 75 MB, con versiones para inglés, francés, alemán, español y portugués.
La versión Phonon 31m en inglés usa licencia Apache 2.0, según la tarjeta oficial del modelo.
Las versiones multilingües de 40m usan CC BY NC 4.0, según el artículo de Gradium. Revisa la licencia exacta del checkpoint elegido antes de incorporar pesos a un producto.
Este detalle cambia la decisión de ingeniería. Un modelo pequeño en inglés con licencia permisiva no significa que todas las versiones de la familia tengan los mismos términos de uso. Idiomas, checkpoint y licencia deben evaluarse juntos.
Phonon sigue el linaje de Pocket TTS y usa flow matching para generar audio. En términos simples, el modelo predice representaciones de audio en etapas, en lugar de consultar una API de síntesis remota para cada frase.
La implementación de referencia también aparece en Transformers.
Para comparar el papel de la voz y la conclusión de tareas, vea el análisis de agentes de habla en Speech Agent Arena.
Para contexto sobre infraestructura de audio en tiempo real, lea también el anuncio de Deepgram sobre Daily y Pipecat.
Cómo probar Phonon hoy
La demostración oficial de Phonon en Hugging Face permite escuchar el modelo antes de integrarlo.
El artículo también señala el runtime ptts y la integración con Transformers para quien quiera elegir una plataforma de ejecución.
Comienza con frases que representen tu producto. Incluye números, fechas, direcciones, nombres propios y siglas, pues un habla fluida puede pronunciar estos elementos de forma incorrecta.
Luego, prueba en el hardware y el idioma que pretendes ofrecer. Registra el tiempo hasta el primer audio, la naturalidad percibida, errores de pronunciación y consumo de memoria.
Revisa también el comportamiento sin conexión. Los resultados de Gradium no sustituyen esta validación en el entorno real.
Si la aplicación usa una voz clonada, confirma autorización del locutor e informa a las personas cuando la habla sintética sea relevante.
La propia tarjeta del modelo recomienda no usar Phonon para hacerse pasar por una persona real o engañar a quien escucha.
Preguntas frecuentes sobre el Phonon TTS de Gradium
¿Qué es Phonon TTS?
Phonon es una familia de modelos de texto a voz de Gradium que puede generar audio localmente, sin enviar cada frase a un servidor. La familia incluye modelos en cinco idiomas, según el artículo de la empresa.
¿Qué modelo de Phonon inició el habla más rápido en la prueba divulgada?
Phonon 31m en inglés marcó 28 ms en el percentil 95 del tiempo hasta el primer audio en la medición de streaming en CPU divulgada por Gradium. Phonon 40m marcó 38 ms en el mismo gráfico.
¿Qué significa TTFA p95?
TTFA es el tiempo hasta el primer fragmento de audio. El p95 indica el valor por debajo del cual quedaron el 95% de las muestras de la prueba, por eso ayuda a observar los casos más lentos.
¿El resultado prueba que Phonon es el mejor TTS en cualquier uso?
No. El número de 28 ms describe una medición específica de streaming en CPU. El ranking separa latencia, inteligibilidad, naturalidad y similitud de voz, y el reporte de resultados es de Gradium misma.
¿Puedo usar cualquier modelo de Phonon comercialmente?
No. La tarjeta oficial indica Apache 2.0 para Phonon 31m en inglés, mientras que los modelos multilingües de 40m usan CC BY-NC 4.0, según el artículo de Gradium. Revisa los términos del checkpoint elegido.
Qué significan los números de Phonon para quien desarrolla voz local
El resultado de 28 ms ayuda a identificar un punto fuerte de Phonon en streaming de CPU: comenzar a hablar rápidamente en la configuración evaluada. El marcador también separa esta medida de inteligibilidad, naturalidad y similitud de voz.
Para un equipo de producto, el siguiente paso es reproducir el flujo con tus propias frases, idioma, hardware y requisitos de licencia. El leaderboard sirve como punto de comparación, no como garantía de desempeño en producción.
Del borrador al producto listo: divide el trabajo entre agentes especialistas y acompaña cada etapa en bridgecode.
Fuente: Hugging Face
Tags:#Phonon TTS#text-to-speech#Open TTS Leaderboard#síntese de fala#IA no dispositivo
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados

Benchmarks
RoleRouteBench: lo que el enrutamiento revela en sistemas multiagente
RoleRouteBench es un entorno reproducible para evaluar el enrutamiento dinámico de roles en tareas de múltiples etapas. Consulta los resultados de JEV 1.13 en los cuatro dominios.
6 min

Benchmarks
CloudOpsBench: agentes de IA en operaciones en la nube
CloudOpsBench mide cómo los agentes de IA ejecutan tareas reales de operación en la nube. El mejor agente resuelve el 60,6% de las 45 tareas en AWS. Mira los números.
7 min

Benchmarks
SuperCLUE noviembre 2026: líderes diferentes por categoría
SuperCLUE publicó en noviembre de 2026 la tabla con 19 modelos y líderes diferentes en cada categoría. El ranking dividido es más útil como mapa de shortlist que como veredicto final.
6 min