
OpenAI presentó BioBasicBench, un benchmark enfocado en tareas de biología ejecutadas por agentes de inteligencia artificial. El objetivo es medir, de forma estandarizada, qué tan bien los agentes comprenden, planean y ejecutan pasos en escenarios que exigen dominio de términos científicos, interpretación de resultados y elección de herramientas. El conjunto fue creado para probar no solo el conocimiento de memoria, sino la capacidad de actuar en un flujo más cercano al laboratorio.
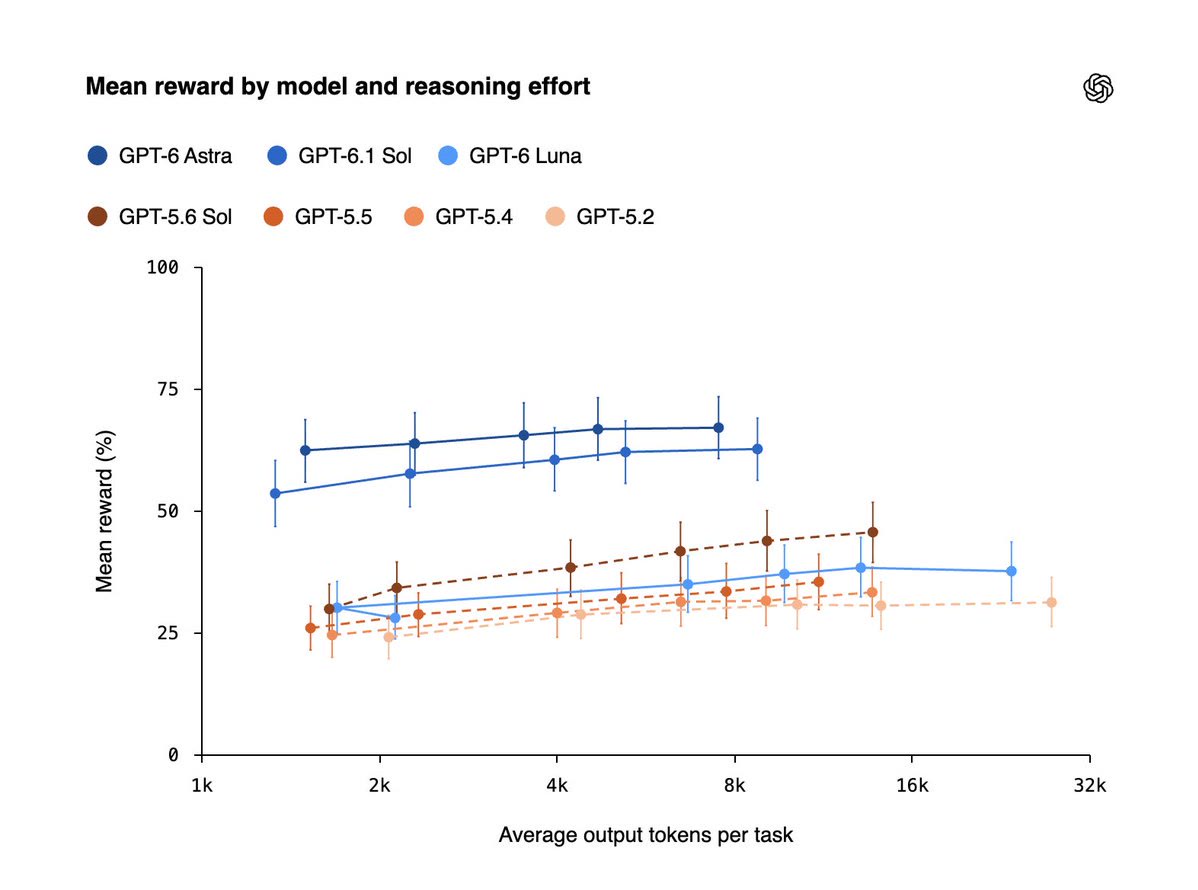
OpenAI presenta BioBasicBench: test de biología con IA
OpenAI lanza BioBasicBench, un conjunto de tareas para medir agentes de IA en escenarios de biología. Qué evalúa el benchmark y cómo se posiciona frente a los conjuntos existentes.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
Lo que evalúa el benchmark son habilidades centrales para el uso de IA en ciencias biológicas: interpretación de descripciones, selección de métodos, aplicación de condiciones a distintos contextos y verificación de salidas intermedias. La evaluación se realiza mediante tareas que implican toma de decisiones y consecuencias verificables, de modo a reproducir partes del proceso de trabajo que no se reduce al acierto de una única respuesta. El conjunto también incluye etapas de racionalización, donde el agente debe explicar por qué eligió un método en lugar de otro.
El movimiento responde a una necesidad del mercado: los benchmarks de modelos abstractos no logran capturar el desempeño de sistemas que deben operar en un dominio especializado, con lenguaje técnico, restricciones y ciclos de validación. BioBasicBench intenta cubrir esa brecha al proponer un entorno enfocado en biología, con criterios de evaluación definidos y resultados comparables entre agentes. La estandarización es esencial para que investigadores e ingenieros puedan comparar sistemas de forma justa.
Es importante no interpretar el resultado como una nota final. Los benchmarks miden desempeño en condiciones controladas, y el valor práctico depende de cómo se comporta el agente fuera de esas condiciones, con datos nuevos, protocolos diferentes y revisiones humanas. El conjunto no sustituye la validación experimental en un laboratorio. Un buen resultado en un benchmark no garantiza que el agente será útil en todos los contextos biológicos, especialmente aquellos que implican procesos complejos o datos ruidosos.
Para quien sigue el área, el lanzamiento refuerza una tendencia: la convergencia entre agentes de código, modelos especializados y tareas de dominio. El próximo paso está en evaluar en qué medida el agente equilibra velocidad, precisión y comprensión del contexto biológico. En un mundo donde la información ya no es el cuello de botella, la capacidad de ejecutar con precisión se vuelve el diferencial.
El flujo recomendado para que los equipos evalúen el resultado es comenzar con tareas simples, comparar el nivel de precisión de la salida, verificar si el método usado explica el racional y, solo después, expandir a escenarios más complejos con supervisión. El análisis debe considerar no solo la tasa de acierto, sino también el tiempo de ejecución, el costo computacional y la calidad de las explicaciones proporcionadas por el agente.
Cada ejecución de agente genera un reporte de salida que puede inspeccionarse por tarea, permitiendo ver dónde el modelo acertó, dónde falló y qué información usó para decidir la próxima acción. La transparencia de esa cadena es uno de los diferenciales del conjunto, pues no se limita a una nota global, sino que muestra el desempeño en partes del proceso.
Para ponerlo en contexto, la publicación cwe-bench-v2: método, ranking y límites describe cómo se construye un benchmark, qué métricas usa y cuáles son las limitaciones de los resultados publicados, lo que ayuda a leer BioBasicBench con más precisión. Además, el artículo FeatureLoop: benchmark revela fallas de agentes con requisitos en evolución muestra cómo se comportan los agentes con requisitos en cambio, un escenario que BioBasicBench también puede cubrir al incluir variación en los protocolos.
El estudio de escenarios en los que el agente debe adaptarse a nuevos datos o protocolos es particularmente relevante para la práctica. En los laboratorios, los métodos cambian con frecuencia, y un agente que solo ejecuta patrones fijos puede fallar en situaciones reales. BioBasicBench, al incluir variación en los protocolos, se acerca a lo que ocurre en el día a día de quienes trabajan con ciencias biológicas. La evolución continua de los métodos destaca la importancia de sistemas que aprenden a adaptar las instrucciones a contextos nuevos, manteniendo la trazabilidad de cada decisión.
El estudio de escenarios en los que el agente debe adaptarse a nuevos datos o protocolos es particularmente relevante para la práctica. En los laboratorios, los métodos cambian con frecuencia, y un agente que solo ejecuta patrones fijos puede fallar en situaciones reales. BioBasicBench, al incluir variación en los protocolos, se acerca a lo que ocurre en el día a día de quienes trabajan con ciencias biológicas. La evolución continua de los métodos destaca la importancia de sistemas que aprenden a adaptar las instrucciones a contextos nuevos, manteniendo la trazabilidad de cada decisión.
La evolución de los benchmarks refleja un cambio de enfoque en el ecosistema de IA: de modelos que responden preguntas a sistemas que ejecutan tareas. En lugar de puntuar la capacidad de un modelo para parafrasear conocimiento, BioBasicBench evalúa si logra planificar, ejecutar y validar un proceso. Esta transición es esencial para quienes buscan herramientas que operen en entornos reales, con ambigüedad, datos incompletos y múltiples criterios de calidad.
El próximo desafío para los creadores de agentes es conectar el desempeño del benchmark con escenarios reales, donde los datos no siempre están limpios y los protocolos pueden cambiar en cualquier momento. Los modelos que obtienen una buena puntuación en pruebas cerradas necesitan demostrar que mantienen la precisión cuando el entorno es imprevisto, lo que exige monitoreo continuo, revisión humana e informe transparente de limitaciones. BioBasicBench, al incluir etapas de razonamiento, ayuda a evaluar no solo el resultado final, sino también el proceso completo, una característica esencial para quienes utilizan sistemas en contextos críticos.
Preguntas frecuentes sobre el BioBasicBench de OpenAI
¿Qué mide BioBasicBench?
La capacidad de los agentes de IA en tareas de biología, con foco en la interpretación, la planificación de métodos y la verificación de salidas, no solo en el acierto de respuestas.
¿El resultado del benchmark sustituye las pruebas de laboratorio?
No. Evalúa el desempeño en condiciones controladas; la validación experimental sigue siendo necesaria para decisiones de experimentos reales.
¿Qué criterios usa el benchmark?
Tareas que implican interpretación de descripciones, selección de métodos, aplicación de condiciones y verificación de salidas intermedias.
¿Para quién es útil BioBasicBench?
Para equipos que evalúan agentes de código en dominio técnico, investigadores y quienes comparan capacidades de agentes en tareas especializadas.
¿Cómo empezar a evaluar el resultado de un agente con este benchmark?
Comienza con tareas simples, compara la precisión de la salida, inspecciona el razonamiento del método aplicado y expande gradualmente las complejidades.
Tags:#radar#ia
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Benchmarks
Co-Design Bench: los agentes de código aciertan el 26% de las tareas reales
Investigadores crearon un benchmark de agentes de código basado en pedidos reales de usuarios. Incluso el mejor modelo completa solo el 26,4% de las tareas. Mira los números.
7 min

Benchmarks
PLE: benchmark de ingeniería física para agentes de IA
Google Cloud lanzó el Physical-Engineering Last Exam, un benchmark de 85 tareas de ingeniería física. Todos los modelos marcaron menos del 50%. Mira los números.
7 min

Benchmarks
VIALS-AA: benchmark de razonamiento sobre imágenes científicas
Artificial Analysis lanzó VIALS-AA, implementación del benchmark VIALS de Handshake AI, que prueba si los modelos interpretan imágenes científicas y responden sobre las evidencias.
4 min