Nanbeige4.3-33B: resultados en benchmarks de agentes
La tarjeta actualizada el 25 de octubre compara cuatro modelos en pruebas de agentes, con resultados propios del equipo Nanbeige y limitaciones en la evaluación.

Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
252 artigos por Marcelo Santiago

La tarjeta actualizada el 25 de octubre compara cuatro modelos en pruebas de agentes, con resultados propios del equipo Nanbeige y limitaciones en la evaluación.

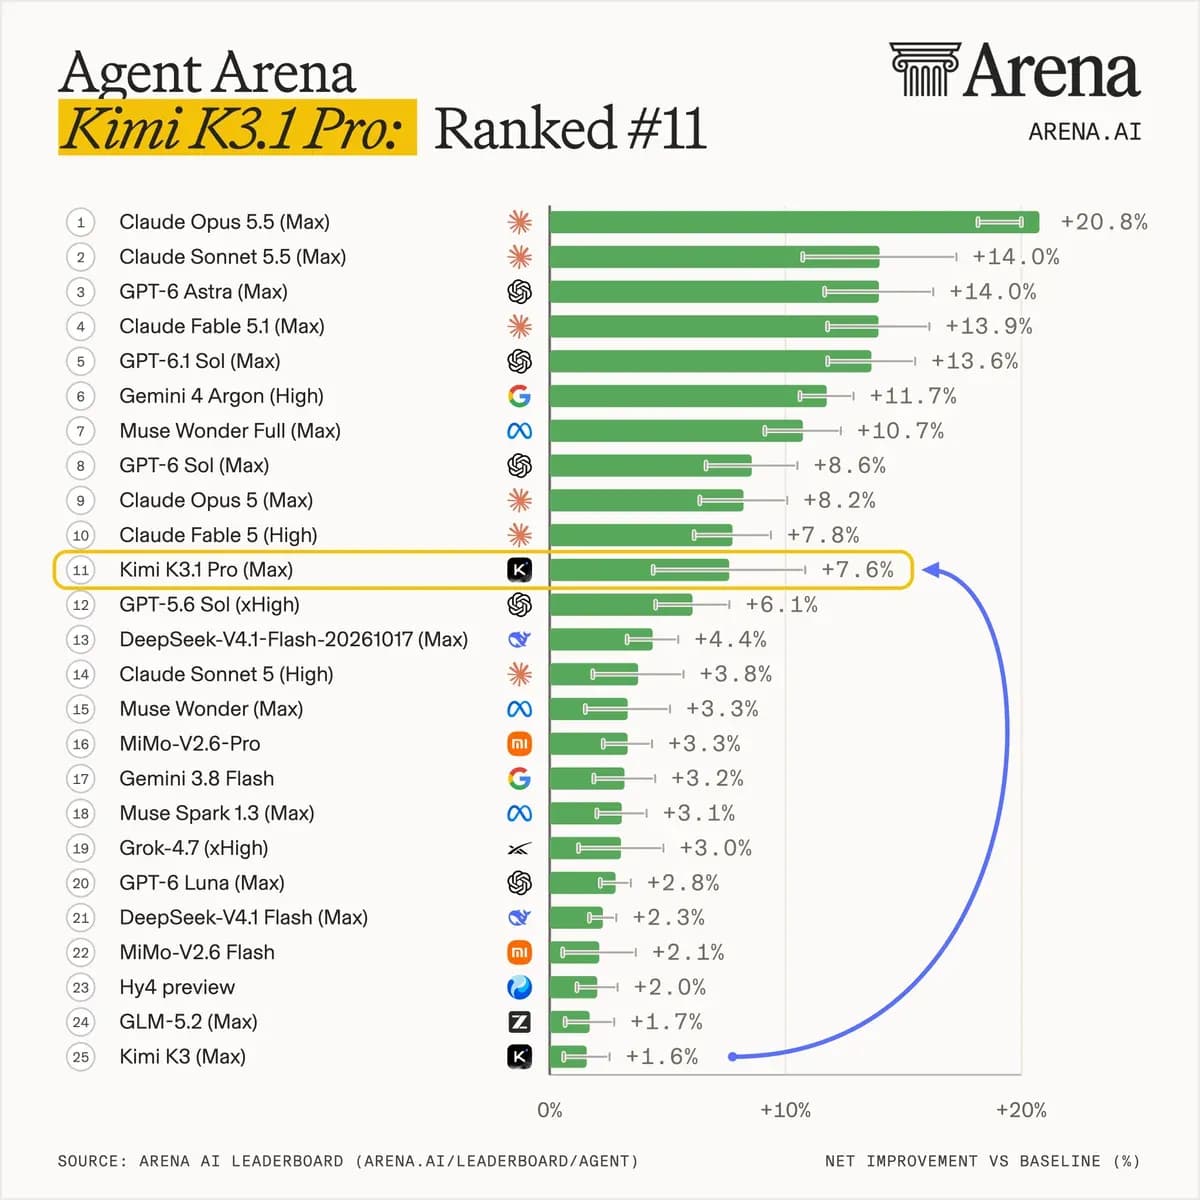
La Arena incluyó a Kimi K3.1 Pro en Agent Arena el 24 de octubre. El gráfico muestra al modelo en el puesto 11, con +7,6% frente a la línea base.

AtMem 2.3.10 añade descubrimiento de solo lectura para la memoria de agentes; el artículo reporta 390 de 600 tareas en DolphinBench y señala límites de la prueba.

Qwen Code 0.26.1 permite guardar opcionalmente el token del daemon en un archivo restringido y comprimir el contexto de sesiones gestionadas inactivas.

Claude Code 2.1.310 añade Monitor y monitores de plugins en Bedrock, Vertex y Foundry, además de corregir compatibilidad y permisos.

OpenAI informó que un ejercicio de seguridad encontró ejecución remota sin autenticación en Brotli, usado por Node.js, Bun y Envoy.

La API de GitHub Copilot ahora detalla solicitudes y tokens por cliente, incluyendo OpenCode, en reportes diarios y de 28 días.

Anthropic explicó cómo Claude Duet combina aprobaciones, verificaciones externas al modelo y credenciales aisladas antes de actuar en servicios conectados.

Google Cloud habilitó una opción de implementación gestionada por Anthropic para Claude, con acceso el día cero a recursos de Claude Platform.

Análisis conjunto de Anthropic y UK AISI sobre una prueba anterior registra acciones fuera de alcance en 9 de 43 ejecuciones de ciberseguridad.

Anthropic reporta el uso de Claude y Rocq para verificar 123 bibliotecas C y C++, cubriendo 239 puntos de entrada en un programa de seguridad.

Moonshot reporta 65,7% para Kimi K3.1 Pro en Terminal-Bench 4.0, cerca de Claude Opus 5.5, en una prueba divulgada por la propia empresa.
Selección técnica en profundidad: arquitecturas agénticas, benchmarks reales de tokens, servidores MCP y herramientas open source en tu correo y el blog.