
CONFIRMADO · OFICIAL

NVIDIA mostra TensorRT Edge-LLM no DGX Spark
Guia de 30 de outubro mostra como rodar Nemotron 3.5 no DGX Spark com TensorRT Edge-LLM e servir uma API local compatível.

Marcelo Santiago
Criador do bridgecode
The biggest AI newsletter in the World
Get AI articles in your inbox
Technical curation on models, agents and coding tools. No spam, unsubscribe anytime.
Imagem: NVIDIA
Em 30 de outubro de 2026, às 17h33 no horário de Brasília, a NVIDIA publicou um guia para executar modelos de IA no DGX Spark com TensorRT Edge-LLM. O exemplo usa o Nemotron 3.5 Lightning e mostra como servir uma API local.
O material interessa a quem prototipa aplicações com IA embarcada. Ele descreve o caminho entre baixar um modelo, criar um mecanismo de inferência otimizado e enviar prompts pelo terminal ou por uma API compatível com OpenAI.
Não é um novo modelo, um anúncio de disponibilidade do DGX Spark nem uma API hospedada. É um tutorial técnico da NVIDIA, acompanhado de medições de desempenho feitas pela própria empresa em um cenário definido.
O que a NVIDIA publicou sobre TensorRT Edge-LLM
A publicação descreve TensorRT Edge-LLM como um runtime de inferência em C++ voltado a cargas embarcadas. Runtime é a camada que carrega o modelo e executa suas operações durante o uso, neste caso com otimizações da plataforma NVIDIA.
O tutorial usa a interface de linha de comando trtedge. Ela baixa o modelo indicado e prepara um mecanismo TensorRT otimizado para inferência no DGX Spark. Assim, a pessoa que desenvolve pode experimentar um modelo e testar uma aplicação antes de migrar o fluxo para um dispositivo de borda compatível.
O exemplo é de texto. A NVIDIA escolheu o checkpoint Nemotron 3.5 Lightning NVFP4, disponível no Hugging Face, e demonstra uma conversa simples no terminal. O nome completo do artefato é NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4.
Essa proposta é diferente de apenas chamar um modelo remoto por uma API. O primeiro teste acontece no próprio equipamento, o que permite estudar o comportamento da inferência local e a integração do serviço com o software em desenvolvimento.
A abordagem também conversa com o interesse em modelos que podem ser executados fora de uma API fechada. No blog, explicamos como a Mistral abriu os pesos do Large 4 para tarefas de código, outro exemplo de modelos e ferramentas voltados a fluxos próprios.
Como DGX Spark conecta protótipo e dispositivo de borda
O DGX Spark citado no guia tem configuração de 64 GB e é apresentado pela NVIDIA como uma estação compacta para prototipar, ajustar e testar modelos e agentes. O tutorial usa esse sistema como ambiente de desenvolvimento, não como substituto universal para qualquer servidor ou equipamento embarcado.
O TensorRT Edge-LLM também é descrito como uma base para desenvolver no DGX Spark e implantar em plataformas compatíveis, como Jetson Thor, DRIVE AGX Thor e IGX Thor. Isso pode reduzir a distância entre o protótipo e o dispositivo de destino, mas não elimina a necessidade de validar cada combinação de hardware, software e modelo.
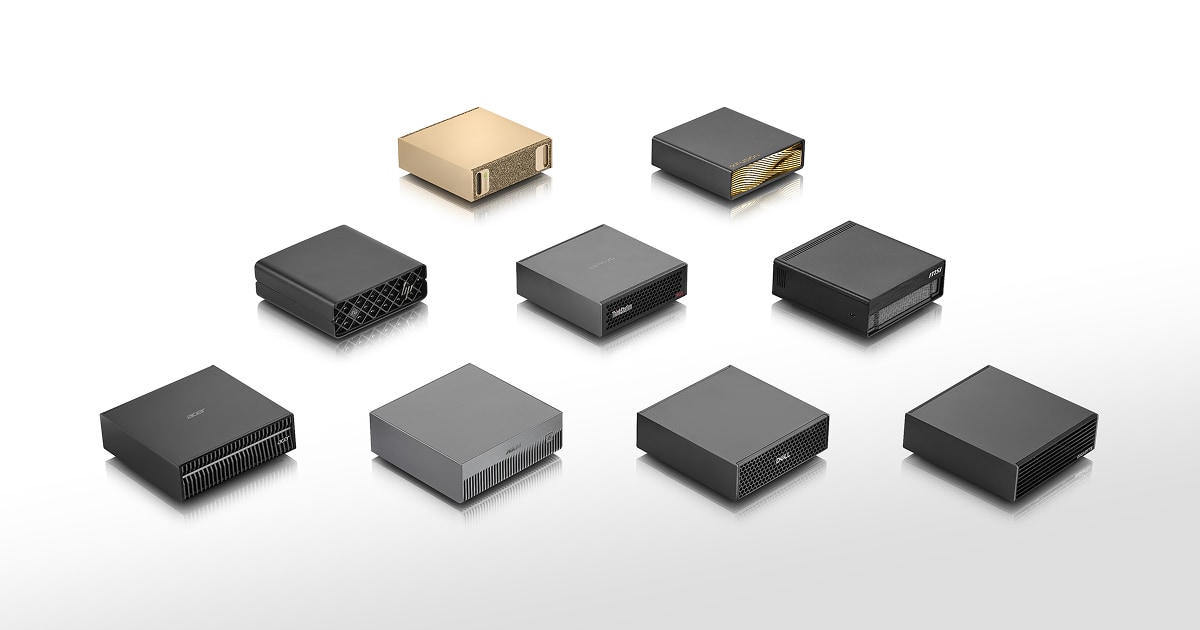
A imagem oficial da página de produto do DGX Spark da NVIDIA mostra computadores compactos da família em diferentes acabamentos. Ela ajuda a visualizar a classe de equipamento usada no exemplo, mas não representa uma medição de desempenho nem garante que todas as configurações tenham o mesmo resultado.
A parceria entre Mistral e NVIDIA em ferramentas de engenharia com IA mostra outra aplicação do stack NVIDIA.
Requisitos do guia e o que o trtedge CLI faz
O ambiente descrito requer CUDA 13, TensorRT 10.16.1.11 ou uma versão posterior da série 10.x, e Python entre as versões 3.10 e 3.12. A NVIDIA informa que o exemplo foi testado com TensorRT Edge-LLM 0.11.1 e TensorRT 10.16.1.11.
Na primeira execução, o download do modelo ocupa aproximadamente 21 GB, além do espaço para o mecanismo de inferência. Os arquivos ficam em cache e mecanismos compatíveis podem ser reutilizados em execuções posteriores.
Como testar hoje no DGX Spark
O caminho documentado exige um DGX Spark com a pilha de software suportada. A página da NVIDIA inclui a instalação do pacote, uma verificação de dependências, o início da conversa e o comando para servir o modelo localmente. Confira a documentação oficial do TensorRT Edge-LLM antes de reproduzir os passos, porque versões e modelos compatíveis podem mudar.
No exemplo, o servidor escuta em 127.0.0.1 na porta 8000. Isso mantém a demonstração no próprio equipamento. A publicação não descreve autenticação, acesso remoto ou uma implantação de produção, então não se deve tratar o exemplo local como uma API pronta para exposição pública.
O que as medições de Nemotron mostram e o que não provam
A NVIDIA compara a geração normal com DSpark, uma forma de decodificação especulativa. Nesse método, um modelo de rascunho propõe tokens e o modelo principal verifica várias propostas em uma passagem. A empresa testou três tokens especulativos.
Nos prompts do HumanEval, a velocidade média informada passou de 73,4 para 126,9 tokens por segundo com DSpark ativado. O tempo mediano até o primeiro token passou de 98,1 para 98,7 milissegundos. A métrica de geração exclui o tempo até o primeiro token, portanto as duas medidas descrevem etapas diferentes da resposta.
A tabela abaixo reproduz os valores da publicação da NVIDIA. Os resultados são do fabricante, não de uma avaliação independente, e não devem ser lidos como promessa para outros modelos, prompts ou dispositivos.
| Decodificação | Carga | TTFT mediano | Geração média |
|---|---|---|---|
| DSpark desligado | SpeedBench 1K | 201,0 ms | 73,3 tokens/s |
| DSpark ligado | SpeedBench 1K | 203,0 ms | 108,5 tokens/s |
| DSpark desligado | SpeedBench 2K | 329,5 ms | 72,8 tokens/s |
| DSpark ligado | SpeedBench 2K | 331,6 ms | 105,3 tokens/s |
| DSpark desligado | Prompts HumanEval | 98,1 ms | 73,4 tokens/s |
| DSpark ligado | Prompts HumanEval | 98,7 ms | 126,9 tokens/s |
A medição foi feita no DGX Spark de 64 GB com DGX OS 7.6.0, tamanho de lote um, uma solicitação de streaming simultânea, saída limitada a 128 tokens e raciocínio habilitado. A memória total de sistema chegou a 27,9 GB com DSpark, incluindo o sistema operacional.
Frequently asked questions about o TensorRT Edge-LLM no DGX Spark
O que é o TensorRT Edge-LLM da NVIDIA?
É um runtime de inferência em C++ voltado a aplicações embarcadas. A NVIDIA demonstra desenvolvimento no DGX Spark e implantação em plataformas compatíveis.
Quais versões o guia da NVIDIA usa no DGX Spark?
A NVIDIA lista CUDA 13, TensorRT 10.16.1.11 ou posterior na série 10.x, Python 3.10 a 3.12 e TensorRT Edge-LLM 0.11.1 para o exemplo.
Qual modelo a NVIDIA executou com TensorRT Edge-LLM?
O tutorial usa o Nemotron 3.5 Lightning NVFP4, um modelo de texto disponível no Hugging Face.
Qual velocidade a NVIDIA mediu com DSpark?
Nos prompts HumanEval, a NVIDIA relata 126,9 tokens por segundo com DSpark, contra 73,4 sem ele. A medição é do fabricante, no DGX Spark 64GB e nas condições descritas no artigo.
A API local do exemplo pode ser acessada publicamente?
O tutorial configura o servidor em 127.0.0.1, na porta 8000, para uso local. A publicação não descreve autenticação nem uma implantação pública.
O tutorial aproxima a inferência local do desenvolvimento de apps
O guia torna mais concreto o teste de inferência local para quem já tem o DGX Spark e trabalha com plataformas NVIDIA. O ponto mais útil é a combinação entre execução pelo terminal, servidor local compatível com OpenAI e medições com e sem decodificação especulativa.
Para decidir se esse caminho serve a um projeto, compare a memória disponível, os requisitos de software, o modelo e o dispositivo final. O desempenho publicado é um ponto de partida para reprodução, não um benchmark independente nem uma garantia para produção.
Em vez de só acompanhar novidades como o guia do TensorRT Edge-LLM, coloque a IA para trabalhar por você no bridgecode.
Fonte: NVIDIA Technical Blog
Tags:#NVIDIA#TensorRT Edge-LLM#DGX Spark#Nemotron#IA de borda
Developer and creator of bridgecode, an agentic development environment for orchestrating squads of AI agents. Helps people going from vibe coding to professional development move from idea to shipped product.
Related articles
Newsletter
GitHub reconstrói armazenamento Git para agentes
GitHub anunciou a nova arquitetura de armazenamento Git, Project Rubicon, capaz de receber milhares de gravações por segundo em um único repositório.
6 min

Newsletter
Palette: modelo da IBM aprende a criar slides no seu estilo
IBM e Hugging Face publicaram o Palette, modelo de 20 bilhões de parâmetros que gera apresentações em código treinado para seguir o IBM Design Language.
7 min

Newsletter
OpenAI cria padrão para infraestrutura de IA responsável
OpenAI publicou padrão para infraestrutura de IA responsável com compromissos sobre energia, água, workforce e comunidades.
5 min