
llm-d 1.0 no Kubernetes é uma stack de serving distribuído para modelos de linguagem, não um modelo nem um comando único.

Dicas5 min
5 dicas para usar llm-d 1.0 no Kubernetes
Use llm-d 1.0 no Kubernetes com cinco verificações de arquitetura, desempenho, tenants, observabilidade e atualização segura.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
O guia oficial saiu em 20 de outubro de 2026. Em 31 de outubro, a tag mais recente no repositório oficial era v1.0.0.
A release estabiliza a API de configuração em v1 e destaca qualidade de serviço para múltiplos tenants e operações sem indisponibilidade.
O anúncio também lista serving ciente de agentes. Essas capacidades tornam importante planejar a operação, não só subir os containers.
O que o llm-d 1.0 muda na operação de modelos no Kubernetes
O llm-d coordena componentes para servir inferência distribuída em Kubernetes. A ideia é escalar e direcionar o trabalho de geração entre réplicas, aceleradores e fases diferentes do processamento.
A versão 1.0 não é um novo modelo de linguagem. O projeto descreve uma API de configuração v1, qualidade de serviço (QoS) para vários tenants e atualizações sem indisponibilidade.
A release também lista serving agent-aware, voltado a cargas de trabalho que envolvem agentes.
O termo Day 2 descreve o que acontece depois da implantação inicial: acompanhar a saúde do serviço, ajustar capacidade, atender diferentes prioridades e atualizar componentes sem interromper o uso.
5 dicas para usar llm-d 1.0 no Kubernetes
Dica 1: defina o workload antes de escolher a topologia
Registre tamanho médio e máximo dos prompts, tokens de saída, picos de concorrência e variação entre tenants. Um modelo usado em geração curta tem necessidades diferentes de um que recebe contexto longo.
Defina também um objetivo de serviço. Para conversas interativas, meça o tempo até o primeiro token; para processamento em lote, observe a vazão total e o tempo de conclusão.
Dica 2: separe prefill e decode quando o perfil justificar
Prefill processa os tokens de entrada e prepara o contexto. Decode gera a resposta token por token. Em uma arquitetura disaggregated, as duas fases podem escalar em grupos distintos.
O repositório do projeto publica um gráfico 2P/2D de vazão.
A figura compara Sidecar e Coordinator, duas estratégias de agendamento, em concorrências 300, 360 e 420.
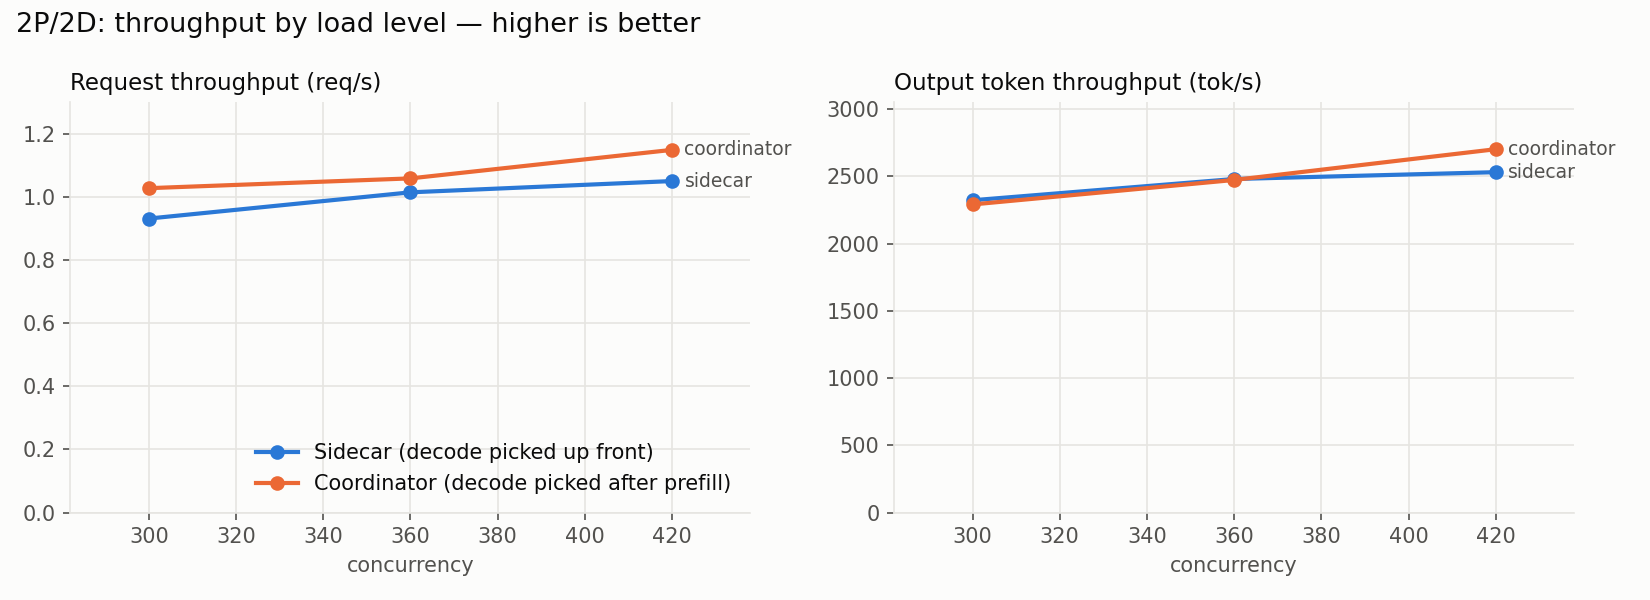
No nível 420, a curva do Coordinator fica perto de 1,15 requisições por segundo e 2.700 tokens de saída por segundo. A curva do Sidecar fica perto de 1,05 requisições e 2.500 tokens por segundo.
Esses números são leituras aproximadas de um benchmark específico do projeto. Use o gráfico para aprender quais métricas comparar, não como promessa de desempenho no seu cluster ou com outro modelo.
Dica 3: mantenha versão e API de configuração alinhadas
Na verificação de 31 de outubro de 2026, o repositório oficial mostrava v1.0.0 como a tag mais recente. A publicação da release informa que a API de configuração chegou à versão estável v1.
Escolha a tag e a documentação correspondentes antes de instalar. Evite copiar exemplos da branch principal sem conferir se os campos existem na versão usada pelo seu cluster.
Dica 4: configure QoS antes de dividir o cluster entre equipes
A qualidade de serviço multi-tenant da versão 1.0 equilibra prioridades quando vários tenants, ou equipes e serviços, compartilham a infraestrutura.
Antes de ativá-la, defina quais workloads podem esperar e quais precisam de baixa latência.
Separe métricas por tenant e teste rajadas de tráfego, não apenas a média. Assim fica mais fácil detectar quando uma fila de uma equipe está prejudicando outra ou ocupando aceleradores sem entregar a vazão esperada.
Dica 5: ensaie atualizações e rollback em uma carga realista
O projeto destaca operações sem indisponibilidade na versão 1.0, mas cada ambiente tem dependências próprias. Teste uma atualização com tráfego representativo e verifique a disponibilidade do modelo, a fila e o tempo até o primeiro token.
Defina antes como voltar para a versão anterior e quais sinais interrompem o rollout.
Inclua serving agent-aware se o sistema executar tarefas de agentes. Fluxos encadeados podem pressionar filas de maneira diferente de um pedido simples.
Como comparar llm-d com outras formas de servir inferência
O llm-d prioriza distribuição e operação no Kubernetes.
Para uma implantação local em hardware compacto, veja o guia da NVIDIA sobre inferência local, que cobre outra escala de infraestrutura.
Se a carga inclui agentes que escrevem software, combine observabilidade de serving com revisão do trabalho feito por eles.
O guia para dividir e revisar tarefas de agentes explica esse fluxo do lado do projeto.
Nenhuma topologia vence em todo workload. Compare as mesmas entradas, o mesmo modelo e as mesmas métricas; depois repita o teste com concorrência e proporções de prompt e resposta que representem o uso real.
Preguntas frecuentes sobre o llm-d 1.0 no Kubernetes
O que é llm-d 1.0?
llm-d 1.0 é uma stack de serving distribuído para modelos de linguagem em Kubernetes. A release destaca uma API de configuração v1, QoS multi-tenant, atualizações sem indisponibilidade e serving agent-aware.
Qual é a versão atual do llm-d?
Na verificação de 31 de outubro de 2026, a tag mais recente no repositório oficial era v1.0.0. Confira o repositório antes de iniciar uma implantação nova.
O que significam prefill e decode no serving de LLMs?
Prefill processa os tokens do prompt e prepara o contexto. Decode gera a resposta token por token; separar as fases permite escalar seus grupos de forma independente quando o workload justificar.
O que mostra o benchmark 2P/2D do llm-d?
O gráfico compara vazão de requisições e tokens de saída para Sidecar e Coordinator em três níveis de concorrência. O resultado é específico daquele teste e não garante a mesma performance em outro cluster.
O benchmark 2P/2D garante o mesmo desempenho no meu cluster?
Não. Ele descreve um caso específico do projeto. Meça o seu modelo, hardware, prompt, concorrência e requisitos de latência antes de escolher uma topologia.
llm-d 1.0 exige medir o serviço depois da implantação
A versão 1.0 reúne recursos voltados à produção, mas não escolhe a arquitetura pelo operador. A topologia depende do perfil de tráfego, das prioridades entre tenants e das metas de latência.
Comece com um workload delimitado, acompanhe vazão e tempo até o primeiro token, e só então aumente a concorrência. Isso transforma a configuração em uma hipótese que pode ser medida, revisada e revertida.
Você define o objetivo e os agentes dividem as tarefas: um planeja, outro executa, outro revisa. Veja como funciona a orquestração no bridgecode.
Fonte: llm-d
Tags:#llm-d#Kubernetes#inferência distribuída#prefill#decode#QoS
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados

Dicas
Como testar agentes de IA em operações de nuvem com CloudOpsBench
O CloudOpsBench libera 45 tarefas de operação em nuvem para testar seu agente de IA. Veja como clonar, validar e rodar contra emulador ou AWS real.
6 min
Dicas
Hy4 da Tencent: 1M de contexto, visão e tool calling
Hy4 da Tencent traz 1 milhão de tokens de contexto, visão e tool calling nativo para agentes de código e tarefas de longa duração.
5 min
Dicas
5 dicas para operar desktop com agent-desktop
O Vercel Labs lançou o agent-desktop, ferramenta que permite a agentes de IA operar aplicativos de desktop via árvore de acessibilidade. Veja como funciona.
6 min