
Em 3 de novembro de 2026, o Allen Institute for AI apresentou o StateBench, uma avaliação para medir se modelos acompanham mudanças de estado ao longo de sequências extensas.

StateBench mede rastreamento de estado em contexto longo
StateBench mede quatro níveis de rastreamento de estado e mostra como a precisão cai em sequências longas, com método e limites explícitos.

Marcelo Santiago
Criador do bridgecode
The biggest AI newsletter in the World
Get AI articles in your inbox
Technical curation on models, agents and coding tools. No spam, unsubscribe anytime.
O resultado não é um ranking geral: ele isola uma habilidade que também aparece quando código atualiza variáveis. O artigo do Ai2 publica o método, os resultados e as limitações.
O que o StateBench mede em sequências longas
Rastreamento de estado é manter o valor atual de entidades que mudam ao longo de um texto. Em código, isso pode ser acompanhar o valor de uma variável após várias atribuições, em vez de copiar apenas a primeira ou a última ocorrência.
O StateBench separa quatro níveis. No nível R-trivial, um valor não muda. No aperiodic, há reatribuições e importa encontrar a última. No soluble, cada atualização depende do valor anterior, como somar pontos a um placar.
O nível general finite acrescenta atribuição por referência. Uma variável pode receber o valor atual de outra, o que cria uma cadeia de dependências entre atualizações.
Para um programador, isso se parece com reatribuir variáveis ou trocar seus valores em várias etapas.
Os autores mantêm iguais o número de variáveis, os valores distintos e os pontos da sequência em que ocorrem as atribuições.
O que muda entre tarefas comparáveis é o tipo de atualização. Isso ajuda a isolar a dificuldade que o benchmark pretende medir.
O artigo relaciona a hierarquia a distinções teóricas da teoria de Krohn e Rhodes.
Não é preciso dominar essa teoria para entender o uso prático do conjunto. Ela explica por que os autores não tratam todas as mudanças de estado como um único problema.
Como o Ai2 montou as comparações
O artigo testa modelos pré-treinados com tamanhos e arquiteturas diferentes, entre eles OLMo 3 e OLMo Hybrid, ambos com 7 bilhões de parâmetros, além de modelos menores.
Os modelos de partida foram treinados com o mesmo conjunto de dados descrito pela equipe.
Nenhum desses modelos pré-treinados tinha visto contextos acima de 64 mil tokens durante o treinamento, segundo os autores.
A avaliação então observa o comportamento em sequências de entrada mais longas e em diferentes níveis de rastreamento.
Em outra experiência, a equipe treinou do zero modelos de 275 milhões de parâmetros em sequências de até 256 atribuições. Depois, avaliou sequências de até 64 mil atribuições.
Esse teste é 250 vezes maior que o comprimento máximo usado no treino, medido em atribuições, não em tokens.
O relatório técnico, o conjunto de dados e o código estão públicos. Isso permite que pesquisadores inspecionem os exemplos e a implementação.
Essa transparência não transforma automaticamente os resultados em uma medida de desempenho em aplicações reais. Consulte também o conjunto de dados e o código.
O que os resultados mostram sobre modelos de fronteira
Na avaliação dos autores, Gemini 3.8 Flash, Claude Opus 5.5, GPT-6 Sol e GPT-6 Luna tiveram bom desempenho nos dois níveis mais simples. A precisão caiu quando as tarefas exigiram acumular atualizações ou seguir referências entre variáveis.
Nos problemas general finite mais longos, a equipe relata acurácia de 13% ou menos para os quatro modelos. Essa afirmação se aplica ao nível mais difícil e às sequências mais longas do teste, não a todo tipo de pergunta ou uso dos modelos.
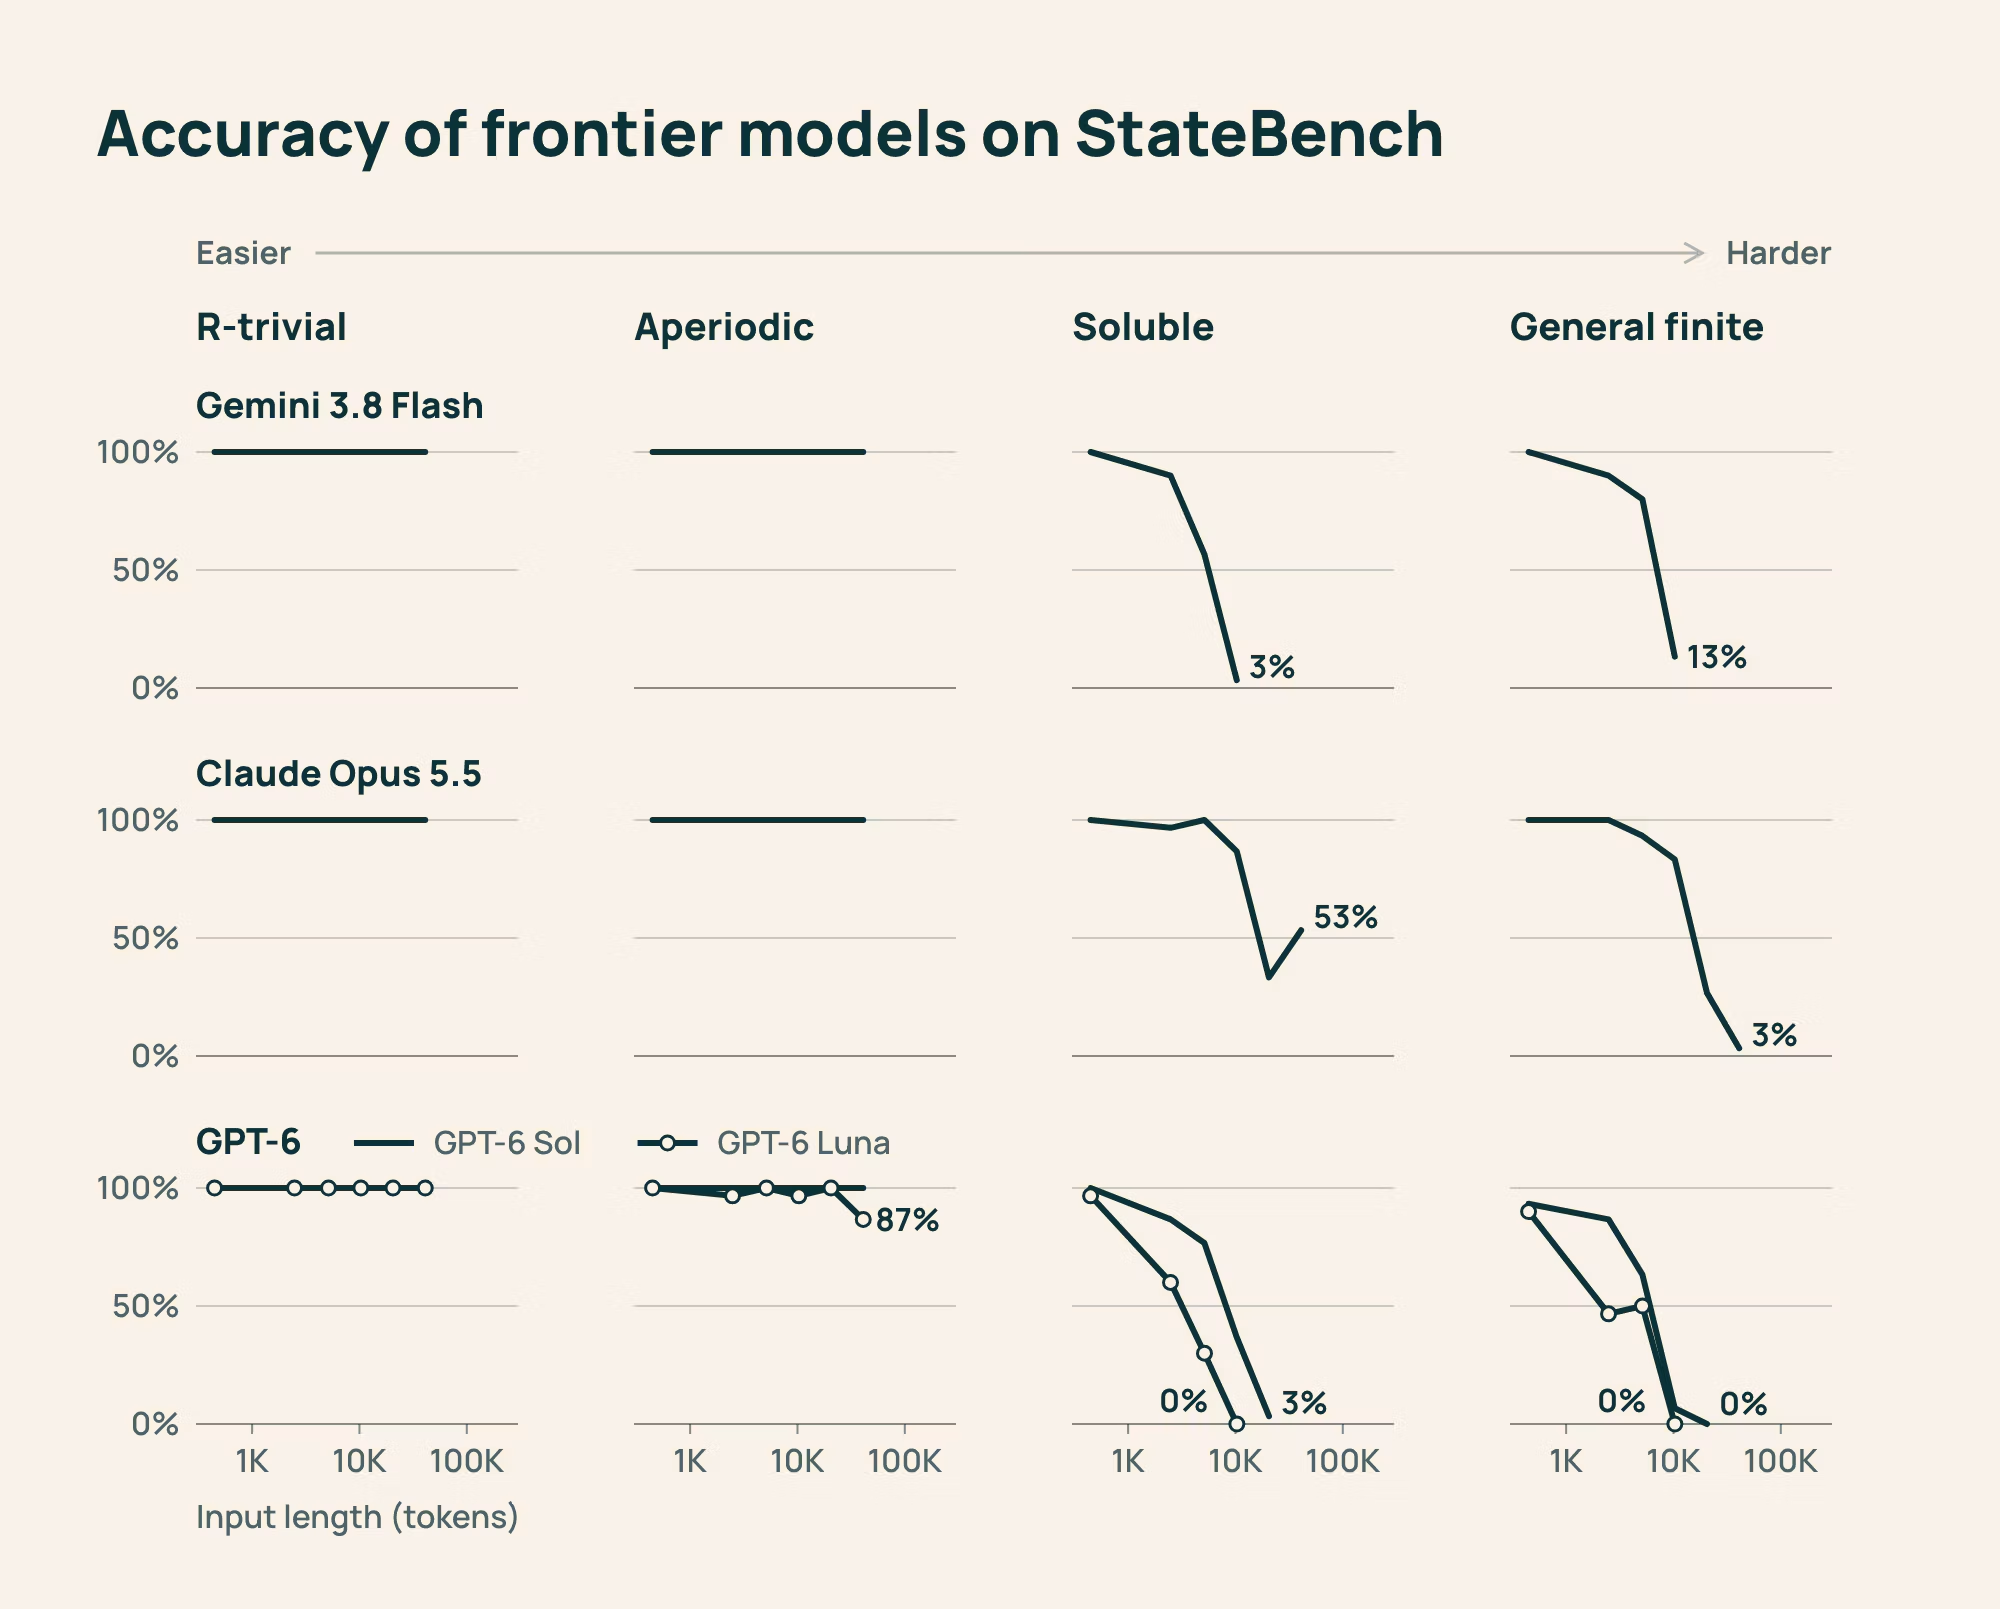
Crédito da imagem: Ai2.
Nos modelos treinados diretamente na tarefa, os híbridos e as variantes Gated DeltaNet generalizaram melhor que os Transformers em alguns níveis.
Uma variante Gated DeltaNet manteve desempenho próximo do teto em tarefas mais simples e, no nível mais difícil, foi além do comprimento visto no treino.
Isso não significa que uma arquitetura vence em todo cenário. O próprio estudo observa que os modelos pré-treinados e os modelos treinados do zero estão em condições diferentes.
Os resultados também dependem da forma específica de atualização testada.
Limites que impedem tratar o StateBench como ranking geral
As sequências são controladas e mantêm fixo o conjunto de variáveis.
Em conversas, documentos ou repositórios reais, novas pessoas, objetos e símbolos podem surgir no meio do contexto. O artigo diz que o benchmark ainda não cobre essa situação.
A tarefa também não mede qualidade de código, uso de ferramentas, recuperação de informação nem resolução geral de problemas.
Um resultado baixo em general finite aponta uma fragilidade naquele teste, não prova que o modelo seja incapaz de acompanhar qualquer estado em qualquer aplicação.
Os resultados dos modelos de fronteira são os modelos e configurações avaliados no artigo.
Não os trate como um placar universal ou como uma tabela atual de todos os sistemas disponíveis. O objetivo principal é comparar tipos de rastreamento de estado sob condições controladas.
Há perguntas abertas sobre a posição exata de algumas arquiteturas na hierarquia teórica e sobre o efeito de precisão numérica e camadas de atenção.
O relatório descreve essas questões como trabalho em aberto, não como conclusões resolvidas.
Para comparar com outro tipo de avaliação, veja o artigo do blog sobre DeepSeek V4.1 Flash no CursorBench.
CursorBench avalia tarefas de programação; StateBench isola atualizações de estado. A categoria de benchmarks reúne análises com outros métodos e escopos.
Como usar o StateBench para orientar uma avaliação própria
Se sua aplicação depende de contexto longo, transforme falhas reportadas em casos de teste próximos ao seu fluxo.
Inclua atualizações simples, cadeias acumulativas e referências entre variáveis, em vez de medir apenas o tamanho máximo da janela.
Use as mesmas entradas, instruções e regras de correção ao comparar versões. Registre quais casos falharam e por quê.
Um benchmark sintético ajuda a localizar uma capacidade específica, mas precisa ser complementado por exemplos reais e seguros do seu produto.
Para comparar esse recorte de memória de estado com outra avaliação específica de agentes, veja o FeatureLoop e os testes com requisitos que evoluem. Os dois estudos observam problemas diferentes e não devem ser combinados em um ranking único.
Frequently asked questions about o StateBench
O que o StateBench mede?
O StateBench mede como modelos acompanham atualizações de variáveis em quatro níveis de dificuldade, de valores que nunca mudam a dependências entre variáveis.
O que significa general finite no StateBench?
General finite inclui atribuições por referência, em que o valor atual de uma variável depende do valor de outra e de mudanças anteriores.
Qual foi a acurácia dos modelos nos testes mais difíceis?
O Ai2 relata 13% ou menos nos problemas general finite mais longos para os quatro modelos de fronteira testados. Esse resultado não representa todas as tarefas desses modelos.
O StateBench prova que Transformers não conseguem acompanhar estados?
Não. O benchmark usa sequências controladas com um número fixo de variáveis e não cobre todos os contextos reais, como conversas em que novas entidades aparecem.
O que significa o teste de 250 vezes mais longo?
Não. O fator de 250 vezes compara comprimentos de sequência medidos em atribuições: os modelos foram treinados até 256 e avaliados até 64 mil atribuições.
O StateBench destaca a diferença entre contexto e memória de estado
O principal mérito do StateBench é separar tarefas que parecem semelhantes, mas exigem operações diferentes. O tamanho da janela de contexto não garante, sozinho, que um modelo acompanhe toda cadeia de mudanças.
Para escolher um sistema, combine essa leitura com testes do trabalho que ele realmente fará. Não transforme uma pontuação isolada em promessa de desempenho para código, documentos ou conversas de produção.
Em vez de só acompanhar benchmarks como o StateBench, divida seu projeto entre agentes e coordene o fluxo no bridgecode.
Fonte: Ai2
Tags:#StateBench#Ai2#benchmark#contexto longo#rastreamento de estado#Gated DeltaNet
Developer and creator of bridgecode, an agentic development environment for orchestrating squads of AI agents. Helps people going from vibe coding to professional development move from idea to shipped product.
Related articles

Benchmarks
ToyBlocks: benchmark controlado para robôs
AI2 apresenta ToyBlocks, um ambiente de simulação com quatro tarefas para estudar generalização e transferência física em robótica.
5 min

Benchmarks
RoleRouteBench: o que o roteamento revela em multi-agentes
RoleRouteBench é um ambiente reproduzível para avaliar roteamento dinâmico de papéis em tarefas multi-etapa. Veja os resultados do JEV 1.13 nos quatro domínios.
6 min

Benchmarks
CloudOpsBench: agentes de IA em operações de nuvem
O CloudOpsBench mede como agentes de IA executam tarefas reais de operação em nuvem. O melhor agente resolve 60,6% das 45 tarefas na AWS. Veja os números.
7 min