
O Google Cloud e a Mercor lançaram em 6 de novembro de 2026 o Physical-Engineering's Last Exam (PLE), um benchmark de 85 tarefas longas que mede a capacidade de agentes de IA em projetar sistemas de engenharia física. O resultado: todos os modelos de fronteira marcaram menos de 50% no conjunto de teste privado, e o melhor agente passou em apenas 41,3% das verificações de segurança.

PLE: benchmark de engenharia física para agentes de IA
O Google Cloud lançou o Physical-Engineering Last Exam, benchmark de 85 tarefas de engenharia física. Todos os modelos marcaram menos de 50%. Veja os números.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
O PLE fecha uma lacuna que existia na avaliação de agentes. Benchmarks acadêmicos testam perguntas de múltipla escolha ou problemas pequenos e autocontidos. A engenharia física exige produzir designs seguros, em conformidade com códigos e custo-efetivos, sob revisão de um engenheiro licenciado. Nenhum benchmark anterior testava isso de ponta a ponta.
O que é o PLE
O Physical-Engineering's Last Exam tem 85 tarefas longas em quatro disciplinas: mecânica (30 tarefas), elétrica (27), civil (18) e estrutural (10). As tarefas envolvem arquivos de projeto realistas, regras de segurança rígidas e custos de material. O agente deve produzir um design que passe em todas as verificações de segurança e viabilidade antes de receber qualquer pontuação.
O benchmark foi desenvolvido em colaboração com a Mercor e está disponível como competição aberta. O conjunto público tem 29 tarefas com ferramentas de graduação e container de avaliação. O conjunto privado de teste tem 85 tarefas e é usado para o leaderboard.
Por que benchmarks acadêmicos não servem
Modelos de fronteira já marcam acima de 90% em muitos benchmarks acadêmicos. Mas esses benchmarks testam perguntas de estilo livro, chamadas únicas de ferramenta ou problemas de design pequenos e autocontidos. Para engenheiros que constroem agentes de IA para engenharia física, não mostram se o agente pode produzir designs seguros, em conformidade com códigos e custo-efetivos.
O PLE fecha essa lacuna. Os agentes só ganham pontos se o design passar em todas as verificações de segurança rígidas primeiro. Isso significa que um agente pode satisfazer 91% das restrições individuais em tarefas coautoradas, mas apenas 41,3% dos entregáveis passam em todas as verificações de segurança e viabilidade.
Números oficiais do PLE
Resultados no conjunto de teste privado (85 tarefas):
- Todos os modelos de fronteira marcaram menos de 50%.
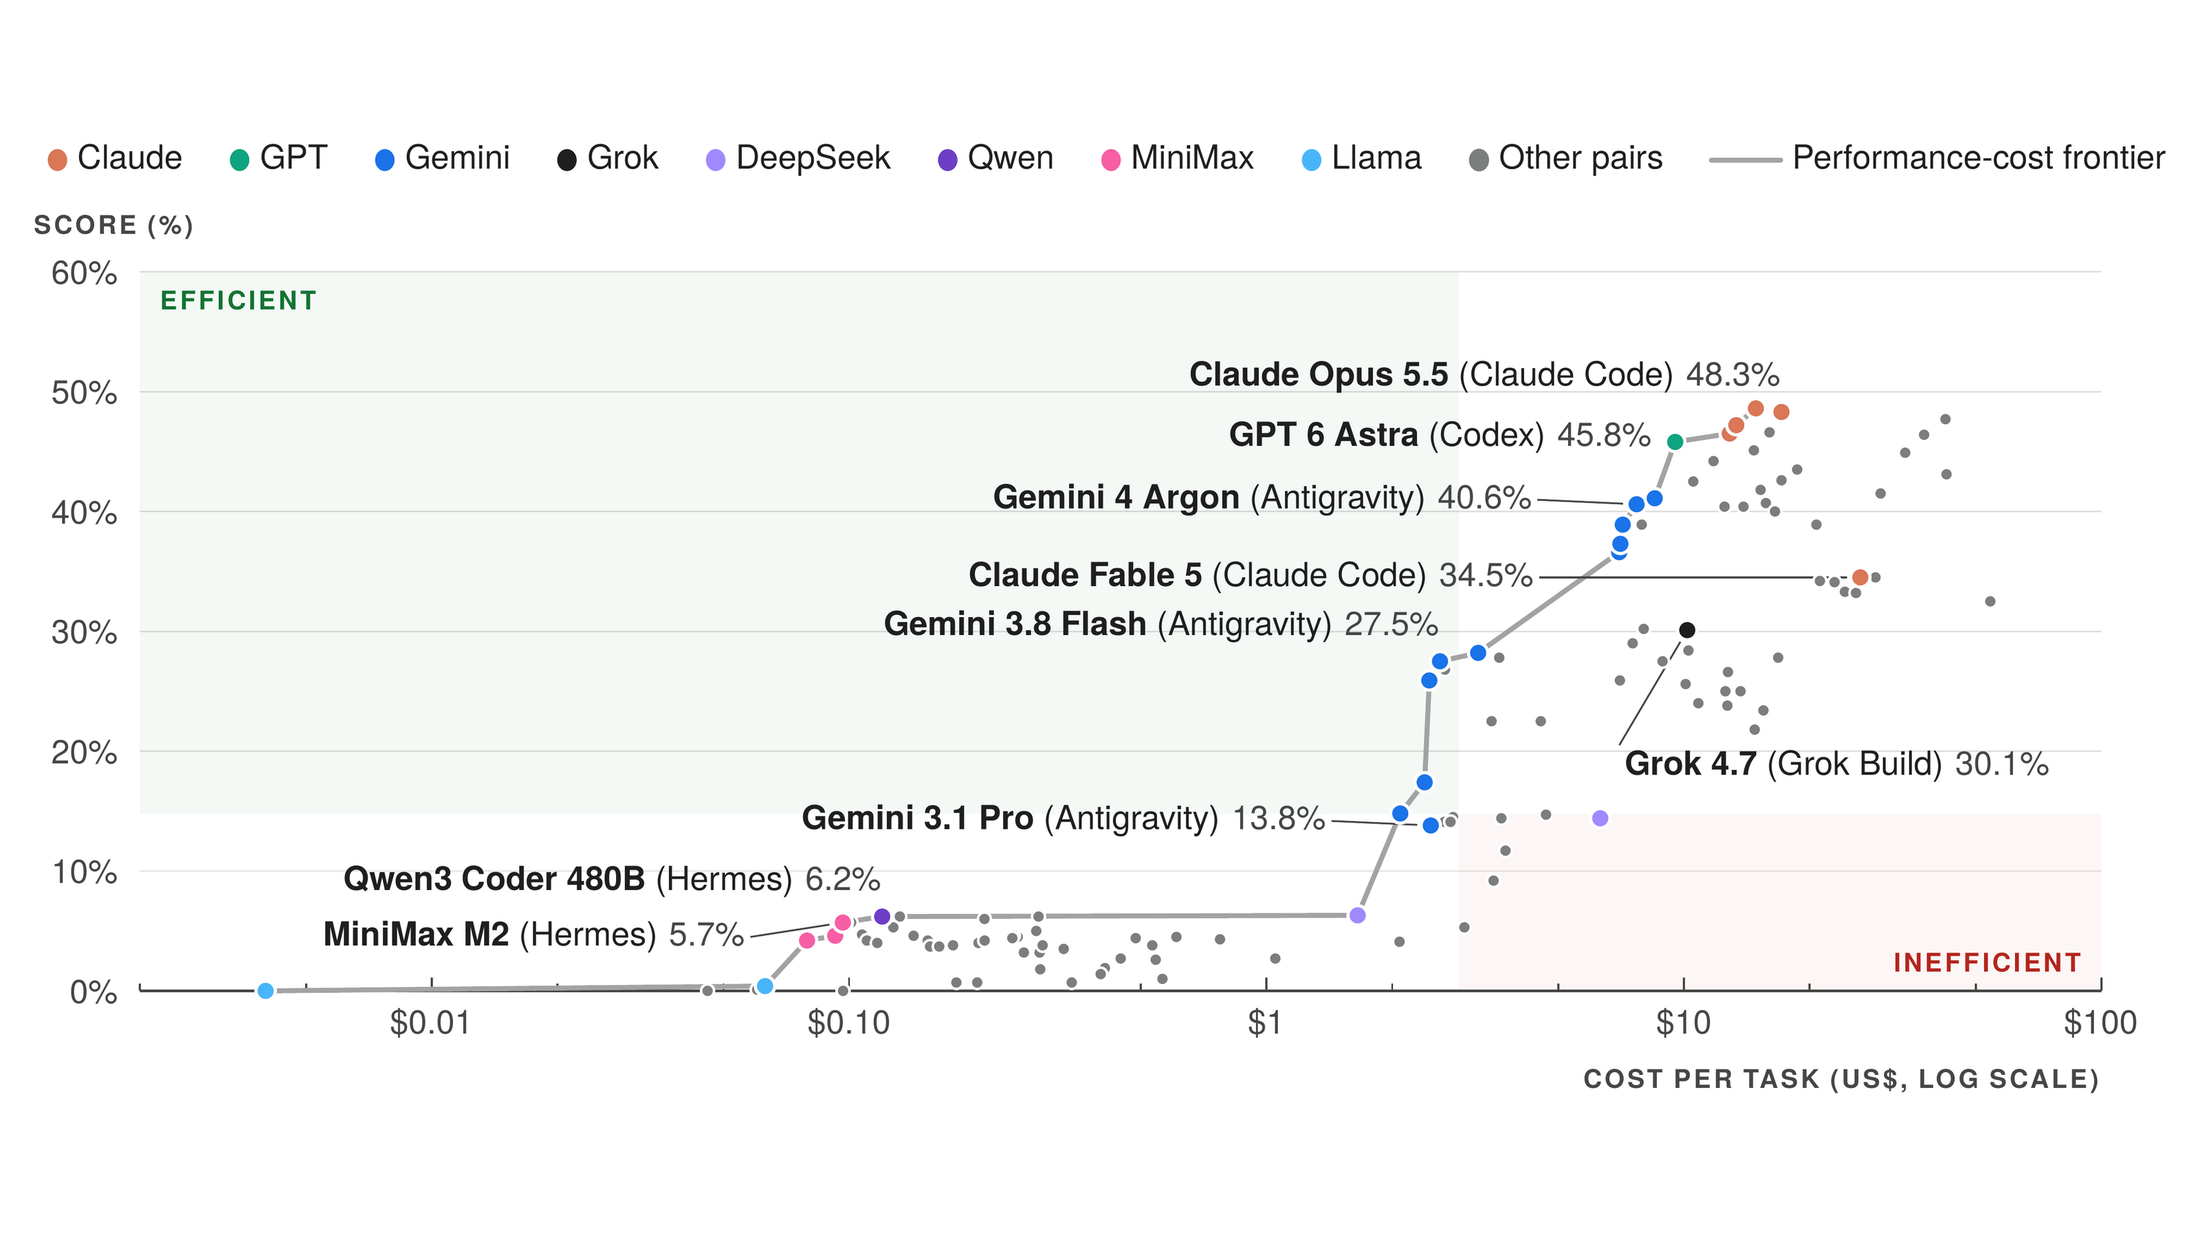
- O melhor agente (modelo nativo no seu harness) alcançou 48,3% de pontuação média.
- 91% das restrições individuais foram satisfeitas pelo melhor agente em tarefas coautoradas.
- Apenas 41,3% dos entregáveis passaram em todas as verificações de segurança e viabilidade.
Modelo versus harness
A escolha do modelo impulsiona o desempenho muito mais do que o harness. A diferença entre modelos foi de até 50 pontos, enquanto a diferença mediana entre harnesses para o mesmo modelo foi de apenas 3 pontos. Os harnesses afetam significativamente o custo de execução, mas não a pontuação final.
Foram testados 14 modelos de fronteira usando 7 harnesses públicos: Antigravity, Claude Code, Codex, Hermes, OpenCode, OpenHands e Pi. O benchmark avalia tanto conformidade com códigos quanto eficiência de custo.
Onde os agentes falham
Segurança: apenas 41,3% dos entregáveis passam em todas as verificações de segurança. Mesmo o melhor agente, que satisfaz 91% das restrições individuais, falha em mais da metade dos entregáveis completos. Isso significa que os agentes produzem designs que parecem corretos em partes, mas não são seguros como um todo.
Custo: os harnesses afetam significativamente o custo de execução. Um agente que pontua alto pode custar muito mais do que um agente que pontua ligeiramente mais baixo, tornando a escolha do harness uma decisão de engenharia, não apenas de desempenho.
Conformidade com códigos: os designs devem atender a códigos de construção, normas elétricas e regulamentos estruturais. Os agentes falham em aplicar essas regras de forma consistente, especialmente quando múltiplas restrições interagem.
Como testar hoje
Se você trabalha com agentes de IA para engenharia física, o PLE é um bom ponto de partida para entender as limitações atuais. Acesse o site ple-bench.com para baixar as 29 tarefas públicas, scripts de graduação e container de avaliação. Você pode trazer sua própria configuração de agente e submetê-la para avaliação no conjunto de teste privado.
Para outros domínios, procure benchmarks que usem arquivos de projeto realistas, regras de segurança rígidas e avaliação de ponta a ponta. Evite benchmarks que testam apenas perguntas de múltipla escolha ou problemas pequenos.
Perguntas frequentes sobre o PLE
O que é o PLE? É um benchmark de 85 tarefas longas que mede a capacidade de agentes de IA em projetar sistemas de engenharia física, desenvolvido pelo Google Cloud em colaboração com a Mercor.
Quantas tarefas e disciplinas tem? 85 tarefas em quatro disciplinas: mecânica (30), elétrica (27), civil (18) e estrutural (10).
Qual foi o melhor resultado? O melhor agente alcançou 48,3% de pontuação média no conjunto de teste privado, com 91% de restrições individuais satisfeitas mas apenas 41,3% de entregáveis aprovados.
Por que o modelo importa mais do que o harness? A diferença entre modelos foi de até 50 pontos, enquanto a diferença mediana entre harnesses para o mesmo modelo foi de apenas 3 pontos.
O que é o conjunto público? 29 tarefas com ferramentas de graduação e container de avaliação, disponíveis para download no GitHub.
Pontuações mais altas significam designs seguros? Não. O melhor agente satisfaz 91% das restrições individuais mas apenas 41,3% dos entregáveis passam em todas as verificações de segurança.
Conclusão
O PLE mostra que agentes de IA ainda estão longe de produzir designs de engenharia física seguros e em conformidade com códigos. A pontuação de 48,3% do melhor agente é um ponto de partida, não um resultado satisfatório. Os 41,3% de entregáveis aprovados mostram que a maioria dos designs falha em segurança.
Ao avaliar agentes de IA para engenharia física, não se contente com pontuações agregadas. Verifique as verificações de segurança, a conformidade com códigos e o custo de execução. Um agente bom não é apenas o que pontua mais alto, mas o que produz designs seguros e custo-efetivos.
CTA
PLE chamou sua atenção? Coloque essa novidade pra trabalhar num squad de agentes de IA, cada um no seu papel.
GPT-5.1 lidera tau2-Bench Airline com 80%
CWE-bench v2: método, ranking e limites
Fonte: Google Cloud
Preguntas frecuentes sobre o PLE (Physical-Engineering Last Exam)
O que é o PLE?
É um benchmark de 85 tarefas longas que mede a capacidade de agentes de IA em projetar sistemas de engenharia física, desenvolvido pelo Google Cloud em colaboração com a Mercor.
Quantas tarefas e disciplinas tem?
85 tarefas em quatro disciplinas: mecânica (30), elétrica (27), civil (18) e estrutural (10).
Qual foi o melhor resultado?
O melhor agente alcançou 48,3% de pontuação média no conjunto de teste privado, com 91% de restrições individuais satisfeitas mas apenas 41,3% de entregáveis aprovados.
Por que o modelo importa mais do que o harness?
A diferença entre modelos foi de até 50 pontos, enquanto a diferença mediana entre harnesses para o mesmo modelo foi de apenas 3 pontos.
Pontuações mais altas significam designs seguros?
Não. O melhor agente satisfaz 91% das restrições individuais mas apenas 41,3% dos entregáveis passam em todas as verificações de segurança.
Tags:#radar#ia
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Benchmarks
Co-Design Bench: agentes de código acertam 26% das tarefas reais
Pesquisadores criaram um benchmark de agentes de código baseado em pedidos reais de usuários. Mesmo o melhor modelo completa apenas 26,4% das tarefas. Veja os números.
7 min

Benchmarks
VIALS-AA: benchmark de raciocínio sobre imagens científicas
Artificial Analysis lançou o VIALS-AA, implementação do benchmark VIALS da Handshake AI, que testa se modelos interpretam imagens científicas e respondem sobre as evidências.
4 min

Benchmarks
Inkling 2 Small: benchmark mostra força em tarefas empresariais
Thinking Machines Lab anunciou o Inkling 2 Small com 594 bilhões de parâmetros e 17 bilhões ativos. O modelo marcou 71,8% no EnterpriseBench-CoreCraft e 46,8% no EnterpriseOps-Gym.
5 min