
CONFIRMADO · OFICIAL

NVIDIA presenta TensorRT Edge-LLM en DGX Spark
Guía del 30 de octubre muestra cómo ejecutar Nemotron 3.5 en DGX Spark con TensorRT Edge-LLM y servir una API local compatible.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
Imagen: NVIDIA
El 30 de octubre de 2026, a las 17:33 hora de Brasilia, NVIDIA publicó una guía para ejecutar modelos de IA en DGX Spark con TensorRT Edge-LLM. El ejemplo usa Nemotron 3.5 Lightning y muestra cómo poner en marcha una API local.
El material interesa a quien prototipa aplicaciones con IA embebida. Describe el camino entre descargar un modelo, crear un mecanismo de inferencia optimizado y enviar prompts por la terminal o por una API compatible con OpenAI.
No es un nuevo modelo, un anuncio de disponibilidad de DGX Spark ni una API hospedada. Es un tutorial técnico de NVIDIA, acompañado de mediciones de desempeño hechas por la propia empresa en un escenario definido.
En este artículo verás:
- El papel de TensorRT Edge-LLM y de DGX Spark en el flujo
- Las versiones y dependencias citadas por NVIDIA
- Lo que el ejemplo hace con Nemotron 3.5 Lightning
- Cómo interpretar la medición de velocidad sin generalizar demasiado
Lo que NVIDIA publicó sobre TensorRT Edge-LLM
La publicación describe TensorRT Edge-LLM como un runtime de inferencia en C++ orientado a cargas embebidas. Runtime es la capa que carga el modelo y ejecuta sus operaciones durante el uso, en este caso con optimizaciones de la plataforma NVIDIA.
El tutorial usa la interfaz de línea de comandos trtedge. Descarga el modelo indicado y prepara un mecanismo TensorRT optimizado para inferencia en DGX Spark. Así, la persona que desarrolla puede probar un modelo y testear una aplicación antes de migrar el flujo a un dispositivo de borde compatible.
El ejemplo es de texto. NVIDIA eligió el checkpoint Nemotron 3.5 Lightning NVFP4, disponible en Hugging Face, y demuestra una conversación simple en la terminal. El nombre completo del artefacto es NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4.
Esta propuesta es diferente a solo llamar a un modelo remoto por una API. La primera prueba ocurre en el propio equipo, lo que permite estudiar el comportamiento de la inferencia local y la integración del servicio con el software en desarrollo.
El enfoque también conversa con el interés en modelos que se pueden ejecutar fuera de una API cerrada. En el blog, explicamos cómo Mistral abrió los pesos de Large 4 para tareas de código, otro ejemplo de modelos y herramientas orientados a flujos propios.
Cómo DGX Spark conecta prototipo y dispositivo de borde
El DGX Spark citado en la guía tiene configuración de 64 GB y es presentado por NVIDIA como una estación compacta para prototipar, ajustar y probar modelos y agentes. El tutorial usa ese sistema como ambiente de desarrollo, no como sustituto universal para cualquier servidor o equipo embebido.
TensorRT Edge-LLM también se describe como una base para desarrollar en DGX Spark e implementar en plataformas compatibles, como Jetson Thor, DRIVE AGX Thor e IGX Thor. Esto puede reducir la distancia entre el prototipo y el dispositivo de destino, pero no elimina la necesidad de validar cada combinación de hardware, software y modelo.
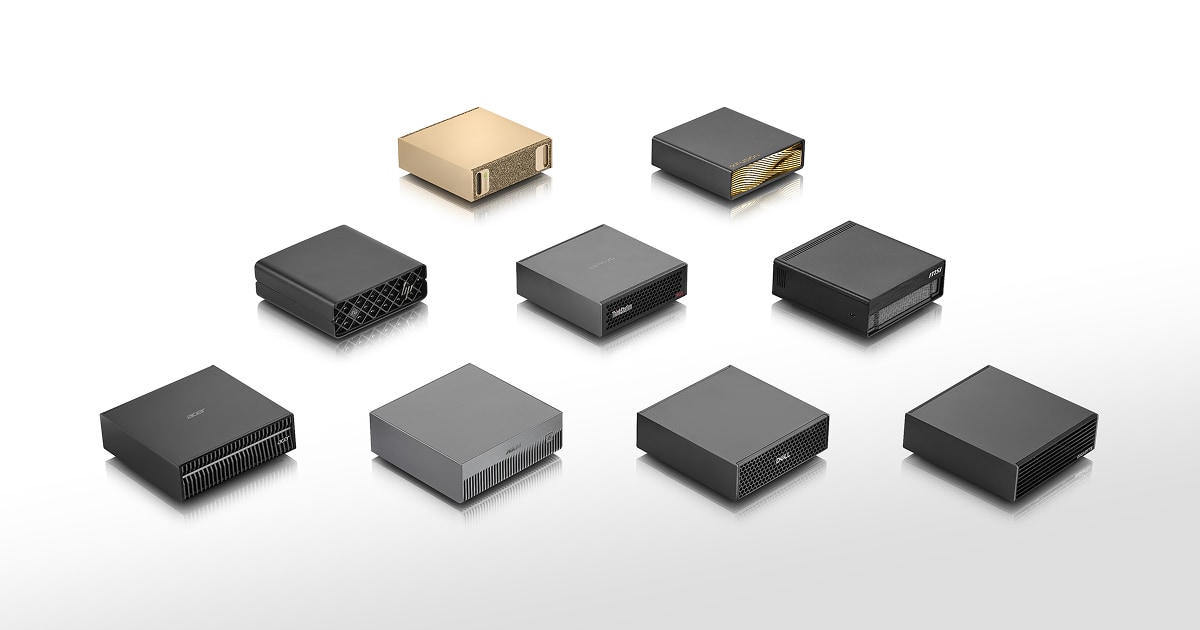
La imagen oficial de la página de producto de DGX Spark de NVIDIA muestra computadoras compactas de la familia en diferentes acabados. Ayuda a visualizar la clase de equipo usada en el ejemplo, pero no representa una medición de desempeño ni garantiza que todas las configuraciones tengan el mismo resultado.
La asociación entre Mistral y NVIDIA en herramientas de ingeniería con IA muestra otra aplicación del stack NVIDIA.
Requisitos de la guía y qué hace el trtedge CLI
El entorno descrito requiere CUDA 13, TensorRT 10.16.1.11 o una versión posterior de la serie 10.x, y Python entre las versiones 3.10 y 3.12. NVIDIA informa que el ejemplo se probó con TensorRT Edge-LLM 0.11.1 y TensorRT 10.16.1.11.
En la primera ejecución, la descarga del modelo ocupa aproximadamente 21 GB, además del espacio para el mecanismo de inferencia. Los archivos quedan en caché y los mecanismos compatibles pueden reutilizarse en ejecuciones posteriores.
Cómo probar hoy en DGX Spark
La ruta documentada exige un DGX Spark con la pila de software soportada. La página de NVIDIA incluye la instalación del paquete, una verificación de dependencias, el inicio de la conversación y el comando para servir el modelo localmente. Revisa la documentación oficial de TensorRT Edge-LLM antes de reproducir los pasos, porque las versiones y los modelos compatibles pueden cambiar.
En el ejemplo, el servidor escucha en 127.0.0.1 en el puerto 8000. Esto mantiene la demostración en el propio equipo. La publicación no describe autenticación, acceso remoto o una implementación de producción, por lo que no se debe tratar el ejemplo local como una API lista para exposición pública.
Qué muestran las mediciones de Nemotron y qué no demuestran
NVIDIA compara la generación normal con DSpark, una forma de decodificación especulativa. En este método, un modelo de borrador propone tokens y el modelo principal verifica varias propuestas en un solo paso. La empresa probó tres tokens especulativos.
En los prompts de HumanEval, la velocidad media informada pasó de 73,4 a 126,9 tokens por segundo con DSpark activado. El tiempo mediano hasta el primer token pasó de 98,1 a 98,7 milisegundos. La métrica de generación excluye el tiempo hasta el primer token, por lo tanto las dos medidas describen etapas diferentes de la respuesta.
La tabla abajo reproduce los valores de la publicación de NVIDIA. Los resultados son del fabricante, no de una evaluación independiente, y no deben leerse como promesa para otros modelos, prompts o dispositivos.
| Decodificación | Carga | TTFT mediano | Generación media |
|---|---|---|---|
| DSpark desactivado | SpeedBench 1K | 201,0 ms | 73,3 tokens/s |
| DSpark activado | SpeedBench 1K | 203,0 ms | 108,5 tokens/s |
| DSpark desactivado | SpeedBench 2K | 329,5 ms | 72,8 tokens/s |
| DSpark activado | SpeedBench 2K | 331,6 ms | 105,3 tokens/s |
| DSpark desactivado | Prompts HumanEval | 98,1 ms | 73,4 tokens/s |
| DSpark activado | Prompts HumanEval | 98,7 ms | 126,9 tokens/s |
La medición se hizo en el DGX Spark de 64 GB con DGX OS 7.6.0, tamaño de lote uno, una solicitud de streaming simultánea, salida limitada a 128 tokens y razonamiento habilitado. La memoria total del sistema llegó a 27,9 GB con DSpark, incluyendo el sistema operativo.
Preguntas frecuentes sobre el TensorRT Edge-LLM en DGX Spark
¿Qué es TensorRT Edge-LLM de NVIDIA?
Es un runtime de inferencia en C++ orientado a aplicaciones embebidas. NVIDIA demuestra desarrollo en DGX Spark e implementación en plataformas compatibles.
¿Qué versiones usa la guía de NVIDIA en DGX Spark?
NVIDIA lista CUDA 13, TensorRT 10.16.1.11 o posterior en la serie 10.x, Python 3.10 a 3.12 y TensorRT Edge-LLM 0.11.1 para el ejemplo.
¿Qué modelo ejecutó NVIDIA con TensorRT Edge-LLM?
El tutorial usa Nemotron 3.5 Lightning NVFP4, un modelo de texto disponible en Hugging Face.
¿Qué velocidad midió NVIDIA con DSpark?
En los prompts de HumanEval, NVIDIA reporta 126,9 tokens por segundo con DSpark, frente a 73,4 sin él. La medición es del fabricante, en DGX Spark 64GB y en las condiciones descritas en el artículo.
¿Se puede acceder públicamente a la API local del ejemplo?
El tutorial configura el servidor en 127.0.0.1, en el puerto 8000, para uso local. La publicación no describe autenticación ni un despliegue público.
El tutorial acerca la inferencia local al desarrollo de apps
La guía hace más concreto el test de inferencia local para quien ya tiene el DGX Spark y trabaja con plataformas NVIDIA. El punto más útil es la combinación entre ejecución por terminal, servidor local compatible con OpenAI y mediciones con y sin decodificación especulativa.
Para decidir si este camino sirve a un proyecto, compara la memoria disponible, los requisitos de software, el modelo y el dispositivo final. El rendimiento publicado es un punto de partida para la reproducción, no un benchmark independiente ni una garantía para producción.
En lugar de solo seguir novedades como la guía de TensorRT Edge-LLM, pon la IA a trabajar por ti en bridgecode.
Fuente: NVIDIA Technical Blog
Tags:#NVIDIA#TensorRT Edge-LLM#DGX Spark#Nemotron#IA de borda
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Newsletter
GitHub reconstruye el almacenamiento Git para agentes
GitHub anunció la nueva arquitectura de almacenamiento Git, Project Rubicon, capaz de recibir miles de escrituras por segundo en un solo repositorio.
6 min

Newsletter
Palette: el modelo de IBM aprende a crear slides con tu estilo
IBM y Hugging Face publicaron Palette, un modelo de 20 mil millones de parámetros que genera presentaciones en código entrenado para seguir el IBM Design Language.
7 min

Newsletter
OpenAI crea un estándar para infraestructura de IA responsable
OpenAI publicó un estándar para infraestructura de IA responsable con compromisos sobre energía, agua, fuerza laboral y comunidades.
5 min